
himalaya-ai/nepali-honorific-bench
收藏搜集汇总
数据集介绍
构建方式
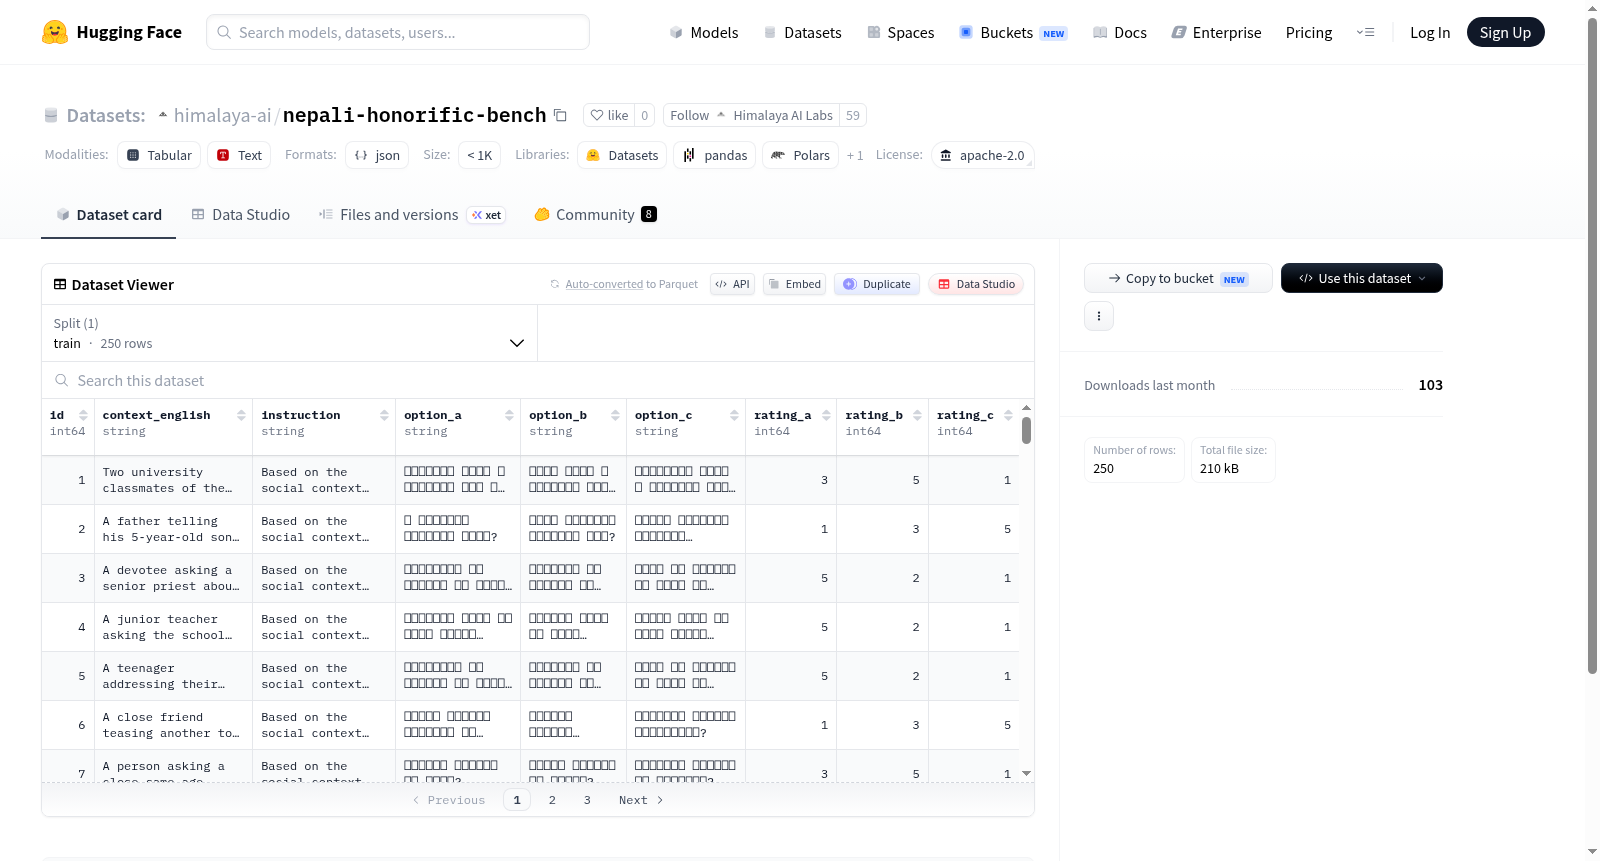
尼泊尔语作为南亚区域的重要语言,其敬语体系在社交沟通中承载着丰富的文化内涵。nepali-honorific-bench数据集专为评估语言模型在尼泊尔语敬语理解上的能力而构建,其构建方式聚焦于涵盖不同敬语层级和语境用法的语料收集,确保了数据在语言学上的代表性与平衡性。
特点
该数据集的核心特色在于其高度聚焦于尼泊尔语敬语这一微妙且关键的语言现象,为研究尼泊尔语计算语言学及社会语言学的语言模型评测提供了专业基准。其数据经过精心筛选与标注,能够有效反映语言模型对敬语语法、词汇及语境适配的真实掌握程度。
使用方法
在使用该数据集时,研究者可将其作为评估基准,对各类预训练语言模型进行尼泊尔语敬语理解任务的测试。通过设计零样本或少样本的评测方案,利用标准化的评估指标衡量模型表现,从而深入分析现有模型在处理尼泊尔语文化敏感语言特征时的优势与不足。
背景与挑战
背景概述
在自然语言处理领域,针对低资源语言(如尼泊尔语)的敬语识别与生成任务长期未得到充分关注。nepali-honorific-bench数据集由相关研究团队创建,旨在弥补尼泊尔语敬语体系在机器学习评测中的空白。该数据集聚焦于尼泊尔语中复杂的敬语等级系统,为模型理解社会文化语境下的语言变体提供标准化基准。其发布对推动多语言NLP模型的公平性评估、促进低资源语言社会语言学研究具有重要价值,尤其为面向尼泊尔语用户的礼貌对话系统开发奠定了基础。
当前挑战
当前面临的核心挑战包括:1)尼泊尔语敬语体系存在微妙的社会层级标记(如基于年龄、地位、亲疏关系的动词变位与代词选择),现有模型难以捕捉隐式的社会语境线索;2)数据集构建过程中,敬语标注需依赖母语者对社交规范的深度理解,导致标注一致性维护困难,且稀缺性数据资源加剧了类别不平衡问题;3)跨域泛化能力不足,即针对正式场合(如新闻语体)训练的模型在非正式对话场景中识别敬语变体的准确率显著下降。
常用场景
经典使用场景
nepali-honorific-bench 数据集专为评估尼泊尔语中的敬语使用能力而设计,广泛应用于自然语言处理中的社会语言学与语用学交叉领域。其最经典的使用场景是作为测试基准,用于衡量语言模型在生成或理解尼泊尔语文本时,能否恰当地根据社交语境(如对话者的年龄、地位或亲疏关系)选用正确的敬语形式。研究者通常利用该数据集进行多轮对话或单句分类任务,验证模型对尼泊尔语文化中尊卑等级表达的敏感度,从而推动多语言模型在低资源语言上的文化适应性研究。
实际应用
在实际应用中,nepali-honorific-bench 的数据可用于优化面向尼泊尔语用户的虚拟助手、客服系统及机器翻译工具。例如,部署于尼泊尔的智能语音助手可通过该数据集微调,在回应长者或上级时自动切换至恭敬措辞,避免因语言失礼引发的用户反感。此外,该数据集还能辅助开发尼泊尔语教育软件,帮助非母语者通过对比正确与错误敬语用例,习得复杂的社交语用规则,从而提升人机交互的社会接受度与商业落地潜力。
衍生相关工作
基于 nepali-honorific-bench,研究者已衍生出多项相关工作。例如,一些工作借鉴其敬语标注框架,构建了针对印地语或孟加拉语等相近南亚语言的尊称语用评测集。另有一些研究将其作为数据增强工具,通过替换敬语词缀生成多样化的训练样本,提升多语言模型在社会角色推理任务中的表现。此外,该数据集还催生了结合知识图谱与语用规则的神经架构,专门用于校正模型输出中的敬语错误,为低资源语言的社会语言感知研究奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


