
CN-GEO Citation Dataset
收藏官方服务:
资源简介:
一个结构化的引用语料库,用于研究中国生成搜索平台的参考选择和信息源暴露。
A structured citation corpus for researching reference selection and information source exposure on Chinese generative search platforms.
创建时间:
2026-07-13
原始信息汇总
数据集概述:CN-GEO Citation Dataset
该数据集是一个结构化的引文语料库,旨在研究中文生成式搜索平台中的参考文献选择与来源曝光。数据集的版本为 2.0.0,许可证为 CC BY 4.0。
核心统计
| 指标 | 数值 |
|---|---|
| 引文记录数 | 214,119 |
| 非空提示ID | 609 |
| 平台代码 | 12 |
| 顶层维度 | 7 |
| 维度/子类别对 | 32 |
| JSONL 分片数 | 64 |
| 最大分片 | 7.31 MiB |
数据组织
记录按照 layer(维度)和 subcat(子类别)分组,每个类别被分割成最多 5,000 条记录的分片。以下是按维度(layer)划分的统计:
| 维度 | 目录 | 记录数 |
|---|---|---|
| 极端与真实场景 | edge-real-world |
68,089 |
| 提问属性 | query-intent |
51,201 |
| 行业维度 | industry |
37,528 |
| 提示风格 | prompt-style |
19,996 |
| 时间敏感度 | time-sensitivity |
18,653 |
| 触发强度 | trigger-intensity |
14,219 |
| 未分类 | uncategorized |
4,433 |
完整的类别到文件映射、记录计数、字节大小和 SHA-256 哈希值可在 data/manifest.json 文件中查看。
记录格式
每条记录都是一个独立的 JSON 对象,经过 schema/record.schema.json 验证。除了原始的 12 个字段外,还增加了两个派生字段:
record_id:稳定的源顺序标识符(例如cngeo-000000001)。record_hash:标准化 12 字段源记录的 SHA-256 哈希值。
字段定义详见 docs/DATA_DICTIONARY.md,示例数据见 examples/sample.jsonl。
数据质量
- 所有 214,119 条源记录均成功解析。
- 重复记录(精确副本)被保留,以维持原始研究总体。
- 缺失值、URL 诊断、重复计数及已知限制已在
docs/QUALITY_REPORT.md中记录。
引用方式
使用该数据集时,请引用 CITATION.cff 中的元数据:
WENDAOstudy. CN-GEO Citation Dataset. Version 2.0.0, 2026.
项目地址
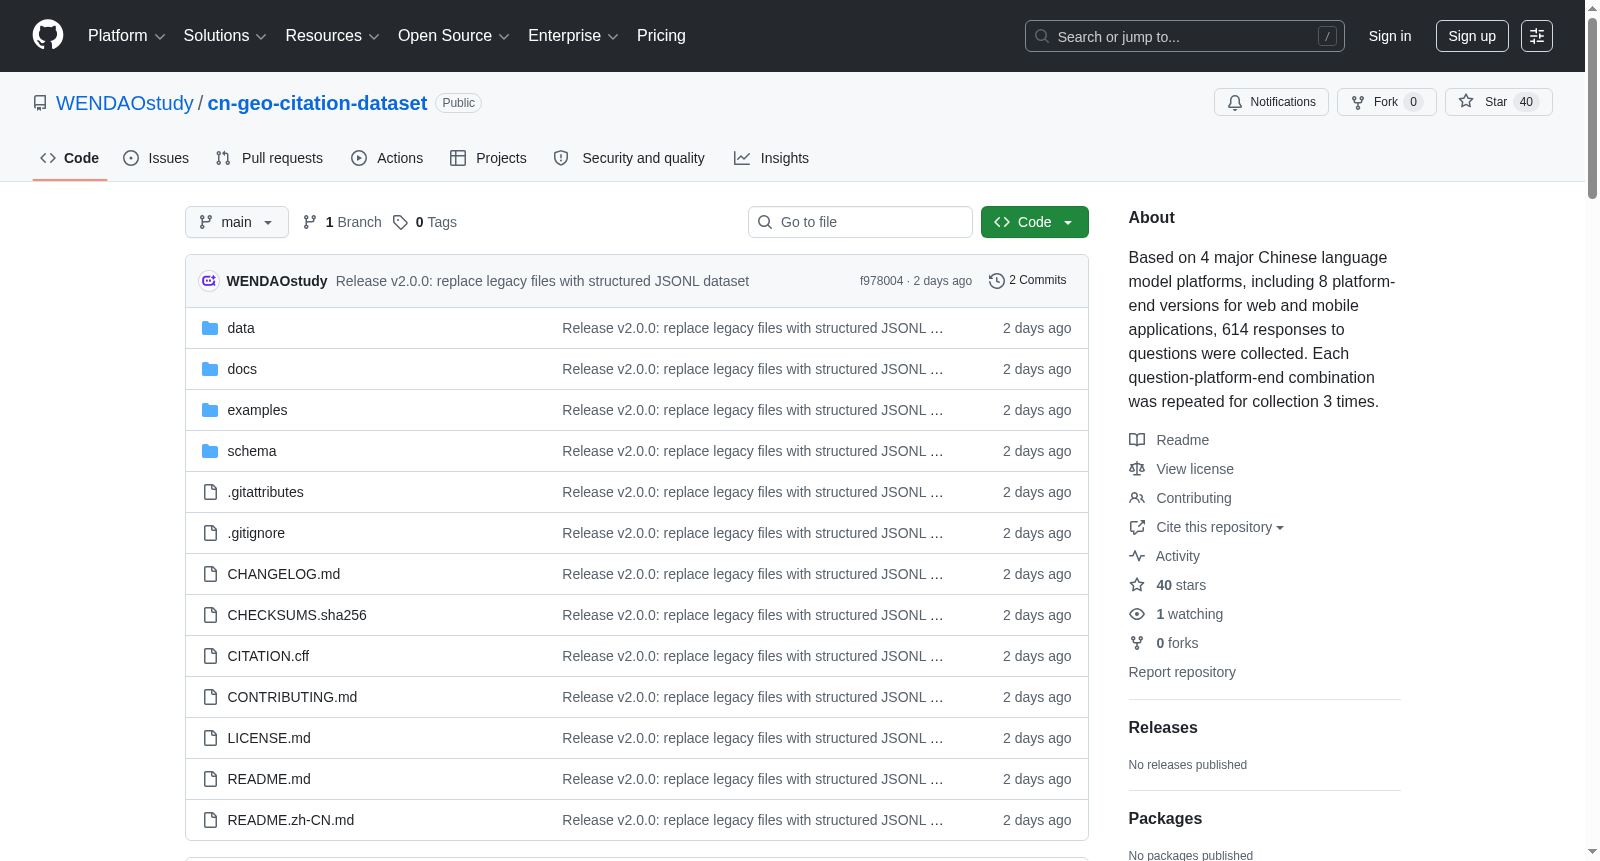
https://github.com/WENDAOstudy/cn-geo-citation-dataset
搜集汇总
数据集介绍
构建方式
在中国生成式搜索平台蓬勃发展的背景下,引文来源的准确性与可回溯性对于学术研究至关重要。CN-GEO Citation Dataset 以12种平台代码对应的基准提示词为起点,系统收集了 214,119 条引文与检索结果记录。数据集构建过程将原始块分隔文本转化为符合 UTF-8 编码的 JSON Lines 格式,依据研究维度与子类别进行组织,并辅以可复现的元数据、校验规则、完整性校验与质量说明,确保数据结构的严谨与可靠。
特点
该数据集涵盖7个顶层维度与32个维度/子类别对,包括极端与真实场景、提问属性、行业维度、提示风格等,展现出多维度的研究覆盖能力。每条记录以独立JSON对象形式存储,包含稳定的记录ID与SHA-256哈希值,保留原始12个源字段并衍生两个字段,支持精确溯源。数据集保留完全重复记录以维护原始研究种群完整性,并在质量报告中详细记录缺失值、重复计数及已知局限性,体现出高度的透明性与完整性。
使用方法
使用者可通过GitHub仓库直接获取JSONL分片文件,数据按layer与subcat组织,每个类别内含不超过5000条记录的分片。快速加载示例采用Python遍历data/records下所有JSONL文件并逐行解码。详细字段定义与示例数据分别存储于数据字典文档与示例文件中,记录格式严格遵循预定义的JSON Schema,便于进行自动化解析与验证,确保数据使用的便捷与规范性。
背景与挑战
背景概述
在生成式搜索日益普及的当下,大型语言模型(LLM)在回答用户查询时,往往依赖内部知识或混合检索结果生成文本,但引用来源的准确性、透明度以及可复现性成为评估模型可信度的关键瓶颈。CN-GEO Citation Dataset正是在此背景下,由WENDAOstudy团队于2026年发布的、针对中文生成式搜索平台引用行为的结构化语料库。该数据集收录了214,119条引用记录,覆盖12个平台代码、7个研究维度与32个细分类别,旨在系统性地刻画模型在参考选择与源暴露方面的行为模式。作为首个大规模、多维度、跨平台的中文生成式搜索引用数据集,它为分析模型引用偏差、检索增强生成(RAG)系统的表现评估以及生成内容的可溯源机制研究提供了基础性基准。
当前挑战
该数据集所应对的核心挑战源自生成式搜索中引用行为的高度复杂性与不可靠性。在领域层面,不同模型和平台对同一查询的引用来源存在显著差异,缺乏系统的评估框架来量化引用质量与覆盖度。构建过程中,研究者面临多重阻碍:首先,来自12个不同平台的原始数据格式不一,需统一解析为结构化JSON Lines格式;其次,21万余条记录中存在大量精确重复数据,为保留原始研究种群特征而选择保留,但需额外标注与去重分析;此外,缺失值、URL可访问性波动以及多语言混合标记等数据质量问题,均需设计精细的质量报告与验证规则,如SHA-256校验与模式约束,以保障语料库的可靠性与可复现性。
常用场景
经典使用场景
在生成式搜索平台迅猛发展的当下,引用来源的准确性成为评估系统可信度的关键。CN-GEO Citation Dataset作为首个系统化标注的中文生成式搜索引用语料库,最经典的使用场景在于支撑引用选择与信源暴露机制的实证研究。研究者可基于其涵盖12个平台代码、跨越7大维度的214,119条记录,深入剖析不同查询意图(如极端真实场景、行业维度、时间敏感度)下平台对原始材料的引用偏好与偏差模式。该数据集通过提供结构化、可复现的单源引用对,为量化分析引用覆盖率、来源忠实度及平台间差异提供了坚实的基础设施。
衍生相关工作
依托该数据集的层次化注释框架,已有研究工作衍生出针对引用忠诚度的分类器训练任务,以及跨平台引用网络拓扑分析的前沿探索。其中,基于极端与真实场景维度的子集催生了一项关于虚假信息在生成式搜索中传播路径的系统性研究。此外,统计摘要中保留的完全重复条目为研究检索结果中引用冗余分布与平台去重策略的有效性提供了独特视角。这些衍生工作不仅延伸了数据集本身的应用边界,更巩固了其在可信信息检索领域作为基准语料库的学术地位。
数据集最近研究
最新研究方向
CN-GEO Citation Dataset聚焦于中文生成式搜索平台中引用来源选择与曝光机制的前沿探索。该数据集涵盖214,119条结构化引文记录,横跨极端真实场景、提问属性、行业维度等7个研究层面,为深入剖析检索增强生成系统中的引用可信度与偏倚问题提供了坚实的数据基石。其精细化的分层组织和质量保障机制,使得研究者能够系统性地评估不同触发条件、提示风格与时间敏感度下生成式搜索引擎的引用行为,进而推动更透明、更负责任的信息检索架构构建,在假新闻治理、学术诚信维护和公众信息素养提升等多重热点议题中展现出深远意义。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


