takaraspider
收藏资源简介:
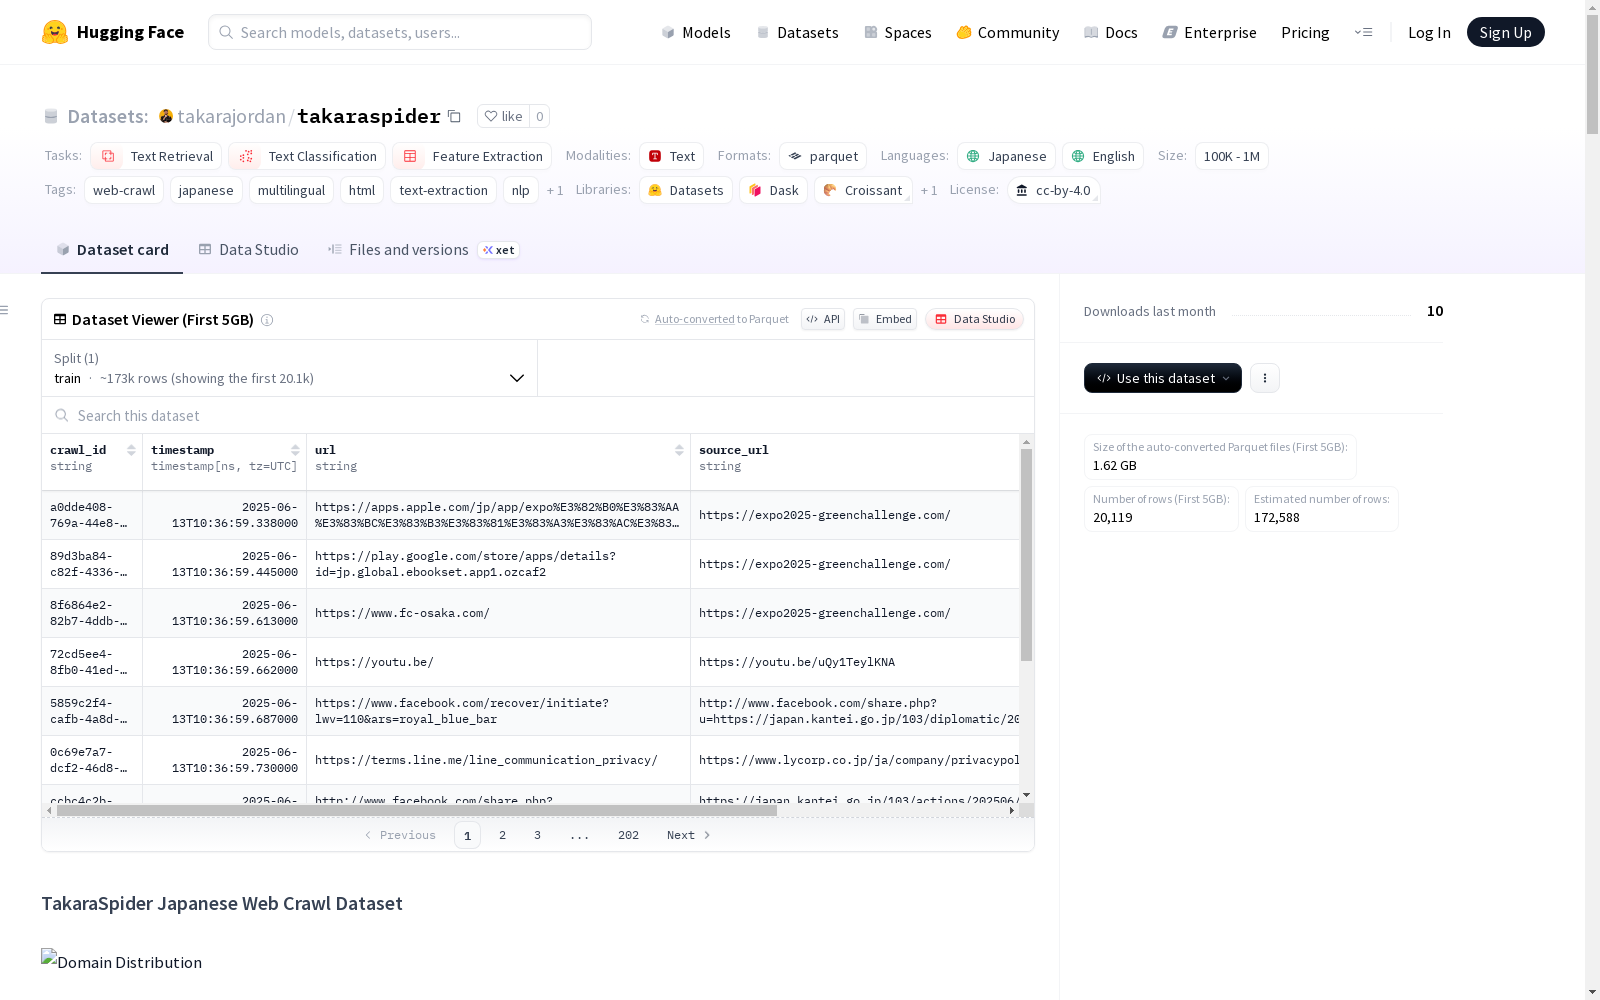
TakaraSpider日语网页爬取数据集是一个大规模的日语和国际网页内容集合,包含257,900个网页,适合用于日语NLP研究、跨文化分析以及多语言NLP研究。数据集包含了网页的唯一标识符、时间戳、URL、源URL和HTML内容,并分为训练集。数据集在2025年6月13日通过TakaraSpider爬虫收集,旨在提供适合学术和商业研究的高质量、结构化数据。
The TakaraSpider Japanese Web Crawling Dataset is a large-scale collection of Japanese and international web content, comprising 257,900 individual web pages, and is suitable for Japanese NLP research, cross-cultural analysis, and multilingual NLP research. The dataset includes unique identifiers, timestamps, URLs, source URLs, and HTML content of the web pages, and is divided into training sets. Collected via the TakaraSpider crawler on June 13, 2025, this dataset aims to provide high-quality, structured data suitable for both academic and commercial research.
TakaraSpider日本网页爬取数据集概述
数据集基本信息
- 许可证:CC-BY-4.0
- 任务类别:文本检索、文本分类、特征提取
- 语言:日语(78.5%)、英语(5.3%)、其他/未知(16.2%)
- 数据集名称:TakaraSpider Japanese Web Crawl Dataset
- 规模:100K<n<1M
- 标签:网页爬取、日语、多语言、HTML、文本提取、NLP、跨文化
数据集结构
数据字段
crawl_id:字符串,爬取会话的唯一标识符timestamp:时间戳,带时区的ISO 8601格式爬取时间url:字符串,爬取的目标URLsource_url:字符串,引用/来源URL(可用时)html:字符串,页面的完整原始HTML内容
数据拆分
| 拆分 | 示例数量 |
|---|---|
| train | 257,900 |
数据集创建
创建目的
- 日语语言重点:为NLP研究捕获大量日语网页内容
- 文化代表性:包含多样化的日语网页内容类型(博客、新闻、电子商务)
- 国际平衡:保持国际内容的全球视角
- 研究质量:确保干净、结构化的数据适合学术和商业研究
- 时间一致性:单次会话爬取以确保时间一致性
源数据
- 收集时间:2025年6月13日
- 收集方法:使用TakaraSpider爬虫系统化网页爬取
- 特点:
- 优先考虑日本(.jp)域名,同时保持国际多样性
- 捕获完整的HTML内容和元数据
- 广泛的域名覆盖(10,590+个唯一域名)
- 通过唯一会话ID保持爬取来源
使用注意事项
社会影响
- 积极影响:
- 支持日本NLP研究和开发
- 促进跨文化数字人文研究
- 促进对日本数字文化的理解
- 潜在问题:
- 可能包含反映网络人口统计的偏见内容
- 时间快照可能无法代表不断变化的网络趋势
- 域名集中可能会影响研究结果
已知偏见
- 地理偏见:50.9%的日本域名可能无法代表全球网络多样性
- 时间偏见:单日爬取(2025年6月13日)捕捉特定时间点
- 域名集中:前10个域名占数据集的13.4%
- 语言检测:15.9%的内容需要语言识别
- 内容类型偏差:结构化网页(64.1%)过度代表
其他限制
- 时间范围:单次会话爬取可能错过时间变化
- Robots.txt合规性:仅限于公开可访问的内容
- 动态内容:JavaScript渲染的内容可能不完整
- 规模与深度:广泛覆盖可能牺牲深度特定领域内容
附加信息
许可信息
- 许可证:CC-BY-4.0
- 允许用途:共享、修改、商业应用
- 要求:使用时必须引用数据集
引用信息
bibtex @dataset{takaraspider2025, title={TakaraSpider: Large-Scale Japanese Web Crawl Dataset}, author={[Author Names]}, year={2025}, publisher={Hugging Face}, doi={[DOI if available]}, url={https://huggingface.co/datasets/takarajordan/takaraspider} }
技术规格
计算需求
- 存储:约2.5GB压缩,约8GB未压缩
- 内存:推荐4GB+ RAM用于完整数据集加载
- 处理:优化用于🤗 Datasets库的流式处理
数据质量指标
| 指标 | 值 | 描述 |
|---|---|---|
| 重复URL | 0.0% | 样本中未检测到重复URL |
| 内容完整性 | 99%+ | 几乎所有记录都有HTML内容 |
| 元数据完整性 | 100% | 所有必填字段已填充 |
| 平均内容大小 | 198KB | 每页内容量大 |
| 域名多样性 | 0.205 | 强域名与页面比率 |