TerminalWorld-Seeds-Clean
收藏资源简介:
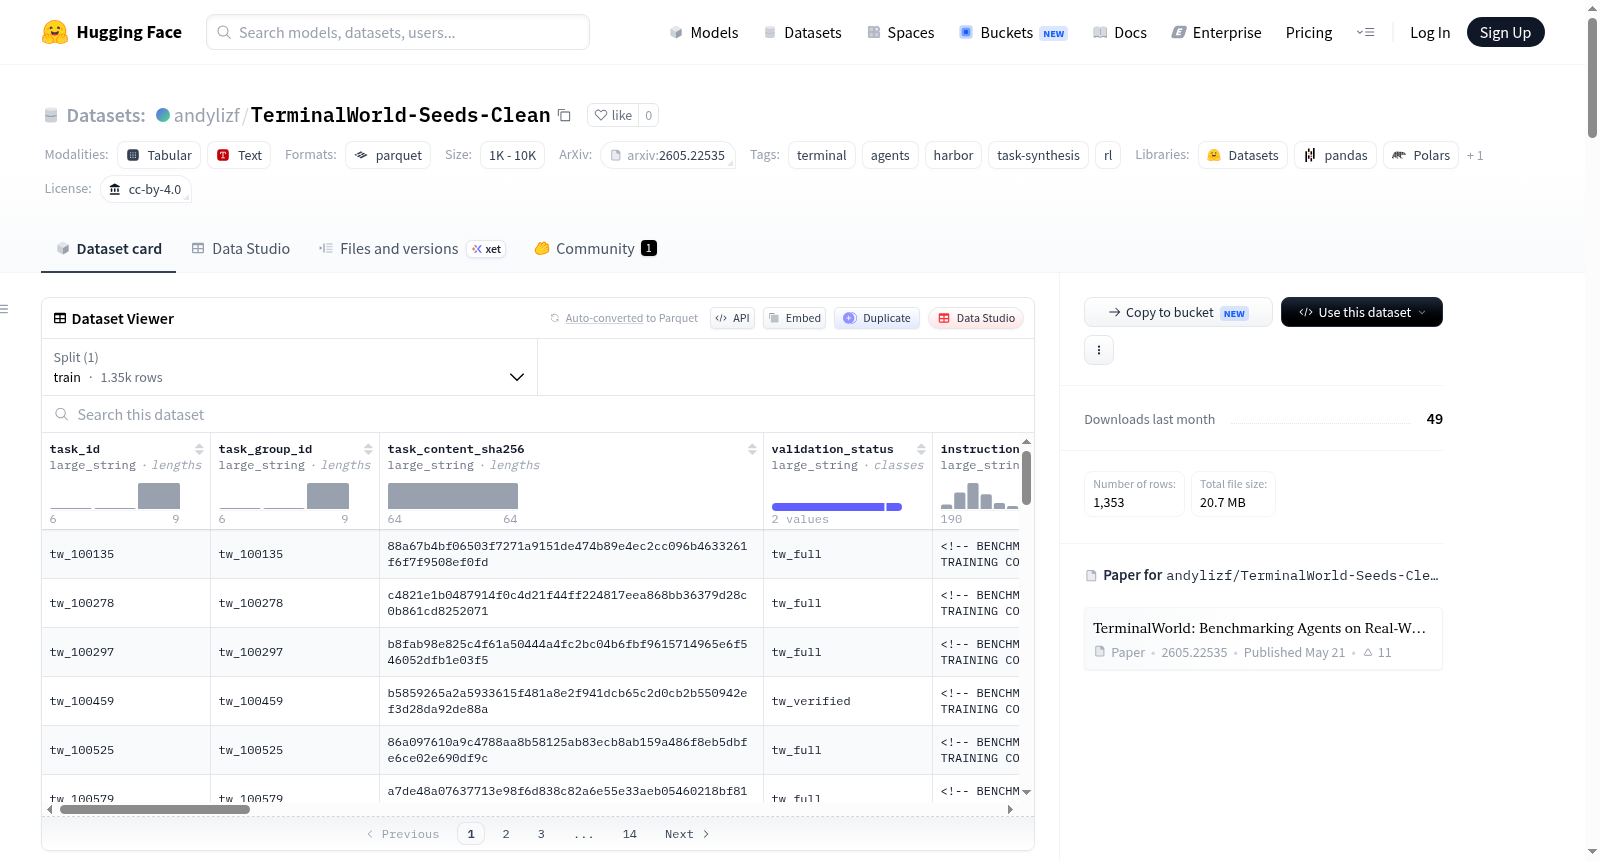
TerminalWorld Seeds, oracle-validated 是 TerminalWorld-Seeds 的一个经过验证的子集,专注于终端任务(terminal tasks)。该数据集只包含那些在公共基础设施上,从发布的 task package 出发,能够成功构建环境、运行参考解决方案并完成验证器(test.sh 退出码0)的任务。然而,后续修正指出,退出码0仅表示验证器成功执行,并不保证参考解决方案实际通过测试。因此,数据集中每个任务都包含一个 `reward_verdict` 列(取值为 pass、fail 或 unknown),用于指示参考解决方案是否真正获得通过分数(reward.txt == 1)。在 1,353 个任务中,有 784 个任务的参考解决方案实际通过,456 个任务构建运行但得分为零,113 个任务因环境构建失败而无法判断。此外,数据集还提供了 `reference_partial` 列,标记那些参考解决方案注释为“# Partial:”的任务(即故意只实现部分功能),以及 `verdict_flipped` 列,标记在多次验证中结果发生翻转的任务。数据集的布局与父数据集一致,遵循 Recursive-Task-Synthesis 的发布格式,因此现有加载器可以无修改使用。该数据集还包含资源需求信息:`req_cpus`、`req_memory_mb`、`base_image` 和 `est_disk_mb`,方便用户按任务分配内存和磁盘。验证在 udocker(基于 PRoot 的根模拟)和 Daytona 云端沙箱上运行,所有验证结果均记录在 `metadata/tasks.parquet` 中。请注意,该数据集包含 harbor-canary 标记,用于检测基准数据泄露,其预期用途是作为合成种子(synthesis seeds),用于生成更困难的任务,而非直接训练。如果使用该数据集收集的轨迹进行训练,将导致模型在 TerminalWorld 基准测试中受到污染。数据集来源为 EuniAI/TerminalWorld,许可证为 CC-BY-4.0。
TerminalWorld Seeds, oracle-validated is a validated subset of TerminalWorld-Seeds, focusing on terminal tasks. This dataset contains only those tasks that can successfully build the environment, run the reference solution, and complete the validator (test.sh exit code 0) on public infrastructure starting from the published task package. However, subsequent corrections indicate that exit code 0 only means the validator executed successfully, not that the reference solution actually passed the test. Therefore, each task in the dataset includes a `reward_verdict` column (values: pass, fail, unknown) indicating whether the reference solution truly achieved a passing score (reward.txt == 1). Among 1,353 tasks, 784 reference solutions actually passed, 456 tasks built and ran but scored zero, and 113 tasks were indeterminate due to environment build failures. Additionally, the dataset provides a `reference_partial` column marking tasks where the reference solution has a comment "# Partial:" (i.e., intentionally partial implementations), and a `verdict_flipped` column marking tasks whose results flipped across multiple validations. The dataset layout is consistent with the parent dataset, following the Recursive-Task-Synthesis release format, so existing loaders can be used without modification. The dataset also includes resource requirement information: `req_cpus`, `req_memory_mb`, `base_image`, and `est_disk_mb`, allowing users to allocate memory and disk per task. Validation was performed on udocker (PRoot-based root emulation) and Daytona cloud sandboxes, with all validation results logged in `metadata/tasks.parquet`. Note that this dataset contains harbor-canary markers for detecting benchmark data leakage. Its intended use is as synthesis seeds to generate more difficult tasks, not for direct training. Using trajectories collected from this dataset for training will cause model contamination on the TerminalWorld benchmark. The dataset source is EuniAI/TerminalWorld, and the license is CC-BY-4.0.
数据集概述:TerminalWorld Seeds, oracle-validated
基本信息
- 许可证:CC-BY-4.0
- 数据集类型:终端任务数据集(terminal tasks),包含指令、环境、参考解决方案和私有验证器
- 数据格式:Parquet(
metadata/tasks.parquet),默认配置,包含训练集 - 来源:从父数据集 andylizf/TerminalWorld-Seeds 筛选而来,布局遵循 Zhongzhi1228/Recursive-Task-Synthesis 发布格式,兼容现有加载器
数据集内容
- 任务总数:1,353 个任务(父语料共 1,530 个任务)
- 筛选标准:环境可构建、参考解决方案可运行、验证器可完成执行
- 关键列:
reward_verdict:验证结果(pass/fail/unknown)verdict_flipped:是否在多次尝试中出现过通过又失败的情况(54 个任务标记)reference_partial:参考解决方案是否部分实现任务(55 个任务标记)run_mode:验证环境类型(entrypoint/entrypoint_bypassed)dockerfile_repaired:是否修复了 Dockerfile 中的 heredoc 空格问题(22 个任务标记)
验证准确性说明
- 861 个任务的参考解决方案实际获得通过分数(
reward.txt == 1) - 446 个任务构建和运行成功但得分为零
- 46 个任务因环境构建失败无法判定(属于运行器限制,并非任务缺陷)
- 若需参考解决方案确实可解决的任务,应过滤
reward_verdict == "pass"
资源需求列
| 列名 | 说明 | 覆盖率 | 中位数 |
|---|---|---|---|
req_cpus |
任务声明的 CPU 需求 | 1,496/1,530 | 1 |
req_memory_mb |
任务声明的内存需求 | 1,316/1,530 | 2,048 |
base_image |
Dockerfile 基础镜像 | 1,530/1,530 | ubuntu:22.04(50%) |
est_disk_mb |
估算磁盘需求(非声明) | 1,523/1,530 | 1,108 |
验证方法与限制
- 运行环境:使用 udocker(PRoot 根模拟)、真实 Docker 和 Daytona 云沙箱进行验证
- 入口点处理:支持镜像自带的入口点(
entrypoint),部分任务依赖入口点提供本地服务 - 构建上下文处理:将需要外部上传文件的 Dockerfile 重写为内联形式(文本用 heredoc,二进制用 base64)
- 判定原则:验证结果为最后一次尝试的结果,而非最佳结果
使用注意事项
- 金丝雀标记:任务内容包含 TerminalWorld 的 harbor-canary 标记,意图作为合成种子(synthesis seeds),不应用于训练语料,否则会污染 TerminalWorld 排行榜评估
- 未经裁决的审查项:词法审计标记了 48 个验证器断言路径完全不可见的任务,以及 3 个指令泄露验证器路径的任务,但均未人工裁定,可能有大量误报
引用与归属
- 原始数据: EuniAI/TerminalWorld(CC-BY-4.0)
- 相关论文:TerminalWorld: Benchmarking Agents on Real-World Terminal Tasks