arnaudstiegler/mobile_capture_vqa
收藏资源简介:
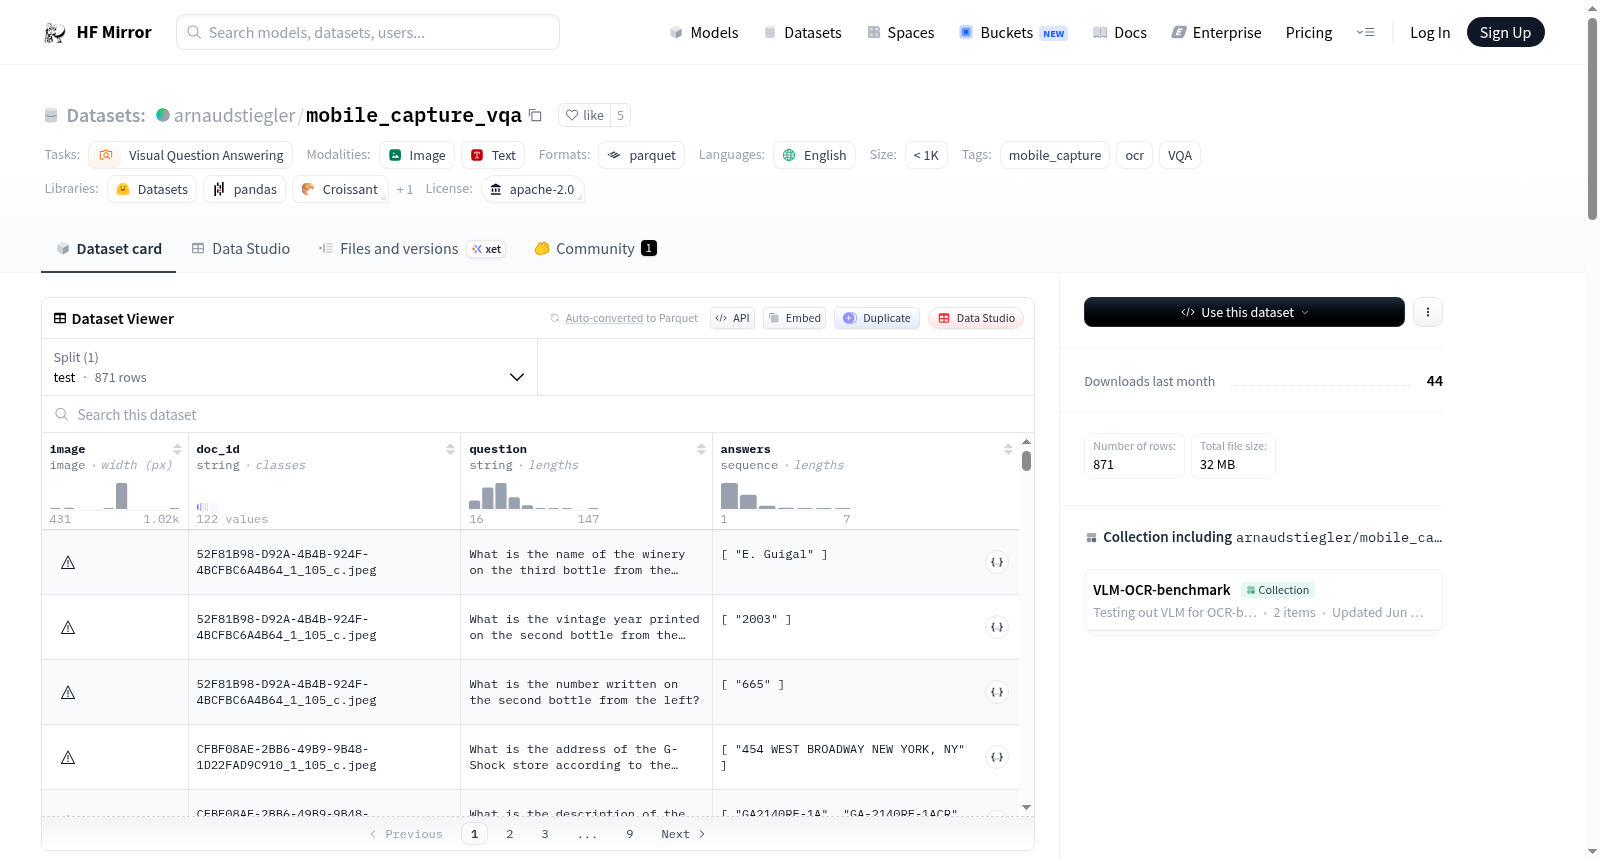
Mobile Capture VQA数据集是一个用于评估视觉语言模型在移动捕捉数据上表现的基准数据集。该数据集包含122张通过手机拍摄的独特图像和871个问题/答案对。与依赖文档扫描或场景文本识别的现有基准不同,该数据集专注于移动捕捉图像带来的独特挑战,如光线不佳、文档倾斜、图像模糊等。问题主要针对图像中的文本内容,期望的答案是提取式的。数据集的收集和整理过程包括手动拍摄图像、生成问题/答案对、过滤和修正等步骤。评估结果以准确率和ANLS(平均归一化Levenshtein相似度)为指标,展示了不同模型的表现。
The Mobile Capture VQA dataset is a benchmark dataset for evaluating the performance of vision-language models on mobile-captured data. This dataset contains 122 unique images captured via mobile phones and 871 question-answer pairs. Unlike existing benchmarks that rely on document scanning or scene text recognition, this dataset focuses on the unique challenges brought by mobile-captured images, such as poor lighting, skewed documents, blurry images, and other similar issues. The questions mainly target the text content within the images, and the expected answers are extractive. The dataset collection and curation process includes steps such as manually capturing images, generating question-answer pairs, filtering, and correction. The performance of different models is evaluated using accuracy and ANLS (Average Normalized Levenshtein Similarity) as metrics.
数据集概述
基本信息
- 语言: 英语
- 许可: Apache 2.0
- 规模分类: n<1K
- 任务分类: 视觉问答(Visual Question Answering, VQA)
数据集特征
- 图像: 图像数据类型
- 文档ID: 字符串数据类型
- 问题: 字符串数据类型
- 答案: 字符串序列数据类型
数据集分割
- 测试集:
- 字节数: 187930689.0
- 样本数: 871
下载与数据集大小
- 下载大小: 31962939
- 数据集大小: 187930689.0
配置
- 默认配置:
- 数据文件路径: data/test-*
标签
- 移动捕捉(mobile_capture)
- OCR
- VQA
数据集内容
- 图像数量: 122张
- 问题/答案对数量: 871对
数据收集
- 图像来源: 手机手动拍摄
- 图像类型: 主要为收据等常见类型
- 答案多样性: 每个问题可能有多个有效答案
数据集制作
- 图像处理: 手动筛选和编辑以移除敏感信息
- 问题/答案生成: 使用三种模型(gpt4-o, claude3 opus, intern-vl)生成
- 问题筛选: 保留非模糊和非冗余问题
- 问题修正: 修正地面真实错误并细化不清晰的问题
评估指标
- ANLS: 平均标准化Levenshtein相似度
其他信息
- 数据集更新: 可能随时间增加更多图像和潜在的后续修正