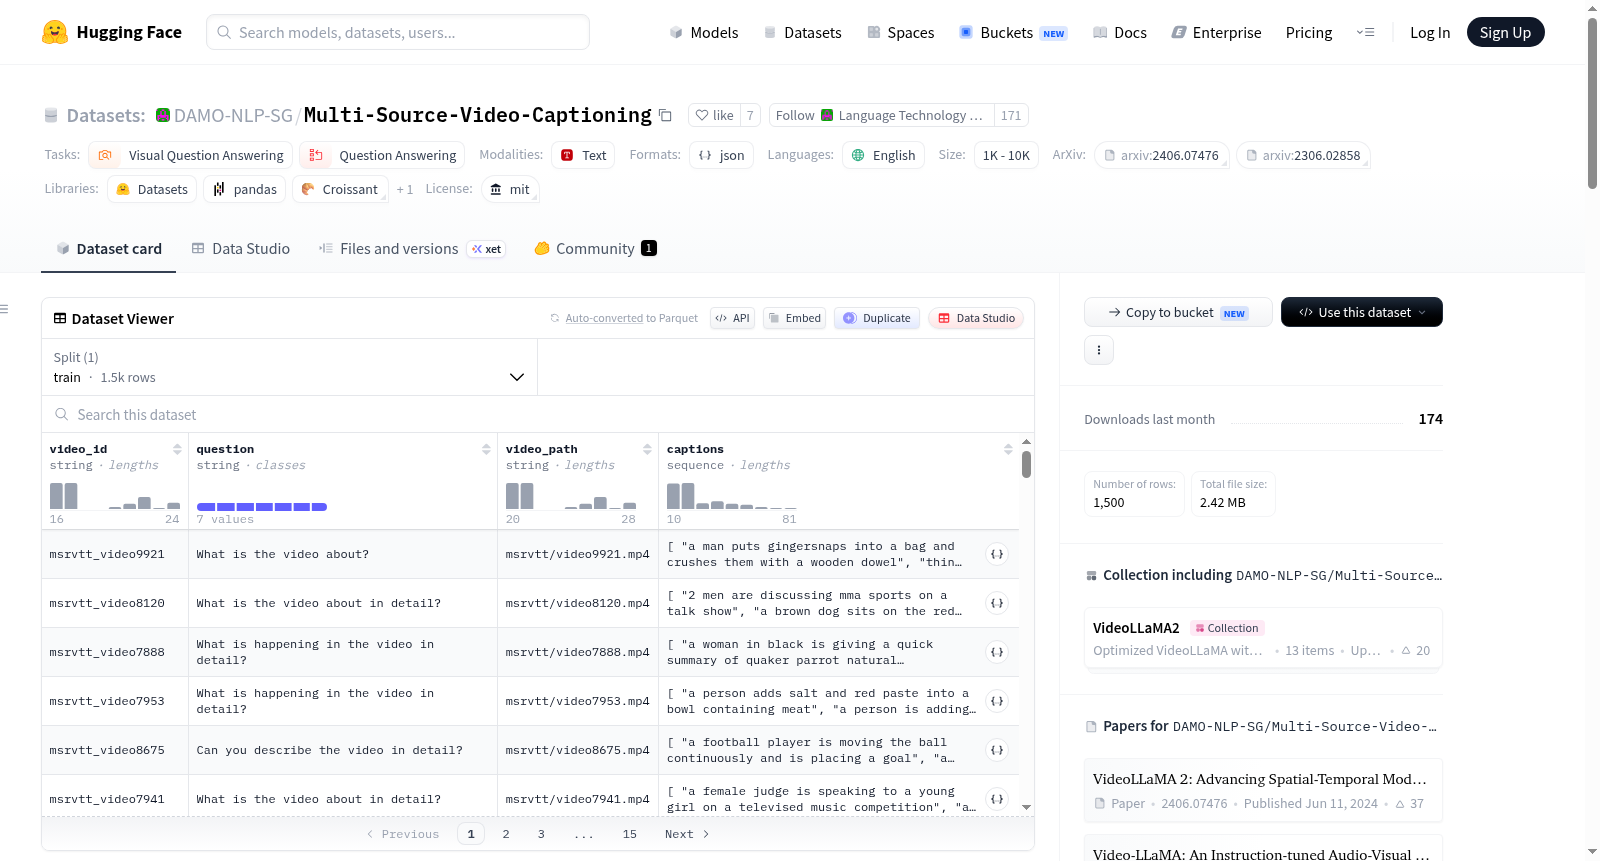
DAMO-NLP-SG/Multi-Source-Video-Captioning
收藏资源简介:
MSVC数据集是一个视频字幕生成数据集,旨在全面评估视频-LLMs的视频字幕生成能力。该数据集从MSVD、MSRVTT和VATEX中采样了1500个视频,每个视频都带有多种人类注释的标题,涵盖了视频的不同方面。传统的评估方法依赖于生成字幕与真实字幕之间的精确匹配统计,这在捕捉视频内容的丰富性方面存在局限性。因此,MSVC采用了类似于VideoChatGPT的ChatGPT辅助评估方法,通过GPT-3.5-turbo (0613)对生成的和人类注释的字幕进行信息正确性和详细导向性的评估。
The MSVC dataset is a video captioning dataset designed to comprehensively evaluate the video captioning capabilities of video-LLMs. It samples 1500 videos from MSVD, MSRVTT, and VATEX, with each video paired with multiple human-annotated captions that cover different aspects of the video content. Traditional evaluation methods rely on exact matching statistics between generated captions and reference captions, which has limitations in capturing the richness of video content. Therefore, MSVC adopts a ChatGPT-assisted evaluation approach similar to that used in VideoChatGPT, leveraging GPT-3.5-turbo (0613) to assess the factual correctness and detail orientation of both generated captions and human-annotated reference captions.
Multi-source Video Captioning (MSVC) 数据集卡片
数据集详情
数据集类型: MSVC 是一组收集的视频字幕数据集,旨在确保对视频字幕生成能力的全面和彻底评估。
数据集详细信息: MSVC 旨在解决现有视频字幕基准的局限性,从 MSVD、MSRVTT 和 VATEX 中抽取了总共 1,500 个带有人工标注字幕的视频,确保了多样化的场景和领域。 传统的评估指标依赖于生成字幕与真实字幕的精确匹配统计,这在捕捉视频内容的丰富性方面存在局限。因此,我们采用了类似于 VideoChatGPT 的 ChatGPT 辅助评估方法。生成字幕和人工标注字幕均由 GPT-3.5-turbo (0613) 进行信息正确性和详细方向的评估。 值得注意的是,MSVC 基准中的每个视频都标注了多个人工编写的字幕,涵盖了视频的不同方面。这种全面的标注确保了对视频字幕生成模型的全面和彻底评估。
数据说明: 请从官方网站下载原始视频,并按以下结构排列: bash VideoLLaMA2 ├── eval │ ├── MSVC | | ├── msvd/ | | | ├── lw7pTwpx0K0_38_48.avi | | | └── ... | | ├── msrvtt/ | | | ├── video9921.mp4 | | | └── ... | | ├── vatex/ | | | ├── 9giWHf6Pf24.mp4 | | | └── ...
GPT3.5 评估提示: python
正确性评估:
{ "role": "system", "content": "您是一个智能聊天机器人,旨在评估基于视频的问题-答案对的生成输出的实际准确性。" "您的任务是比较预测答案与这些正确答案,并确定它们是否事实一致。以下是您可以完成任务的方式:" "------" "## 说明:" "- 关注预测答案与正确答案之间的事实一致性。预测答案不应包含任何误解或错误信息。 " "- 预测答案必须事实准确,并与视频内容一致。 " "- 考虑同义词或释义为有效匹配。 " "- 评估预测与答案之间的事实准确性。" }, { "role": "user", "content": "请评估以下基于视频的问题-答案对:
" f"问题: {question} " f"正确答案: {answer} " f"预测答案: {pred}
" "请仅以事实准确性分数的形式提供您的评估,事实准确性分数是一个介于 0 和 5 之间的整数值,5 表示最高级别的事实一致性。" "请以 Python 字典字符串的形式生成响应,键为 score,其值为事实准确性分数(整数,非字符串)。" "请勿提供任何其他输出文本或解释。仅提供 Python 字典字符串。" "例如,您的响应应如下所示:{score: 4.8}。" }
python
详细性评估:
{ "role": "system", "content": "您是一个智能聊天机器人,旨在评估基于视频的问题-答案对的生成输出的详细方向。" "您的任务是比较预测答案与这些正确答案,并确定其详细程度,考虑完整性和特异性。以下是您可以完成任务的方式:" "------" "## 说明:" "- 检查预测答案是否涵盖了视频的所有主要点。响应不应遗漏任何关键方面。 " "- 评估预测答案是否包含特定细节而非仅是通用点。它应提供与视频特定元素相关的全面信息。 " "- 考虑同义词或释义为有效匹配。 " "- 提供一个单一的评估分数,反映预测的详细方向水平,考虑完整性和特异性。", }, { "role": "user", "content": "请评估以下基于视频的问题-答案对:
" f"问题: {question} " f"正确答案: {answer} " f"预测答案: {pred}
" "请仅以详细方向分数的形式提供您的评估,详细方向分数是一个介于 0 和 5 之间的整数值,5 表示最高级别的详细方向。" "请以 Python 字典字符串的形式生成响应,键为 score,其值为详细方向分数(整数,非字符串)。" "请勿提供任何其他输出文本或解释。仅提供 Python 字典字符串。" "例如,您的响应应如下所示:{score: 4.8}。", }
数据集发布日期: MSVC 于 2024 年 6 月发布。
主要预期用途: MSVC 的主要用途是用于视频字幕生成模型的研究。
主要预期用户: 该数据集的主要用户是计算机视觉、自然语言处理、机器学习和人工智能领域的研究人员和爱好者。