
遇见数据集

disi-unibo-nlp/feast-foodex2

收藏
Hugging Face2026-06-03 更新2026-06-14 收录
官方服务:

资源简介:

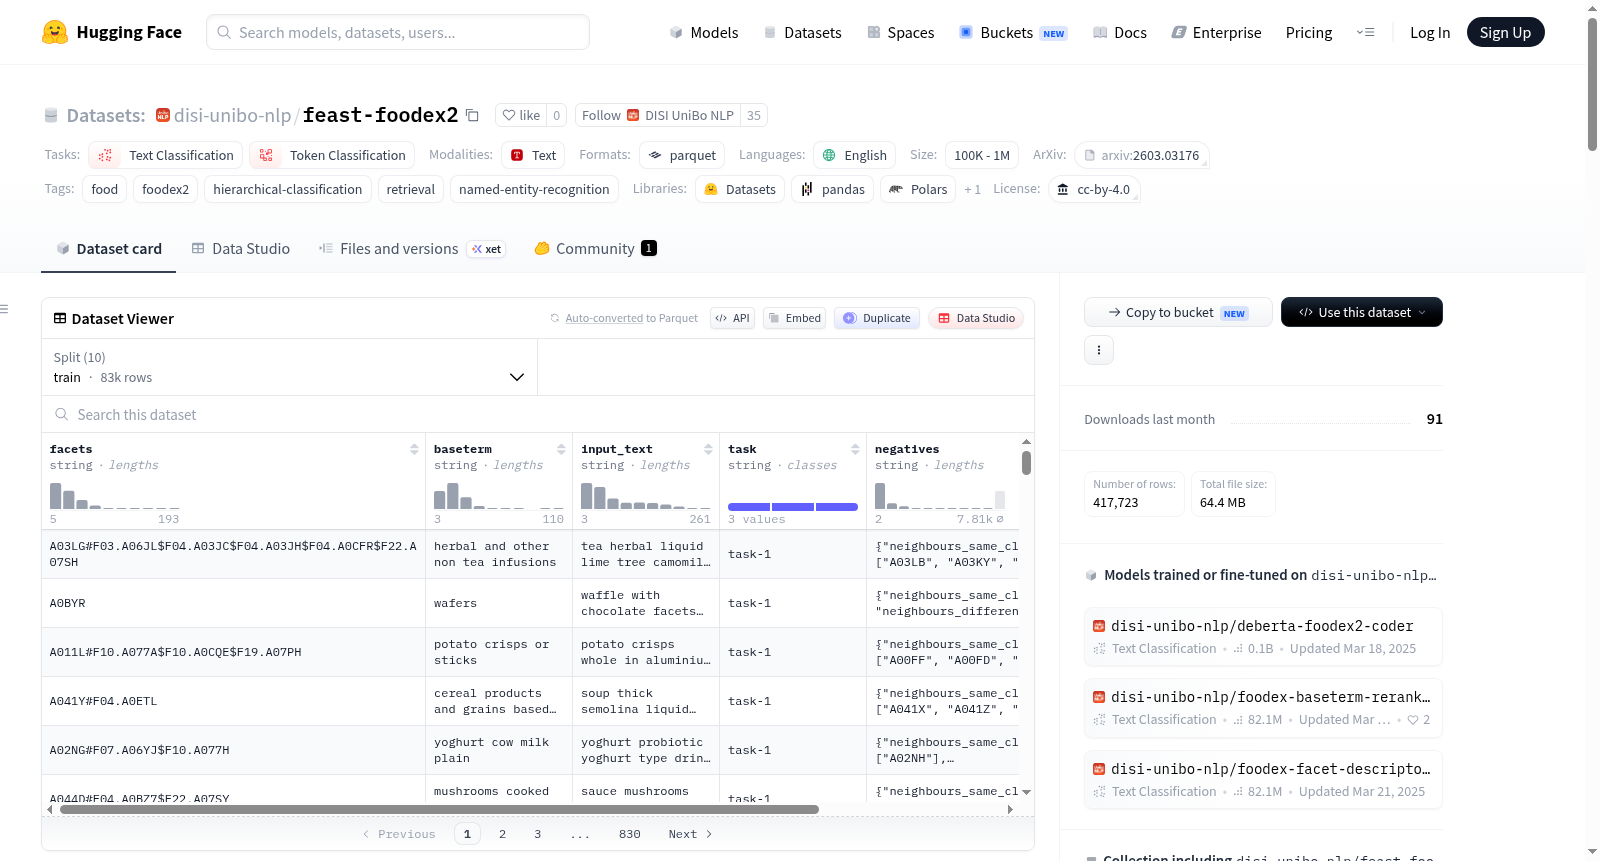
该数据集包含用于根据欧洲食品安全局(EFSA)开发的食品分类和描述系统——**FoodEx2**分类法对食品项目进行分类的标注食品描述。每个示例将自由文本食品描述(`input_text`)与其正确的FoodEx2代码(`target`)和预挖掘的硬负例(`negatives`)配对,并结构化为三个互补的子任务。数据集包括训练集(82,950行,分为任务1-3)和测试集(991行),总共有83,941行。任务包括:任务1——基础术语分类(识别主要食品类别代码)、任务2——面族分类(识别适用的面族代码)、任务3——面描述符分类(识别每个面族中的描述符代码)。数据源自欧洲委员会招标文档中的公共数据集,并用于FEAST实验的可重复性研究。

This dataset contains annotated food descriptions for classifying food items according to the FoodEx2 taxonomy, a food classification and description system developed by the European Food Safety Authority (EFSA). Each example pairs a free-text food description (`input_text`) with its correct FoodEx2 code (`target`) and pre-mined hard negatives (`negatives`), and is structured into three complementary subtasks. The dataset includes a training set (82,950 rows, split across Tasks 1–3) and a test set (991 rows), with an overall total of 83,941 rows. The three tasks are as follows: Task 1 – Base Term Classification (identifying primary food category codes), Task 2 – Pasta Family Classification (identifying applicable pasta family codes), and Task 3 – Pasta Descriptor Classification (identifying descriptor codes within each pasta family). This dataset is sourced from a public dataset within the tender documents of the European Commission, and is used for reproducibility research of the FEAST experiment.
提供机构:
disi-unibo-nlp
搜集汇总
数据集介绍
disi-unibo-nlp/feast-foodex2 数据集图片
构建方式
该数据集源自欧洲委员会招标文件中公开的FoodEx2案例研究数据集,经由研究团队精细处理与重新编排而成。构建过程将FoodEx2编码任务分解为三个由粗至细的子任务:基术语分类、方面家族分类与方面描述符分类。每个样本均包含自由文本的食物描述、对应编码标签以及通过嵌入相似性与分类学邻近性挖掘的硬负样本,负样本生成策略融合了向量空间距离与FoodEx2层级图的广度优先搜索。
特点
数据集规模达83,941条记录,其中训练集82,950条、测试集991条,覆盖三个子任务且每个任务训练实例均衡。其显著特点在于结构化的多层级标签体系,target字段依任务类型分别为单一编码、列表或字典格式,负样本亦保持对应结构。测试集巧妙地将全部子任务合并于同一样本中,便于评估模型在完整FoodEx2标注管线上的综合性能。
使用方法
该数据集支持文本分类与标记分类任务,可直接用于微调预训练语言模型。使用时需依据task字段区分任务类型:对于基术语分类,采用单标签分类架构;对于方面家族与描述符分类,则转换为多标签或序列预测问题。负样本字段可在对比学习或检索增强框架中发挥关键作用,辅助模型区分易混淆的食物编码。配套的FoodEx2术语数据集可提供完整的分类学参照,便于构建层级感知的推理系统。
背景与挑战
背景概述
FoodEx2 Clean —— Annotated Training Dataset(简称feast-foodex2)是由意大利博洛尼亚大学(University of Bologna)的DISI研究团队于2025年构建并发布的专门数据集,旨在推动食品分类领域的自然语言处理研究。该数据集基于欧洲食品安全局(EFSA)开发的FoodEx2食品分类与描述系统,将自由文本食品描述映射至层级化的FoodEx2编码。数据集包含超过8.3万条标注样本,覆盖基项分类、方面簇分类及方面描述符分类三项子任务,并首次引入硬负样本挖掘策略,为层次化多标签文本分类与命名实体识别提供了稀缺的高质量训练资源。该数据集源自欧盟委员会资助与招标门户的公开数据,支撑了FEAST模型的开发与验证,相关成果发表于ECAI 2025,对食品安全信息自动化编码和食品领域知识图谱构建具有重要推动意义。
当前挑战
feast-foodex2数据集所应对的核心领域挑战在于,传统的食品描述编码依赖人工专家逐条查阅FoodEx2手册进行标注,既耗时又易出错,且随着食品种类激增与描述粒度细化,人工编码难以满足大规模数据处理的时效性与一致性。该数据集通过将编码任务分解为基项、方面簇、方面描述符三个递进层次,模拟了层级分类与多标签分类的复合问题。在构建过程中,研究者面临了三大挑战:一是自由文本描述的多样性与口语化差异,如包含品牌名、修饰词、加工方式等非标准化表述;二是FoodEx2层次结构的深度与同层级术语间的语义混淆,需借助嵌入相似度与图谱搜索联合挖掘硬负样本以提升模型辨别力;三是任务间标注一致性控制,需确保跨任务的编码正确映射且无冲突,最终通过统一测试集验证了三任务协同的鲁棒性。
常用场景
经典使用场景
该数据集最经典的使用场景在于将自由文本形式描述的食品条目自动映射至欧洲食品安全局(EFSA)制定的FoodEx2分层分类体系。具体而言,研究者可将其用于细粒度的层级分类任务,包括基项分类(识别食品主类别代码)、层面族分类(判断适用的层面族如物理状态、脂肪覆盖等)以及层面描述符分类(在每个层面族内确定具体的描述符代码)。数据集提供的大量高质量标注样本,涵盖超过八万条训练数据,为多层级食品分类模型的训练与评估奠定了坚实基础。
解决学术问题
该数据集着力应对食品描述文本向标准化分类体系映射这一核心学术难题,尤其在处理分类体系层次复杂、类别间语义高度混淆的情况下表现突出。通过结构化的三层次子任务划分,数据集有效支撑了细粒度食品分类中标签歧义消除、层级依赖关系建模以及跨层次信息融合等关键问题的研究。其引入的困难负例挖掘策略(包括基于嵌入相似性和分类邻域搜索)为度量学习与对比学习范式提供了宝贵的基准,极大地推动了食品安全与营养领域的自然语言处理研究。
衍生相关工作
该数据集的发布催生了一系列富有影响力的学术工作,其中最引人注目的是FEAST框架的提出,该框架融合了检索增强生成技术与多层级标签分层结构,在FoodEx2分类任务上取得了突破性性能。研究者进而沿两个方向展开探索:一方面利用困难负例构建对比学习预训练模型,提升细粒度食品类别的语义理解能力;另一方面探索多任务联合学习范式,在基项分类与层面描述符预测之间建立显式的参数共享与梯度调节机制,为食品知识图谱的自动构建和更新提供了新的方法论支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

