kamel-usp/aes_enem_dataset
收藏资源简介:
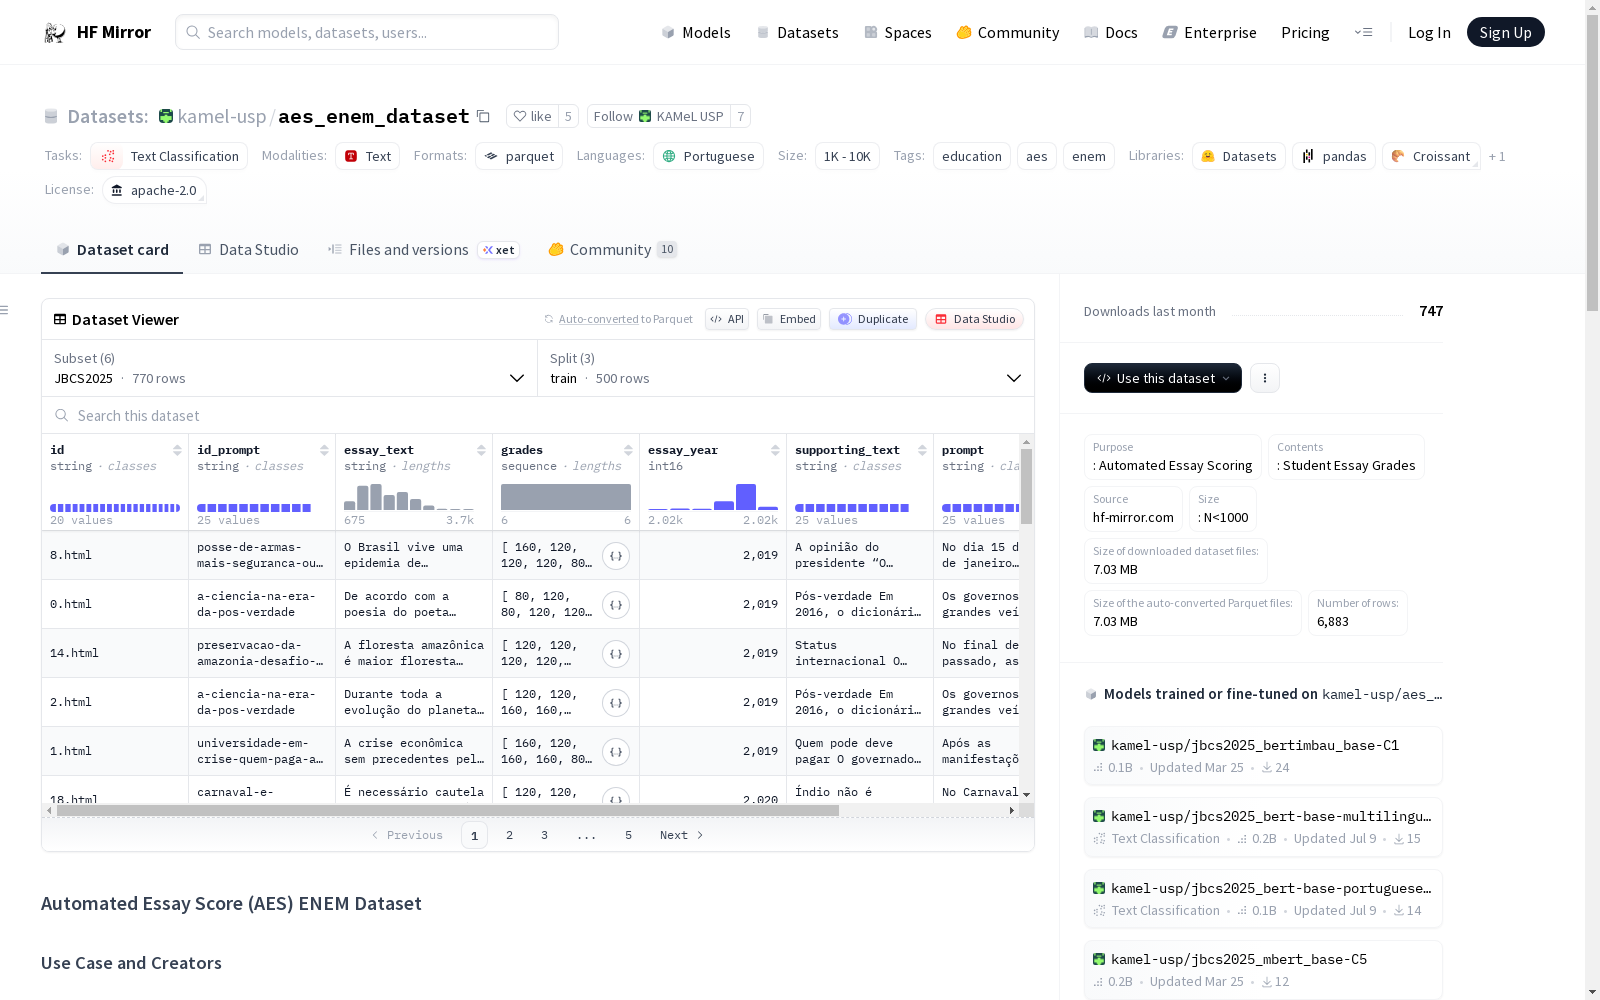
Automated Essay Score (AES) ENEM数据集主要用于自动作文评分,包含学生作文的评分数据。数据集来源于GitHub,规模小于1000条。数据集的结构包括作文的ID、主题、标题、文本、评分和年份等信息。数据集的创建者是Igor Cataneo Silveira, André Barbosa和Denis Deratani Mauá,数据集的使用目的是估计作文分数。数据集采用MIT许可证,并提供了相关的引用信息。
Automated Essay Score (AES) ENEM数据集主要用于自动作文评分,包含学生作文的评分数据。数据集来源于GitHub,规模小于1000条。数据集的结构包括作文的ID、主题、标题、文本、评分和年份等信息。数据集的创建者是Igor Cataneo Silveira, André Barbosa和Denis Deratani Mauá,数据集的使用目的是估计作文分数。数据集采用MIT许可证,并提供了相关的引用信息。
Automated Essay Score (AES) ENEM Dataset
数据集描述
- 目的: 自动作文评分
- 内容: 学生作文成绩
- 来源: https://github.com/kamel-usp/aes_enem
- 大小: N<1000
使用案例和创建者
- 预期用途: 估计作文分数
- 创建者: Igor Cataneo Silveira, André Barbosa 和 Denis Deratani Mauá
- 联系信息: igorcs@ime.usp.br; andre.barbosa@ime.usp.br
许可信息
- 许可: MIT License
引用详情
- 首选引用:
@proceedings{DBLP:conf/propor/2024, editor = {Igor Cataneo Silveira, André Barbosa and Denis Deratani Mauá}, title = {Computational Processing of the Portuguese Language - 16th International Conference, {PROPOR} 2024, Galiza, March 13-15, 2024, Proceedings}, series = {Lecture Notes in Computer Science}, volume = {TODO}, publisher = {Springer}, year = {2024}, url = {TODO}, doi = {TODO}, isbn = {TODO}, timestamp = {TODO}, biburl = {TODO}, bibsource = {dblp computer science bibliography, https://dblp.org} }
数据结构
- 特征:
- id: 抓取页面的ID。
id_prompt+id应该是唯一的 - id_prompt: 作文的主题
- essay_title: 作文标题
- essay_text: 作文文本
- grades: 包含六个元素的列表,包含五个概念的每个等级的分数以及所有等级的总和
- essay_year: 作文的年份
- id: 抓取页面的ID。
- 实例数量:
- sourceAOnly:
- train: 227
- validation: 68
- test: 90
- sourceAWithGraders:
- train: 744
- validation: 195
- test: 216
- sourceB:
- full: 3219
- sourceAOnly:
- 数据分割:
- sourceAOnly: sourceA 数据
- sourceAWithGraders: sourceA 数据增强,带有评分者的评论。简而言之,每一行变成三行(原始评分加上两个评分者的结果)
- sourceB: sourceB 数据
数据考虑
- 已知限制:
- 伦理考虑: