ensemble-validation
收藏资源简介:
Learnrite Evaluation Data 是一个综合题库,旨在评估人工智能模型在印度公务员考试中的复杂、现实世界问题上的表现。该数据集包含多项选择题(MCQs),涵盖印度宪法、治理和行政职能等主题。由于内容的深度和细微差别,以及许多问题中内部因果一致性的要求,这使其成为一个特别具有挑战性的基准。数据集包括问题ID、问题文本、答案选项、预期正确答案和实际正确答案等列。该数据集适用于模型评估和基准测试,并采用CC BY 4.0许可。它包含78个问题,文件大小约为41 KB。其局限性包括专注于印度治理主题和MCQ格式。
Learnrite Evaluation Data is a comprehensive question bank designed to evaluate the performance of AI models on complex, real-world questions from the Indian civil service examinations. This dataset comprises multiple-choice questions (MCQs) covering topics such as the Indian Constitution, governance, and administrative functions. Owing to the depth and nuance of its content, as well as the requirement for internal causal consistency in many of its questions, it constitutes an especially challenging benchmark. The dataset includes columns such as question ID, question text, answer options, expected correct answer, and actual correct answer. This dataset is suitable for model evaluation and benchmarking, and is licensed under CC BY 4.0. It contains 78 questions with a file size of approximately 41 KB. Its limitations include a focus on Indian governance-related topics and the MCQ format.
Ensemble Evaluation Data
数据集概述
Ensemble Evaluation Data 是一个综合性的问题库,旨在评估 AI 模型在处理源自印度公务员考试的复杂、现实世界问题上的表现。该考试被广泛认为是全球最具挑战性的竞争性考试之一。数据集包含多项选择题(MCQs),涵盖印度宪法、治理和行政职能等主题。由于内容的深度和细微差别,以及许多问题中对内部因果一致性的要求,这使得它成为一个特别具有挑战性的基准。
关键特性
- 高难度级别:问题模型基于印度公务员考试,以其严谨性和所需知识的深度而闻名,使其成为测试高级 AI 模型的优秀基准。
- 内部因果一致性:许多问题涉及逻辑推理,并需要理解内部因果关系,这使得它们难以通过简单的模式识别来解决。这一方面测试了 AI 模型进行更深层次推理的能力,而不仅仅是依赖表面级别的匹配。
- 基准性能:作为数据集难度的证明,Claude 3.5 Sonnet 在该基准上取得了 73.1% 的分数,表明即使是先进的模型也面临显著挑战。
- AI 生成:数据集使用 Claude 3.5 Sonnet 生成。
数据集结构
数据集包含以下列:
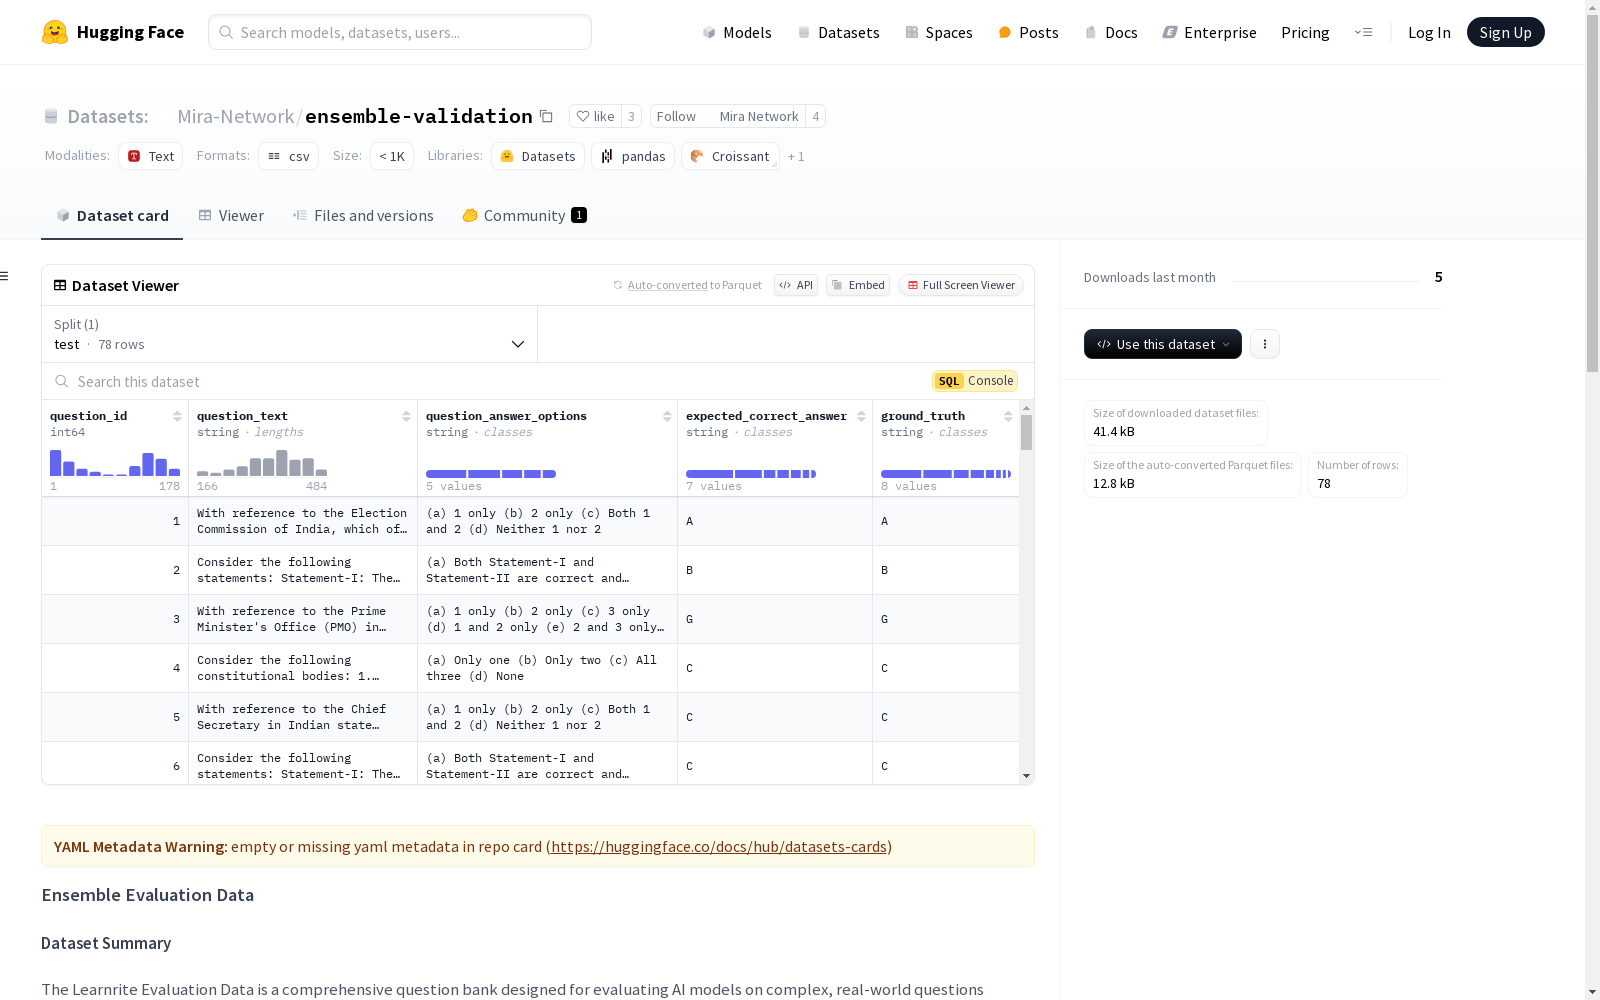
question_id:每个问题的唯一标识符(例如,0001, 0002)。question_text:问题的完整文本。question_answer_options:多项选择答案选项的完整文本。expected_correct_answer:正确答案选项(例如,A, B, C, D)。ground_truth:正确答案选项(例如,A, B, C, D.. INVALID)。
预期用途
该数据集特别适用于:
- 模型评估:评估语言模型在复杂、特定领域知识任务上的表现。
- 基准测试:为旨在提高输出准确性的 AI 系统提供具有挑战性的测试。
数据集大小
- 问题数量:78 个条目。
- 文件大小:约 41 KB。
局限性
- 数据集专注于与印度治理和宪法相关的问题,这可能限制其对更广泛领域的适用性。
- 多项选择题格式可能无法完全捕捉开放式推理任务的复杂性,但它仍然提供了对逻辑和事实理解的稳健测试。