
Shamus/Medical_Speech_Transcription_and_Intent
收藏官方服务:
资源简介:
该数据集来自Kaggle,由Paul Mooney贡献,包含8.5小时的音频和对应的文本,涉及常见医疗症状的描述。数据集通过多任务工作流创建,首先由贡献者根据给定症状编写文本描述,然后录制音频。需要注意的是,部分标签不正确,部分音频质量较差,建议在使用前进行清理。数据集包含音频和对应的转录文本。
This dataset is hosted on Kaggle and contributed by Paul Mooney. It includes 8.5 hours of audio recordings and their corresponding transcriptions, focusing on descriptions of common medical symptoms. The dataset was created via a multi-task workflow: initially, the contributor drafted textual descriptions based on given symptoms, then recorded the matching audio. It should be noted that some labels are incorrect and certain audio files have poor quality; thus, data cleaning prior to usage is highly recommended.
提供机构:
Shamus原始信息汇总
数据集概述
语言
- 英语
数据规模
- 1K<n<10K
内容描述
- 该数据集包含数千个关于常见医疗症状(如“膝盖疼痛”或“头痛”)的音频话语,总计超过8小时。
- 每个话语由个人贡献者根据给定的症状创建。
- 这些音频片段可用于训练医疗领域的对话代理。
数据创建过程
- 数据集通过多任务工作流程创建。
- 首先,贡献者编写描述症状的文本短语。
- 随后,为接受的文本字符串捕获音频话语。
注意事项
- 部分标签可能不正确,部分音频文件质量较差。
- 建议在训练任何机器学习模型之前对数据集进行清洗。
数据格式
- 包含音频话语及其对应的转录文本。
搜集汇总
数据集介绍
背景与挑战
背景概述
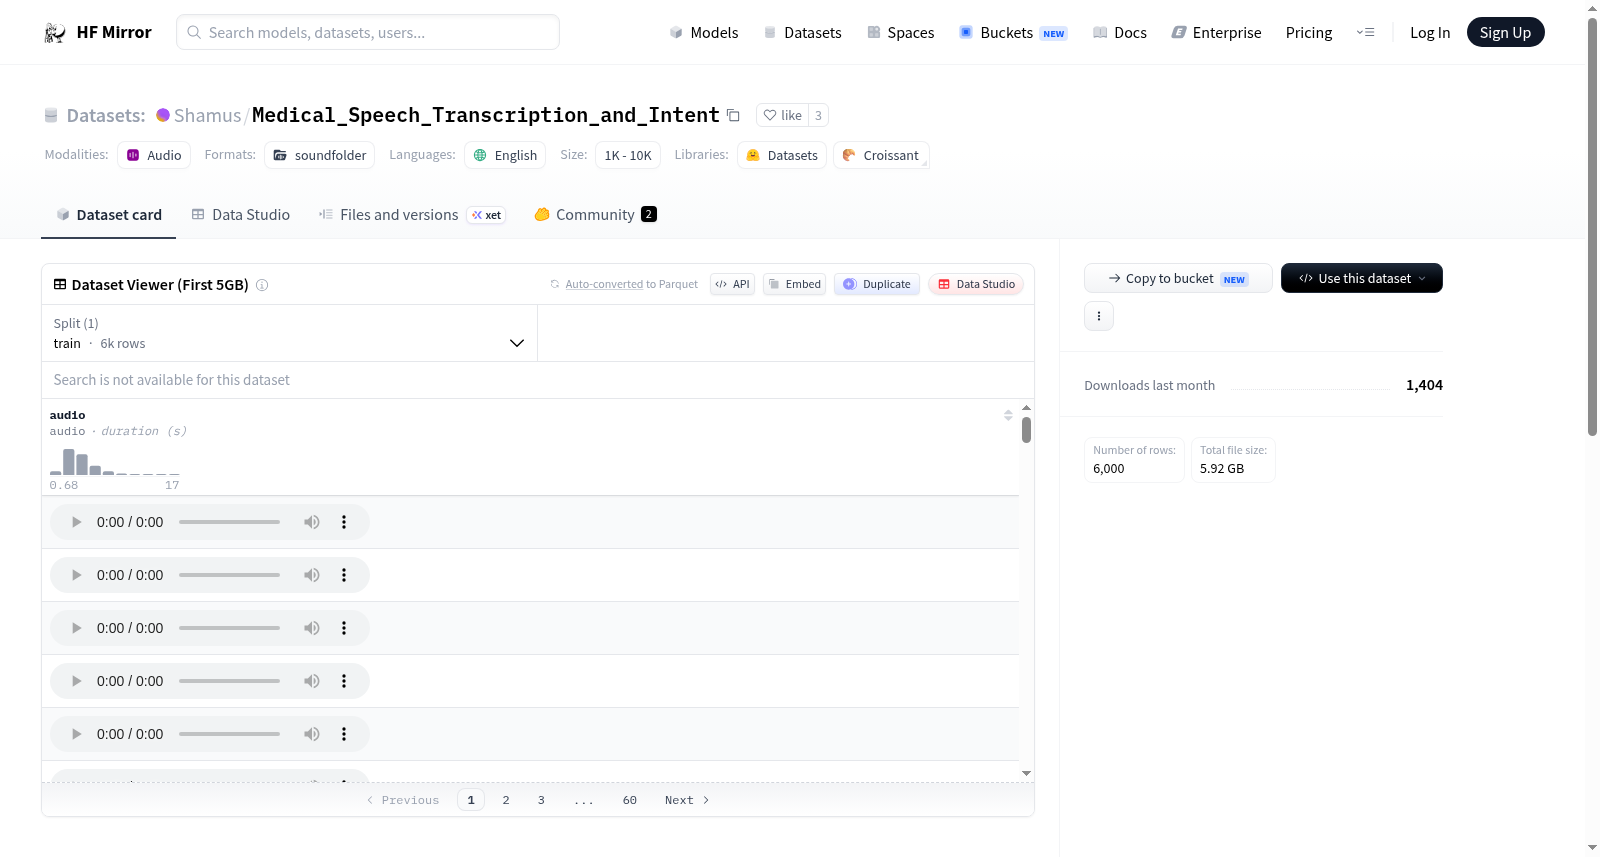
该数据集是一个医疗领域的音频转录数据集,包含约8.5小时的音频话语及其对应文本,覆盖常见医学症状(如头痛、膝盖疼痛),总规模为6000条数据、5.92GB。数据由人工贡献者生成,旨在训练医疗对话代理,但需注意部分标签可能错误且音频质量参差不齐,使用前建议清洗处理。
以上内容由遇见数据集搜集并总结生成


