
alexthomas4/highsub-classified-images
收藏官方服务:
资源简介:
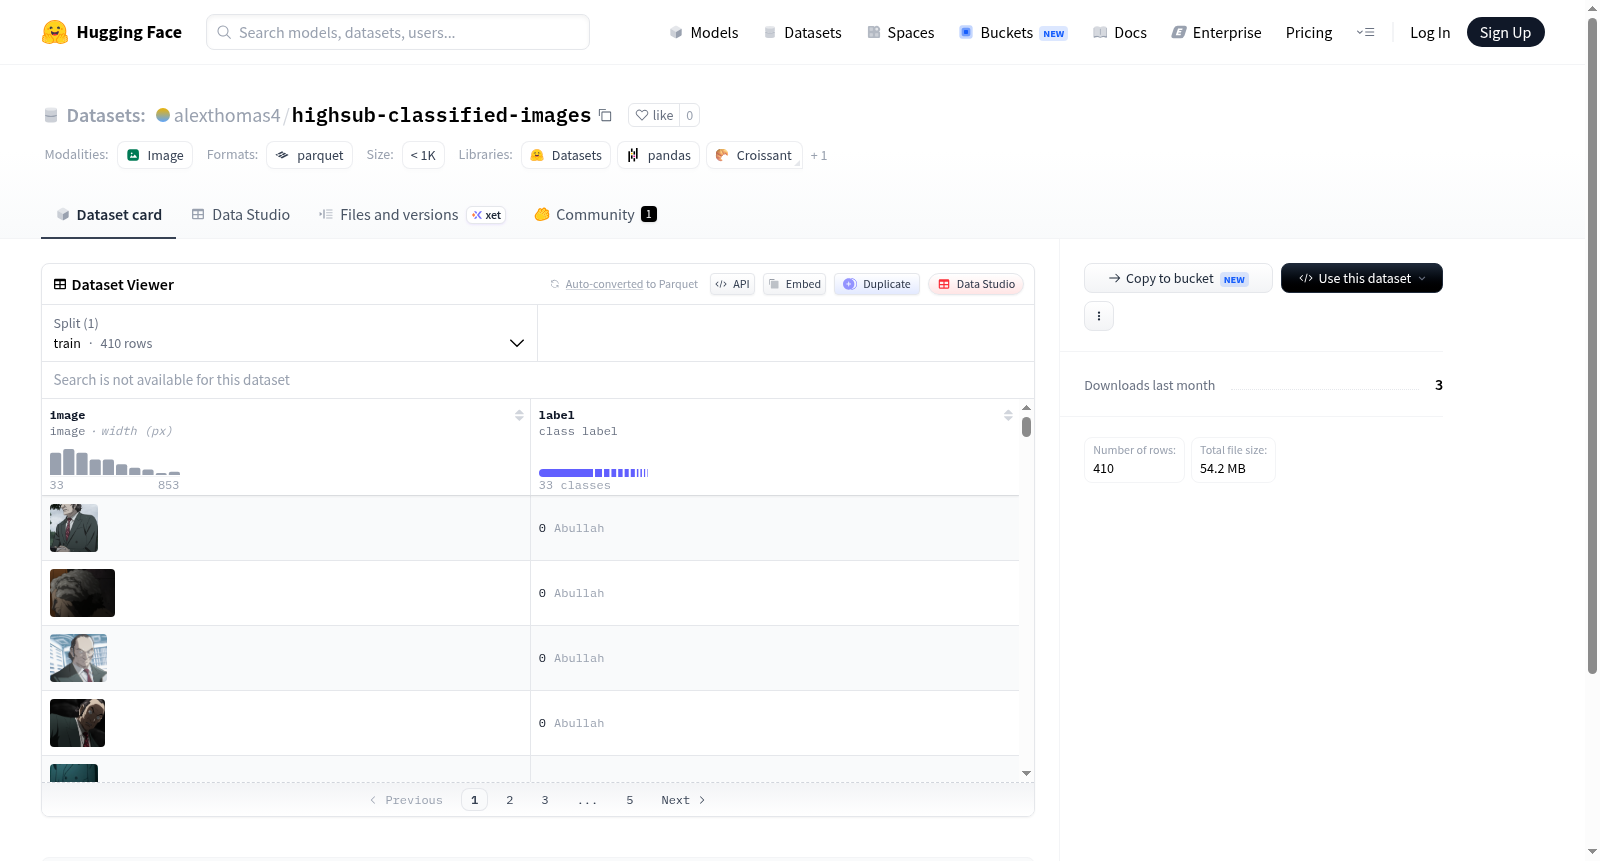
该数据集包含410个训练样本,每个样本由一个图像和一个标签组成。标签是一个类别标签,共有33个不同的类别,包括Abullah、Adolf、Anya等。数据集的总大小为54171170.0字节,下载大小为54191470字节。
该数据集包含410个训练样本,每个样本由一个图像和一个标签组成。标签是一个类别标签,共有33个不同的类别,包括Abullah、Adolf、Anya等。数据集的总大小为54171170.0字节,下载大小为54191470字节。
提供机构:
alexthomas4原始信息汇总
数据集概述
数据集信息
- 特征:
image: 图像数据label: 类别标签- 类别名称:
- 0: Abdullah
- 1: Adolf
- 2: Anya
- 3: Asta
- 4: Atom
- 5: Becky
- 6: Bond
- 7: Brando
- 8: Damian
- 9: Duncan
- 10: Epsilon
- 11: Franky
- 12: Gauche
- 13: Gesicht
- 14: Heracles
- 15: Kazuki
- 16: Kyutaro
- 17: Loid
- 18: Mimosa
- 19: Miri
- 20: Misaki
- 21: Nightfall
- 22: North #2
- 23: Ochanomizu
- 24: Pluto
- 25: Rei
- 26: Side Character
- 27: Taiga
- 28: Tenma
- 29: Uran
- 30: Yor
- 31: Yuno
- 32: Yuri
- 类别名称:
数据集划分
- 训练集:
- 名称: train
- 字节数: 54171170.0
- 样本数: 410
数据集大小
- 下载大小: 54191470
- 数据集大小: 54171170.0
配置
- 默认配置:
- 数据文件:
- 划分: train
- 路径: data/train-*
- 数据文件:
搜集汇总
数据集介绍
构建方式
在图像分类领域,精准识别特定角色是计算机视觉任务的重要分支。alexthomas4/highsub-classified-images数据集通过系统化收集和标注构建而成,共包含410张训练样本,覆盖33个细粒度类别,如Abullah、Adolf、Loid等日本动漫与影视作品中的角色。每个样本均以图像和标签对的形式存储,标签采用整数编码映射至对应角色名称,确保数据格式的统一性与可操作性。数据集以单一训练集形式发布,文件存储于data/train-*路径下,便于直接加载与解析。
特点
该数据集的显著特征在于其高细粒度的类别划分,涵盖33个不同角色,包括主要角色与次要角色(如Side Character),体现了对图像分类任务中长尾分布的关注。数据集规模虽小(仅410张图像),但类别多样性较高,部分类别仅含少量样本,这为研究小样本学习与类别不平衡问题提供了理想场景。此外,所有图像以统一格式存储,并借助Hugging Face Datasets库实现高效加载,支持用户快速开展模型训练与评估。
使用方法
使用该数据集时,推荐通过Hugging Face Datasets库进行加载,调用load_dataset('alexthomas4/highsub-classified-images')即可获取训练集。数据以图像张量和标签整数的形式返回,可直接输入至PyTorch或TensorFlow的DataLoader中。鉴于类别数量较多且样本分布不均,建议在训练前进行数据增强(如随机裁剪、翻转)以提升模型泛化能力,并采用加权损失函数或重采样策略应对类别不平衡。评估时,可计算每个类别的准确率与召回率,以全面衡量模型性能。
背景与挑战
背景概述
在动漫与漫画文化日益繁荣的背景下,角色识别成为计算机视觉领域一个兼具趣味性与挑战性的研究方向。alexthomas4/highsub-classified-images数据集由研究者于近年创建,聚焦于《间谍过家家》、《冥王》等热门作品中的33个高人气角色,涵盖主角与配角,旨在推动细粒度图像分类技术在虚构角色识别中的应用。该数据集包含410张训练图像,类别标签精细,如Loid、Yor、Pluto等,反映了对动漫角色特征差异性的深入挖掘。其影响力在于为多模态学习和文化计算提供了独特的数据支撑,促进了跨领域研究中对非现实对象的认知理解。
当前挑战
该数据集面临的核心挑战包括:1) 细粒度分类难题——角色间外观相似度高(如发型、服饰风格接近),导致类间差异微小,传统分类模型易混淆;2) 数据规模有限——仅410张图像且无验证/测试集,限制了深度学习模型的泛化能力与过拟合风险控制;3) 构建过程中的标注一致性挑战——角色名称涉及多语言(如日文罗马音与英文混用)及文化背景差异,需确保标注准确;4) 领域特定性——动漫角色常因剧情设定存在不同着装或表情变体,增加了特征提取的复杂性。
常用场景
经典使用场景
该数据集以高清晰度图像为媒介,汇聚了来自多部动漫与科幻作品的33个角色类别,涵盖如《间谍过家家》中的洛伊德与约尔、《阿童木》中的阿童木与乌兰等经典人物。其核心应用在于细粒度图像分类任务,研究者可借助该数据集训练深度学习模型,从视觉特征中精准区分外观相似的角色,例如区分发型、服饰或面部细节微妙的角色如“Gesicht”与“Pluto”。这一场景为跨作品角色识别提供了标准化基准,尤其适合验证卷积神经网络或视觉Transformer在复杂类间差异下的判别能力,推动图像分类算法在动漫领域的精细化发展。
解决学术问题
该数据集直面动漫角色识别中因画风多样、类间相似度高而导致的分类精度瓶颈。学术上,它解决了跨作品角色数据集稀缺的问题,为研究小样本学习、类别不平衡(如“主角”类样本远少于“Side Character”)下的模型鲁棒性提供了实验平台。通过提供高分辨率图像,它助力探索图像质量对分类性能的影响,并推动迁移学习在动漫领域的应用——例如,预训练于通用图像数据集(如ImageNet)的模型,在此数据集上的微调可揭示领域自适应中的特征迁移规律。其意义在于填补了动漫图像细粒度分类的标准化评估空白,为后续研究建立可复现的基准。
衍生相关工作
该数据集的发布催生了一系列相关研究,包括基于对比学习的动漫角色表征学习工作,其中研究者利用其类别多样性设计正负样本对,提升特征嵌入的判别性。此外,它被用于探索生成对抗网络(GAN)的角色风格迁移任务,如将真实人脸转换为动漫角色风格,或反之。在轻量级模型领域,该数据集成为MobileNet与EfficientNet在动漫场景下的性能测试床,推动了高效推理算法的设计。最后,它启发了多模态融合研究,例如结合角色名称文本与图像特征进行零样本分类,扩展了跨模态学习的边界,为动漫领域的人工智能应用奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


