
遇见数据集

UKPLab/AITDNA

收藏
Hugging Face2026-06-16 更新2026-06-14 收录
官方服务:

资源简介:

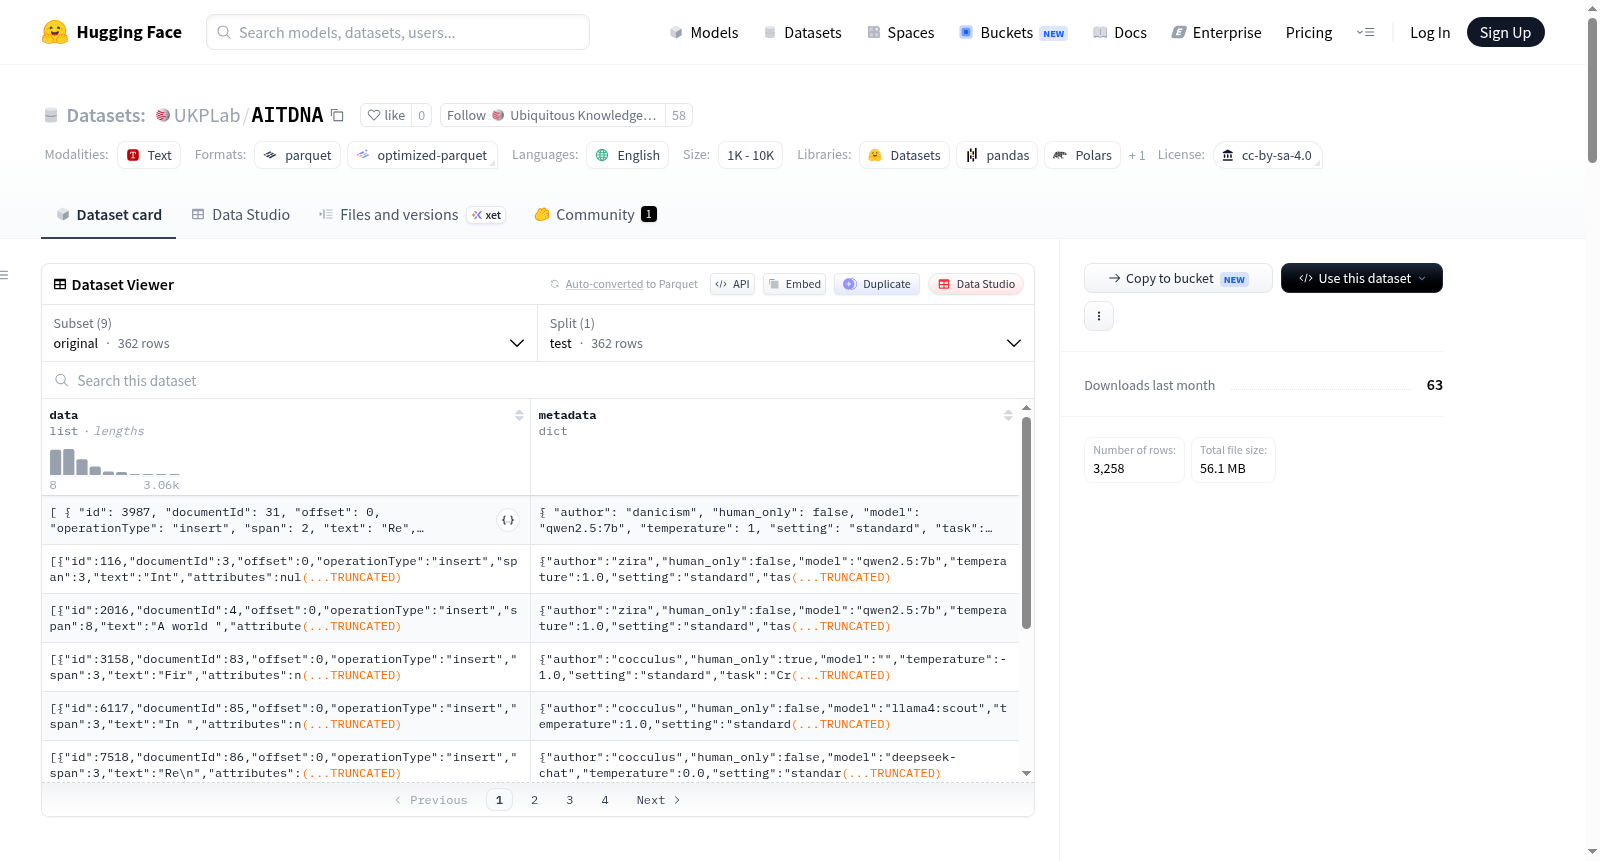
AITDNA(AI生成文本检测:概念无关)是一个收集自一系列用户研究的人类-AI交互数据集。该数据集包含:1. 每个文本的完整创建信息:原始用户编辑、模型建议、用户查询等。2. 根据论文中描述的不同AI生成文本概念(定义)的每个文本表示。当前支持的概念包括:- 文档级:每个文档一个标签(如果≥50%的令牌是AI生成的,则标记为AI)- 句子级:每个句子一个标签(如果≥50%的令牌是AI生成的,则标记为AI)- 令牌级:每个令牌一个标签- 边界级:通过找到最优分割索引将文本分为N部分(默认N=5)- 跨度级:相同作者身份的字符级跨度(例如,用户:GPUs are speci,AI:alized processors,...)- 基于意图的:基于预定义规则集的句子级标签,指定允许和禁止的用户查询类型。- 基于内容的:基于预定义规则集的句子级标签,指定允许和禁止的模型输出类型。- 基于成员资格的:基于参考人类语料库中N-gram出现情况的令牌级标签(默认N=2,参考人类语料库=数据集中仅人类部分)。语言:英语。许可证:gpl-2.0。

AITDNA (AI Generated Text Detection: Concept-Agnostic) is a human-AI interaction dataset collected from a series of user studies. This dataset contains: 1. Full creation information for each text: original user edits, model suggestions, user queries, etc. 2. Per-text annotations corresponding to the distinct AI-generated text concepts (definitions) described in the accompanying paper. Currently supported concepts include: - Document-level: One label assigned per document, marked as AI if ≥50% of its tokens are AI-generated - Sentence-level: One label assigned per sentence, marked as AI if ≥50% of its tokens are AI-generated - Token-level: One label assigned per token - Boundary-level: Split the text into N segments by identifying optimal segmentation indices (default N=5) - Span-level: Character-level spans with the same author identity (e.g., "User: GPUs are speci", "AI: alized processors", ...) - Intent-based: Sentence-level labels based on a predefined rule set that specifies allowed and prohibited user query types - Content-based: Sentence-level labels based on a predefined rule set that specifies allowed and prohibited model output types - Membership-based: Token-level labels based on the occurrence of N-grams in a reference human corpus (default N=2, reference human corpus = only the human-only portion of the dataset) Language: English License: GPL-2.0.
提供机构:
UKPLab
搜集汇总
数据集介绍
UKPLab/AITDNA 数据集图片
构建方式
AITDNA数据集通过一系列精心设计的人机交互用户实验构建而成,参与者涵盖学生、博士生及Prolific平台用户。每位实验对象在获得指导方针和主题建议后,分别撰写四篇文本:其中三篇借助大语言模型(LLM)完成,涵盖议论文、创意写作和说明文三种体裁;第四篇则为纯人工创作,体裁与前三者之一重复。以议论文和创意写作为例,参与者需从两个给定主题中选择进行创作。数据集完整记录了创作过程中的原始编辑、模型建议、用户查询等信息,并提供了基于不同AI生成文本定义(如文档级、句子级、令牌级、边界级、跨度级、意图驱动、内容驱动及成员关系驱动)的多层次标注,从而实现对AI生成文本的全面刻画。
特点
该数据集的核心特色在于其“不依赖先验概念”的设计理念,即超出简单二元分类,从八个不同定义维度(文档、句子、令牌、边界、跨度、意图、内容、成员关系)对文本中人机协作的贡献进行细粒度划分。每个样本均包含完整的数据字段(文本、作者、查询)及丰富的元数据(作者、是否为纯人工、模型名称、温度参数、设置场景、任务类型),为研究者提供了多角度剖析AI辅助写作过程的可能性。数据集的规模虽小(每个配置含362个样本),但其精细的结构化标注使其成为验证和推进AI文本检测算法鲁棒性的理想基准。
使用方法
使用AITDNA数据集时,可通过HuggingFace的datasets库便捷加载,支持指定不同的配置名称(如'sentence'、'document'、'boundary'等)以获取相应粒度的标注数据。默认加载的'original'配置会返回原始的用户编辑操作序列,适合进行深度的过程分析。加载后的数据以JSON对象形式呈现,每个对象包含'data'列表和'metadata'字典,其中'data'内的每个元素根据所选配置包含带作者标签的文本片段及对应的用户查询,而'metadata'则记录创作背景参数。研究者可直接通过DataLoader进行批量化处理,或根据具体需求自定义数据提取逻辑,灵活适配多种AI文本检测任务的训练与评估流程。
背景与挑战
背景概述
AITDNA(AI生成文本检测:概念无关)数据集由德国达姆施塔特工业大学UKP实验室于近期创建,旨在应对大型语言模型(LLM)广泛使用背景下AI生成文本检测的核心挑战。该数据集基于一系列用户研究,收集了人类与AI交互的完整创作过程信息,包括原始用户编辑、模型建议及用户查询等。其核心研究问题在于重新定义并评估在现实假设下AI生成文本的检测方法。通过支持文档级、句子级、词元级、边界级、跨度级、意图级、内容级及成员级等多种检测概念,AITDNA为AI文本检测研究提供了细粒度、多层次的标准化评估基准。该数据集在AI安全与可解释性领域具有重要影响力,推动了从简单二分类向多维度、上下文感知检测范式的转变。
当前挑战
AITDNA数据集所解决的领域问题核心在于AI生成文本检测的复杂性与模糊性。传统检测方法往往基于单一概念(如模型水印或统计特征),难以应对现实场景中人类与AI协作创作的混合文本,因此数据集首先面临的挑战是定义并统一多种检测概念,以覆盖从词元级到文档级的多样粒度需求。在构建过程中,挑战尤为显著:数据收集需设计严谨的用户研究,确保参与者(学生、博士生及众包人员)在自然协作情境下生成兼具真实性与多样性的文本;同时,需要精确记录每次编辑的归属(用户或模型)、操作类型(插入、删除等)及时间戳,以构建完整的创作轨迹。此外,数据集的匿名化处理与伦理合规性、不同检测概念标注的一致性,以及如何避免过拟合于特定LLM或写作场景,均构成了构建过程中的关键挑战。
常用场景
经典使用场景
AITDNA(AI生成文本检测:观念无关)数据集为研究AI生成文本的检测提供了多维度、精细化的标注资源。其最经典的使用场景在于评估和训练检测模型在不同“观念”下的鲁棒性,这些观念涵盖了从文档级、句子级、词元级到基于意图、内容、边界乃至成员身份的多样化划分。研究者可通过加载特定配置,如句子级或文档级标签,来测试模型对文本中AI参与度不一致的敏感性。这种设计使得AITDNA成为探究检测器能否超越简单“全有或全无”判断、理解文本中人类与AI协作复杂性的理想基准,尤其适用于那些需要识别部分AI贡献内容的现实场景。
衍生相关工作
AITDNA的推出催生了一系列围绕“部分AI文本检测”的衍生工作。研究者基于其多观念标注体系,开展了检测模型在边界分割、词元归属和意图理解任务上的适应性与改进研究。例如,衍生工作关注如何利用深度神经网络对混合作者文本进行内容重构与来源追溯,相关方法在AITDNA的跨度级配置上得到验证与优化。此外,该数据集为对比不同提示策略下AI输出痕迹的差异性提供了实证基础,推动了提示注入检测与模型指纹识别技术的发展。AITDNA还激发了关于标准化的讨论,促使领域内出现针对不同“观念”基准的统一评估框架,增强了结果的可比性。
数据集最近研究
最新研究方向
当前,大语言模型生成文本的检测研究正经历从粗粒度文档分类向细粒度、多维度判别范式的深刻转型。AITDNA数据集正是在这一前沿背景下应运而生,它通过精心设计的用户实验,捕捉了人机协同写作过程中完整的编辑痕迹、模型建议及用户查询,为超越简单二分类的“文本作者身份”判定提供了丰富素材。该数据集的核心创新在于首次系统性地囊括了八种不同的AI生成文本定义(如句子级、标记级、意图导向及基于N-gram隶属度的判别等),从而使得研究者能够在更贴近现实复杂场景——如文本混合创作、局部AI润色与人为改写交织——的条件下,评估与优化检测算法的鲁棒性与泛化能力。这一进展不仅有助于应对日益精密的AI文本滥用风险,也为人机协作写作的可信度评估开辟了崭新的实证路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

