
遇见数据集

agentscope-ai/ReMe_longmemeval_clean_s_v2

收藏
Hugging Face2026-07-20 更新2026-07-22 收录
官方服务:

资源简介:

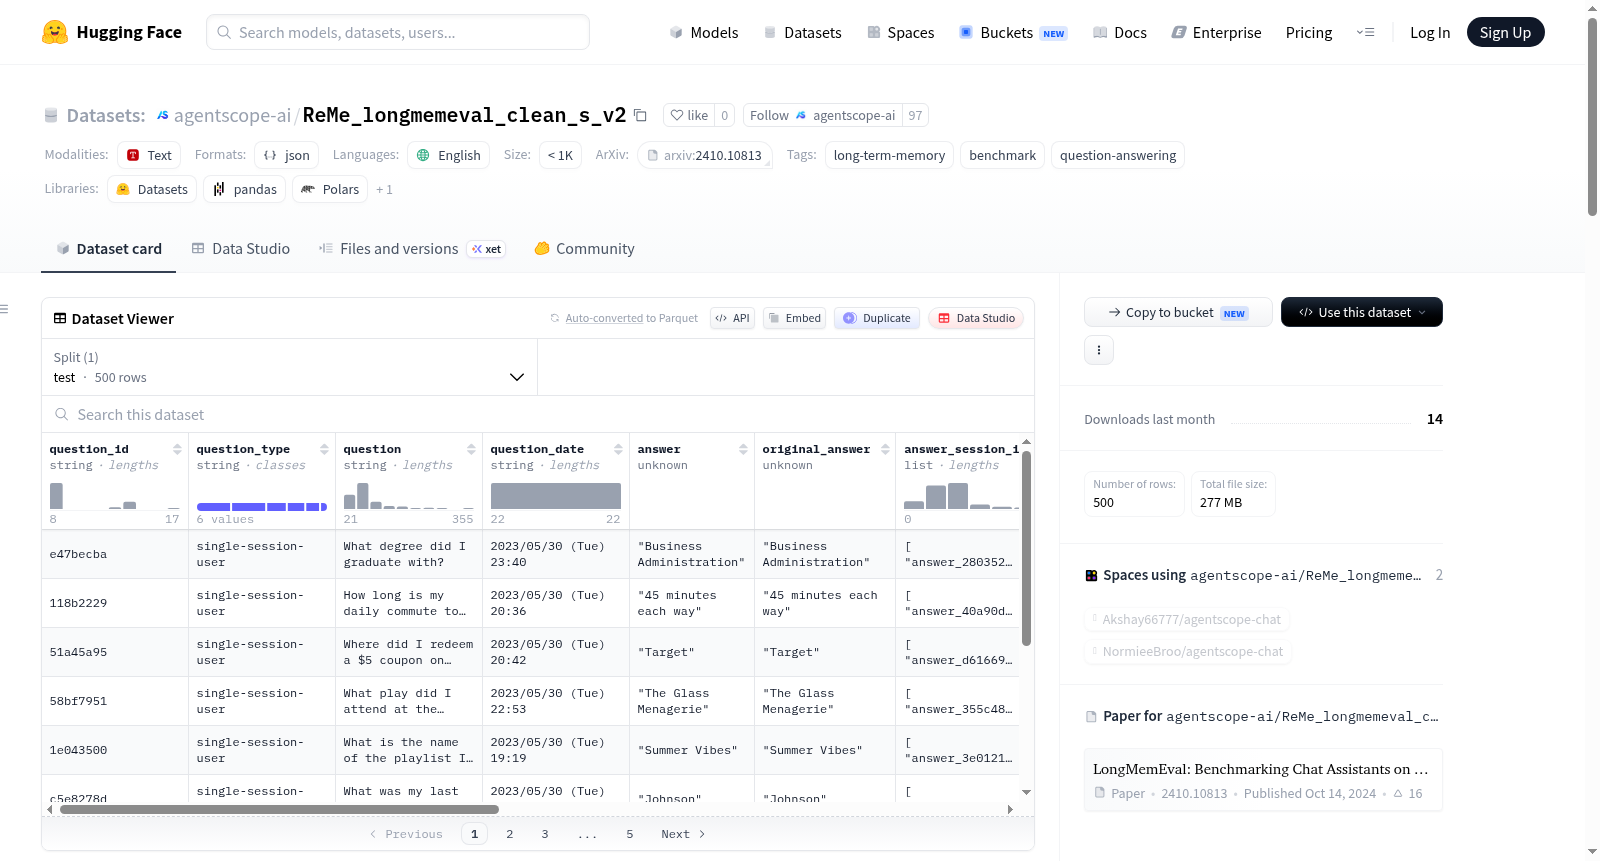
LongMemEval ReMe Cleaned-S 是 LongMemEval Cleaned-S 数据集的修正版本。它保留了原始问题和haystack会话,但将答案和支持会话的ground truth替换为来自final_groundtruth_cleaned_s.json的审核值。修正解决了不准确的答案和证据会话问题,包括证据发生在问题时间之后的情况,从而避免了未来信息泄露到评估中。数据集包含500条记录,涉及知识更新、多会话、单会话助手、单会话偏好、单会话用户和时间推理等多种问题类型。修正统计显示,15.4%的记录在修正字段上有所变化,包括答案和证据会话ID的调整。

LongMemEval ReMe Cleaned-S is a corrected version of the LongMemEval Cleaned-S dataset. It retains the original questions and haystack conversations, but replaces the answers and ground truth of the supporting conversations with reviewed values sourced from final_groundtruth_cleaned_s.json. The corrections address inaccurate answers and evidence conversations, including instances where the evidence occurred after the question's timestamp, thus preventing future information leakage during model evaluations. The dataset contains 500 records covering multiple problem types such as knowledge update, multi-turn conversations, single-turn assistant interactions, single-turn preference, single-turn user scenarios, and temporal reasoning. Correction statistics show that 15.4% of the records have changes in their corrected fields, including adjustments to answer and evidence conversation IDs.
提供机构:
agentscope-ai
搜集汇总
数据集介绍
agentscope-ai/ReMe_longmemeval_clean_s_v2 数据集图片
构建方式
ReMe_longmemeval_clean_s_v2数据集是在原始LongMemEval Cleaned-S版本基础上,经过严格人工审查与修正后形成的精炼基准。其构建过程以question_id为唯一标识进行一一映射,保留原始问题与对话(haystack sessions)内容,但将答案与支持性会话的ground truth替换为经过审核的`final_groundtruth_cleaned_s.json`中的值。修正主要针对不准确的答案和证据会话,尤其是证据时间晚于提问时间导致未来信息泄露的情况。生成后的数据集维持了上游的字段结构,并将修正后的`evidence_session_ids`写入`answer_session_ids`字段,确保兼容性。
使用方法
该数据集专为评估聊天助手的长期交互记忆能力而设计,可直接用于问答任务的基准测试。使用时,模型需读取用户的问题(question)以及前序多轮对话历史(haystack_sessions),并基于这些上下文生成答案。输出答案应与`answer`字段进行比对,同时可结合`answer_session_ids`验证模型对证据来源的检索准确性。由于数据格式与上游Clean-S版本兼容,研究者可无缝集成至现有LongMemEval评估流程中,直接替换测试文件即可运行。
背景与挑战
背景概述
在大型语言模型驱动的对话助手领域,如何评估模型对长期交互信息的记忆与推理能力已成为核心研究议题。现有基准测试如LongMemEval虽已构建起包含多轮对话历史与复杂问答任务的评估框架,但其标注答案与证据会话的准确性仍有待提升,尤其是跨时间线索的因果一致性常被忽视。ReMe_longmemeval_clean_s_v2数据集由研究人员于2024年基于LongMemEval Cleaned-S版本校正而来,聚焦于修正原始数据中因证据会话发生于提问时间之后而导致的未来信息泄露问题。该数据集保留原有500条测试记录及问答框架,通过人工审核与二次标注,替换了77条记录中不准确的答案与证据会话信息,特别针对时间推理类问题进行了严格清洗,从而为对话助手的长程记忆评估提供了更可靠的基准。这一工作对推动语言模型在持续对话、知识更新及跨会话推理等场景下的可信评估具有重要价值。
当前挑战
该数据集所应对的核心挑战源于对话助手领域长期记忆评估中的两大困境:其一,现有基准常因标注疏漏引入未来信息,导致模型性能被高估,尤其在涉及时间顺序推理与知识更新的问答任务中,证据会话与提问时间的错位会严重干扰评估结论的效度;其二,构建过程中面临证据线索稀疏性与多源会话结构复杂性的矛盾,使得对每个问题匹配严格时间一致且语义相关的支持会话极具难度。具体而言,本数据集在清洗时发现原始版本中有11.6%的记录存在证据会话错误、11.4%的答案需修正,且累计移除了129条无效证据引用,其中时间推理类问题受污染比例高达35.3%。此外,确保校正后的每条证据会话均存在于对应的对话会话池中,并维持原始问题类型分布与时间戳的完整性,也是数据构建过程中的显著工程挑战。
常用场景
经典使用场景
在长时记忆对话系统的研究领域,ReMe_longmemeval_clean_s_v2被广泛用作评估大型语言模型(LLM)在持续交互中记忆与检索能力的基准数据集。其经典使用场景包括测试模型能否准确回答基于历史对话片段的问题,特别是那些需要从多个会话中整合信息、理解用户偏好或追踪知识更新的复杂任务。例如,在单会话用户记忆、多会话推理以及时间推理等子任务中,研究者通过该数据集衡量模型是否能在不泄露未来信息的前提下,从庞大的对话线索中定位到正确的证据会话并给出精确回答。该基准的精心设计,尤其是对答案和证据的严格校正,确保了评估的公平性与科学性,使其成为长时记忆研究不可或缺的测试平台。
解决学术问题
该数据集核心解决了长时记忆评估中数据泄露与答案标注不一致的学术难题。原始LongMemEval基准中部分问题的答案或证据会话发生在提问时间之后,导致模型评价时获得了不应有的未来信息,从而虚高了性能。ReMe_longmemeval_clean_s_v2通过人工审核,修正了500条记录中77条(占15.4%)的错误标注,消除了129个跨越时间边界的证据引用。这一修正使得时间推理类问题的性能评估更加真实可信,推动了对话式AI在长期记忆机制、知识追踪和因果时序推理等方向的严谨研究。其意义在于,为学界提供了一份经得起时间检验的黄金标准数据,促进了长时记忆评估范式的规范化和可信度提升。
实际应用
在实际应用层面,该数据集直接服务于智能助手和推荐系统等需要维护长期用户记忆的产品。例如,个人虚拟助理可借助在此基准上优化的模型,准确回忆用户数月前偏好的电影类型或生活安排,从而提供更个性化的服务。电商平台的对话机器人利用数据集中的多会话推理能力,能在多次购物对话后精准推荐商品,提升用户黏性。此外,在客服系统中,模型通过时间推理任务学会辨别信息的新旧程度,避免将过时的用户资料用于当前决策。这些应用场景均依赖于该数据集所校验的、无信息泄露的稳健记忆模块,从而在真实环境中实现连续、自然且符合时间逻辑的人机交互。
数据集最近研究
最新研究方向
在长程对话记忆评估领域,ReMe_longmemeval_clean_s_v2数据集聚焦于纠正评测偏差,尤其是未来信息泄露与错误答案问题。前沿研究强调对记忆检索时间戳的严格约束,以确保模型仅在问题发生前积累的知识窗口内作答,避免时序谬误。该版本通过精细审查修正了15.4%的问答对,其中时间推理类问题纠错占比最高(35.3%),反映了学界对时序建模在记忆增强对话系统中核心地位的关注。这一修订不仅提升了LongMemEval基准的可靠性,也为评估大语言模型在持续交互中的记忆一致性、知识更新与反事实推理能力树立了更严苛的标准,推动了更贴近真实场景的长程记忆对话研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

