
遇见数据集

SINAI/ALIA-es-cultural-heritage-synthetic-instructions

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

ALIA西班牙文化与遗产合成指令语料库是一个西班牙语合成指令调优资源,基于ALIA项目采用Magpie方法创建。该数据集旨在训练和评估语言模型在文化遗产、数字人文和历史知识任务中的表现,具有自然语言变体和大规模监督。它包含748,480个实例,629,682,398个令牌,涵盖25种任务模态,包括遗产问答、真/假判断、主题/流派/时期分类、实体提取、摘要、简化以及档案分析等。数据生成过程遵循Magpie方法,模型首先生成用户侧查询(遗产问题、历史探究或档案任务),然后生成相应答案。语料库包含基于西班牙文化遗产文档(历史文本、博物馆目录、档案描述、学术遗产出版物)构建的规范性和自然变体提示,涵盖多样任务类型,如遗产问答、文化分类、实体提取、文本生成以及历史和遗产内容分析,并包含多种语言风格变体(正式、口语化、感叹式、电报式)。

The ALIA Spanish Cultural and Heritage Synthetic Instructions Corpus is a synthetic instruction-tuning resource in Spanish created under the ALIA project using the Magpie methodology. It was designed to train and evaluate language models in cultural heritage, digital humanities, and historical knowledge tasks with natural linguistic variation and large-scale supervision. It contains 748,480 instances, 629,682,398 tokens, and 25 task modalities (heritage QA, true/false, topic/genre/period classification, entity extraction, summarization, simplification, and archival analysis). The dataset contains synthetic cultural heritage and history instruction-response pairs generated with instruction models and curated through a multi-step quality pipeline. The generation process follows Magpie, where the model first produces a user-side query (heritage question, historical inquiry, or archival task) and then generates the corresponding answer. The corpus includes both canonical and naturally varied prompts built from Spanish cultural heritage documents (historical texts, museum catalogs, archival descriptions, academic heritage publications). It includes diverse task types such as heritage QA, cultural classification, entity extraction, text generation, and analysis of historical and patrimonial content, with multiple linguistic style variations (formal, colloquial, exclamatory, telegraphic).
提供机构:
SINAI
搜集汇总
数据集介绍
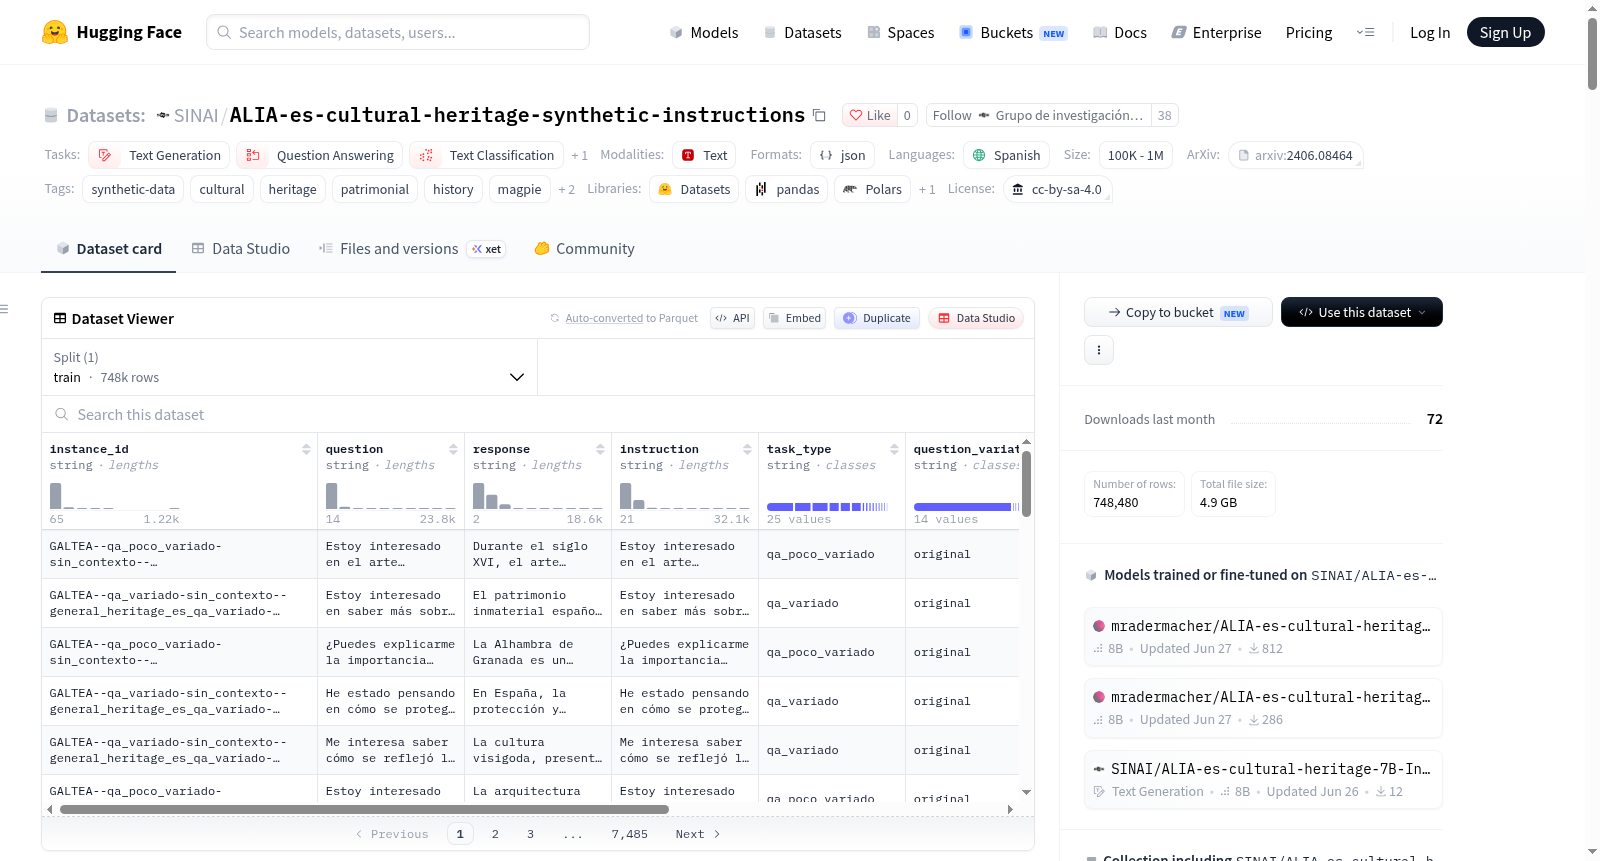
SINAI/ALIA-es-cultural-heritage-synthetic-instructions 数据集图片
构建方式
在西班牙文化遗产数字化与语言模型领域知识的双重驱动下,该语料库依托ALIA项目框架,采用Magpie生成方法构建。具体而言,以蕴含历史学、艺术史、档案实践及数字人文知识的文化遗产系统提示为引导,由Phi-4与Gemma-4-31B-it等模型补全用户侧查询,生成博物馆记录、历史分析、文化分类等任务指令,继而由Phi-4、Gemma-4-31B-it、Qwen3.6-35B-A3B及Kimi-K2.6等模型从多元专业视角生成应答。生成结果经Galtea平台基于大语言模型的质量策略过滤筛选,并系统注入口语化、电报式、感叹式等语言变体,最终整合为面向指令微调的标准化语料。
特点
该数据集呈现出规模宏大与任务多样性的显著特征,共包含748,480条实例与逾6.29亿词元,覆盖文化遗产问答、真伪判断、主题与时期分类、实体抽取、摘要生成、文本简化及档案分析等25种任务模态。其语言风格并非拘泥于单一范式,而是兼容正式、口语、感叹、电报及含拼写变异等多元表达,其中原始风格占75%,其余为系统化变异。任务分布以问答与分类为核心,qa_V_F占比最高,达21.26%,忠实映射了文化遗产领域知识获取与鉴别的实际需求。
使用方法
该数据集可通过HuggingFace datasets库便捷加载,用户既能一次性载入完整训练集进行指令微调,亦能启用流式读取模式以应对大规模文件的处理需求。加载后,每条实例以结构化字段呈现,涵盖实例标识、问题、应答、指令文本、任务类型、问题变异风格及生成模型等元数据,便于研究者按任务类型或风格进行筛选与子集构建。其典型应用场景包括西班牙语文化遗产大模型的指令微调、遗产与历史问答系统开发、数字人文与档案文本分析、文化实体识别与分类以及历史内容的摘要与简化等。
背景与挑战
背景概述
西班牙语文化遗产与历史知识的智能化处理长期受制于高质量领域语料的匮乏,既有资源多聚焦通用文本,难以支撑数字人文与档案分析等专业任务。在此背景下,SINAI研究团队依托西班牙ALIA国家项目,采用Magpie合成指令方法,于2026年构建了ALIA西班牙语文化遗产合成指令语料库。该数据集含748,480条实例、逾6.29亿词元,覆盖遗产问答、实体抽取、分类与摘要等25种任务模态,通过多模型协同生成与Galtea质量过滤,为西语文化遗产大模型的指令微调提供了大规模领域监督,显著推动了数字人文与历史知识计算的发展。
当前挑战
该数据集所应对的领域问题在于文化遗产知识的机器理解与生成,其核心难点在于遗产概念的阐释高度依赖语境、历史脉络与专业术语,且需兼顾问答、分类、抽取等多元任务形态。构建过程中的挑战同样突出:合成语料需在缺乏人工标注的条件下保证事实准确性与领域相关性,多模型生成易引入风格趋同与知识偏差;源文档的OCR噪声与档案格式残留亦会污染上下文;此外,如何在系统施加口语、电报体、感叹体等语言变异的同时避免语义漂移,并平衡问答与分类任务占比、缓解对主流机构遗产的过度表征,均构成持续性的技术难题。
常用场景
经典使用场景
在西班牙文化遗产与数字人文领域,该数据集最经典的使用场景在于对文化传承大语言模型进行指令微调,使其胜任遗产问答、历史推理与档案文本解析等任务。依托Magpie方法生成的七十四万余条指令-响应对,覆盖问答、真假判断、主题与时期分类、实体抽取、摘要与简化等二十五种任务模态,模型得以在真实语义变化中学习西班牙语遗产知识的表达与推理,从而推动文化遗产智能服务系统的构建。
解决学术问题
该数据集有效回应了文化遗产与数字人文研究中长期存在的领域语料匮乏与标注成本高昂问题。通过大规模合成指令监督,它缓解了西班牙语遗产问答、文化实体识别、历史内容分类等任务训练数据不足的困境,并为模型在历史推理与档案分析中的表现评估提供了统一基准,对促进遗产知识的计算化理解与跨机构知识共享具有实质性意义。
衍生相关工作
围绕该数据集,已衍生出面向西班牙文化遗产的指令微调模型与评估基准,并推动了基于Magpie方法的领域合成数据生成流程在数字人文中的迁移应用。相关工作中,ALIA项目下的遗产语料库与Galtea质量过滤策略共同构成可复用的数据构建范式,为后续历史与档案文本分析任务提供了方法参照与训练资源。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

