amitkedia/Financial-Fraud-Dataset
收藏资源简介:
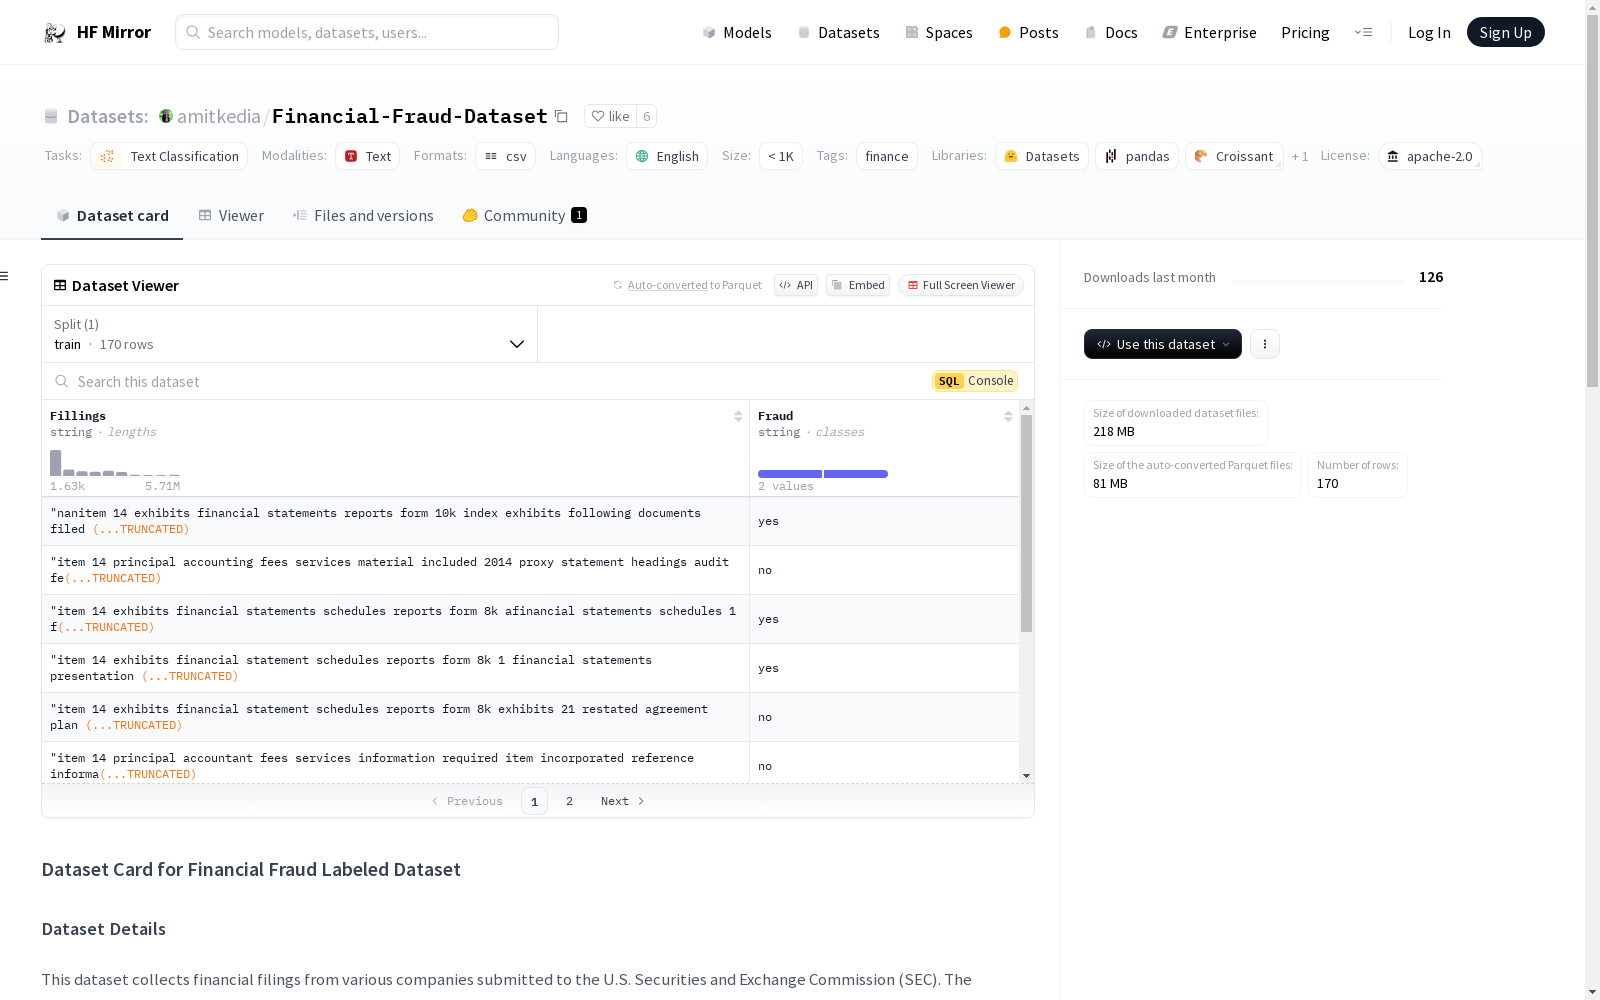
该数据集收集了提交给美国证券交易委员会(SEC)的各种公司的财务文件。数据集包括85家涉及欺诈案件的公司和同等数量的未涉及欺诈活动的公司。文件列包含公司管理层讨论与分析(MD&A)以及公司在SEC网站上列出的多年财务报表。该数据集用于使用多种大型语言模型(LLMs)和传统机器学习模型进行金融欺诈检测的研究。
This dataset gathers financial documents of various companies filed with the U.S. Securities and Exchange Commission (SEC). It comprises 85 companies involved in fraud cases and an equal number of firms free from fraudulent activities. The document columns within the dataset contain Management's Discussion and Analysis (MD&A) as well as multi-year financial statements of the companies as disclosed on the SEC website. This dataset is employed for research on financial fraud detection leveraging multiple large language models (LLMs) and traditional machine learning models.
数据集卡片:Financial Fraud Labeled Dataset
数据集详情
概述
该数据集收集了来自美国证券交易委员会(SEC)提交的多家公司的财务报告。数据集包括85家涉及欺诈案件的公司和85家未涉及欺诈活动的公司。报告列包括公司多年来的MD&A和财务报表等信息。
用途
该数据集用于通过多种大型语言模型(LLMs)和传统机器学习模型进行财务欺诈检测的研究。
数据集来源
直接使用
python from datasets import load_dataset dataset = load_dataset("amitkedia/Financial-Fraud-Dataset")
超出范围的使用
- 该数据集主要用于学术研究。
- 文本需要进一步清理以进行处理。
- 数据集仅涵盖美国证券交易委员会(SEC)的欺诈案例,仅限于美国公司。
数据集结构
数据集结构请参阅数据集查看器。
数据集创建
请参阅论文了解数据集创建的详细信息。
创建动机
帮助金融行业开发最佳模型以检测欺诈活动,从而为政府和银行节省数十亿美元。
数据收集和处理
请参阅论文了解数据收集和处理的详细信息。
数据集卡片作者