
OALL/details_royallab__ZephRP-m7b
收藏官方服务:
资源简介:
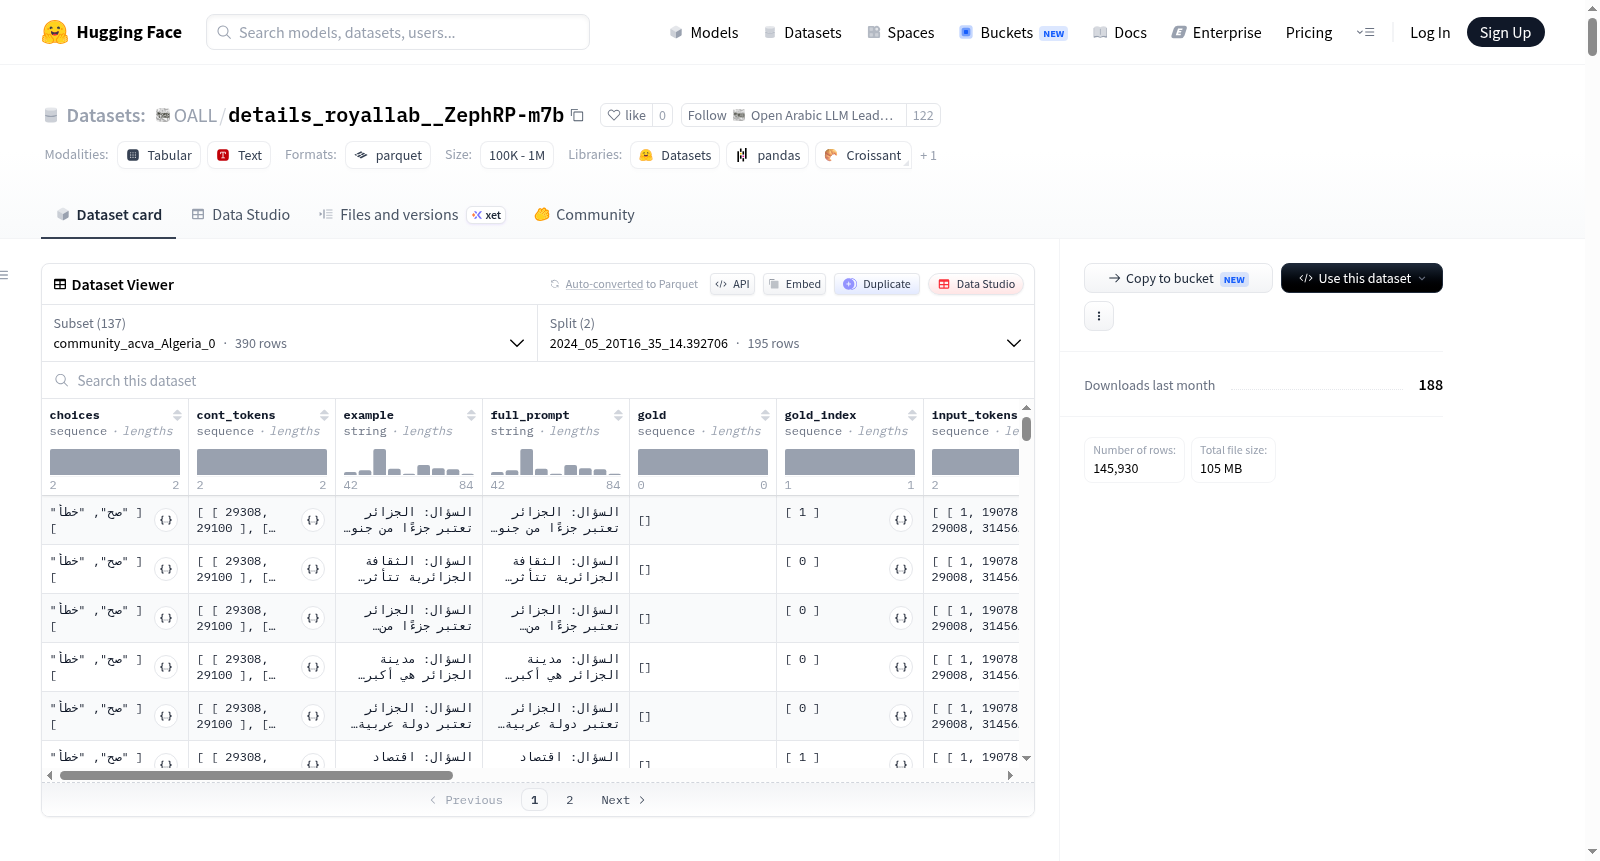
该数据集是在模型 royallab/ZephRP-m7b 的评估运行期间自动创建的。数据集由136个配置组成,每个配置对应一个被评估的任务。数据集是从1次运行中生成的,每次运行在每个配置中表示为特定的分割,分割名称使用运行的时间戳。train 分割始终指向最新的结果。一个名为 results 的额外配置存储了所有运行的聚合结果。README 还提供了如何使用 Python 中的 datasets 库加载数据集的示例。
该数据集是在模型 royallab/ZephRP-m7b 的评估运行期间自动创建的。数据集由136个配置组成,每个配置对应一个被评估的任务。数据集是从1次运行中生成的,每次运行在每个配置中表示为特定的分割,分割名称使用运行的时间戳。train 分割始终指向最新的结果。一个名为 results 的额外配置存储了所有运行的聚合结果。README 还提供了如何使用 Python 中的 datasets 库加载数据集的示例。
提供机构:
OALL原始信息汇总
数据集概述
数据集名称
- Evaluation run of royallab/ZephRP-m7b
数据集描述
- 自动创建于模型评估运行期间,具体为royallab/ZephRP-m7b模型的评估。
- 包含136个配置,每个配置对应一个评估任务。
- 数据集由1次运行生成,每次运行作为一个特定的分割,分割名称使用运行的时间戳。
- 存在一个额外的配置“results”,存储所有运行的聚合结果。
数据集加载示例
python from datasets import load_dataset data = load_dataset("OALL/details_royallab__ZephRP-m7b", "lighteval_xstory_cloze_ar_0", split="train")
最新结果
- 提供最新结果,包括多个任务的评估数据。
结果详情
- 结果包括多个社区和任务的评估指标,如准确率(acc_norm)和标准误差(acc_norm_stderr)等。
- 每个社区和任务的结果均详细列出,涵盖从社区文化到学术知识的广泛领域。
搜集汇总
数据集介绍
构建方式
该数据集是为评估模型royallab/ZephRP-m7b而自动生成的产物,其构建过程依托于自动化评估框架。数据集包含136个配置项,每一项均对应一个独立的评估任务。这些配置源自一次完整的评估运行,每次运行的结果以时间戳为标识,作为特定分割存储在对应配置中。其中,“train”分割始终指向最新一次运行的结果。此外,数据集还专门设置了一个名为“results”的配置,用于汇总存储该次运行的所有聚合结果,从而形成一个结构清晰、易于追溯的评估记录体系。
特点
此数据集的核心特色在于其精细化的任务划分与结果追踪能力。136个配置项覆盖了广泛的语言理解与知识推理任务,从针对阿拉伯文化与历史的细粒度问答,到涵盖多学科知识的阿拉伯语MMLU基准测试,乃至情感分析、方言识别等任务,展现了极高的评估维度广度。每个配置项内部,通过时间戳分割机制,使得不同时间点的评估结果得以并存与比较,为模型的迭代改进提供了纵向追踪的便利。这种设计不仅记录了模型的绝对性能,更刻画了其在不同领域与任务上的能力轮廓。
使用方法
用户可通过HuggingFace的datasets库便捷地加载与使用本数据集。具体而言,调用load_dataset函数,并指定数据集名称(OALL/details_royallab__ZephRP-m7b)及目标任务的配置名称,例如“lighteval_xstory_cloze_ar_0”,即可获取该任务的最新评估细节。通过设置split参数为“train”,用户能够访问最新一次运行的结果。若需回溯历史评估数据,则可依据时间戳格式的分割名称进行加载。此外,通过加载“results”配置,用户可以一站式获取所有任务的聚合统计指标,如准确率及其标准误差,便于进行宏观的性能分析。
背景与挑战
背景概述
在自然语言处理领域,多语言与跨文化模型的评估日益成为研究焦点,特别是针对低资源语言如阿拉伯语的性能评测。该数据集由OALL团队于2024年5月创建,旨在系统评估royallab/ZephRP-m7b模型在阿拉伯语相关任务上的表现。数据集涵盖136个配置,对应不同评测任务,包括阿拉伯文化知识、方言理解、情感分析及多学科考试等,其核心研究问题在于探究模型对阿拉伯语语境与文化的理解深度。该数据集的发布为阿拉伯语NLP模型的标准化评估提供了重要基准,对推动多语言模型在特定文化场景下的公平性与鲁棒性研究具有显著影响力。
当前挑战
该数据集面临的核心挑战在于多维度评测任务的复杂性。首先,在领域问题层面,模型需同时处理跨文化常识推理、方言变体识别及专业学科知识等异构任务,这对模型的泛化能力与知识广度构成严峻考验。其次,构建过程中,数据集需整合来自不同社区(如acva、alghafa)的多样化任务,确保各配置间的评估标准一致性与结果可比性。此外,阿拉伯语丰富的形态变化与地域性表达差异,增加了数据标注与任务定义的难度,而评测结果中部分任务(如高级数学、医学)的低准确率也揭示了模型在专业领域知识上的深层局限。
常用场景
经典使用场景
在自然语言处理与多语言模型评估的交叉领域中,OALL/details_royallab__ZephRP-m7b数据集作为模型性能的细粒度评测基准,其经典使用场景聚焦于对阿拉伯语大语言模型进行系统性能力检验。该数据集涵盖了136个配置项,每个配置对应一项特定的评估任务,横跨阿拉伯文化常识、方言理解、现代标准阿拉伯语(MSA)理解以及多学科知识(如医学、法学、物理学等)等多个维度。研究者通过加载该数据集中的特定任务配置,可精确衡量模型在阿拉伯语语境下的零样本或少样本推理能力,尤其适用于探究模型在低资源语言环境中的泛化表现与知识迁移效率。
解决学术问题
该数据集直面阿拉伯语大语言模型评估中缺乏标准化、多维度的评测体系这一关键学术难题。传统评估基准多集中于英语等高资源语言,导致阿拉伯语模型的能力边界难以被全面刻画。OALL/details_royallab__ZephRP-m7b通过整合阿拉伯文化特定任务(如阿拉伯历史、伊斯兰法体系、方言识别)与通用学科任务(如抽象代数、临床知识),系统性地揭示了模型在跨领域、跨文化场景下的知识短板与偏差。其意义在于为低资源语言模型的公平性、鲁棒性及文化适应性研究提供了可复现的量化依据,推动了多语言NLP评估范式的演进。
衍生相关工作
基于该数据集衍生的经典工作主要集中于阿拉伯语模型的多任务学习与评估框架创新。例如,研究者利用其136个任务配置构建了阿拉伯语大模型的性能图谱,提出了针对低资源语言的文化感知微调策略(如融合阿拉伯文化语料的指令微调)。另一些工作则聚焦于评估结果的可解释性分析,通过对比不同任务上的准确率差异,揭示了模型在阿拉伯历史与伊斯兰法律等专业领域的知识盲区,进而催生了面向阿拉伯语的知识增强检索(KER)与领域自适应预训练方法。这些衍生研究共同推动了阿拉伯语NLP从通用评估向文化定制化评估的转型。
以上内容由遇见数据集搜集并总结生成


