PersianSciQA-Extractive
收藏资源简介:
PersianSciQA-Extractive数据集是一个大规模资源,包含超过10,000个波斯语问题-答案对,专为科学领域的提取式问题回答任务而设计。该数据集基于safora/PersianSciQA数据集构建,并使用Gemini 2.5 Pro模型生成答案。数据集分为训练集、验证集和测试集。
PersianSciQA-Extractive is a large-scale resource containing over 10,000 Persian question-answer pairs, specifically designed for extractive question answering tasks in the scientific domain. This dataset is constructed based on the safora/PersianSciQA dataset, with its answers generated using the Gemini 2.5 Pro model. The dataset is split into training, validation, and test sets.
PersianSciQA-Extractive 数据集概述
数据集简介
PersianSciQA-Extractive 是一个大规模波斯语问答数据集,包含超过10,000个问答对,专门用于科学领域的抽取式问答任务。
基本属性
- 许可证:CC BY-SA 4.0
- 语言:波斯语 (fa)
- 任务类型:抽取式问答、科学文本处理
数据来源
基于 safora/PersianSciQA 原始数据集构建,仅选择相关性评分最高(3分)的样本。
答案生成方法
使用 Gemini 2.5 Pro 模型通过程序化方式生成答案,模型被要求仅基于提供的上下文回答问题,若上下文无相关信息则输出 "CANNOT_ANSWER"。
数据集结构
数据格式
每个样本为 JSON 对象,包含以下字段:
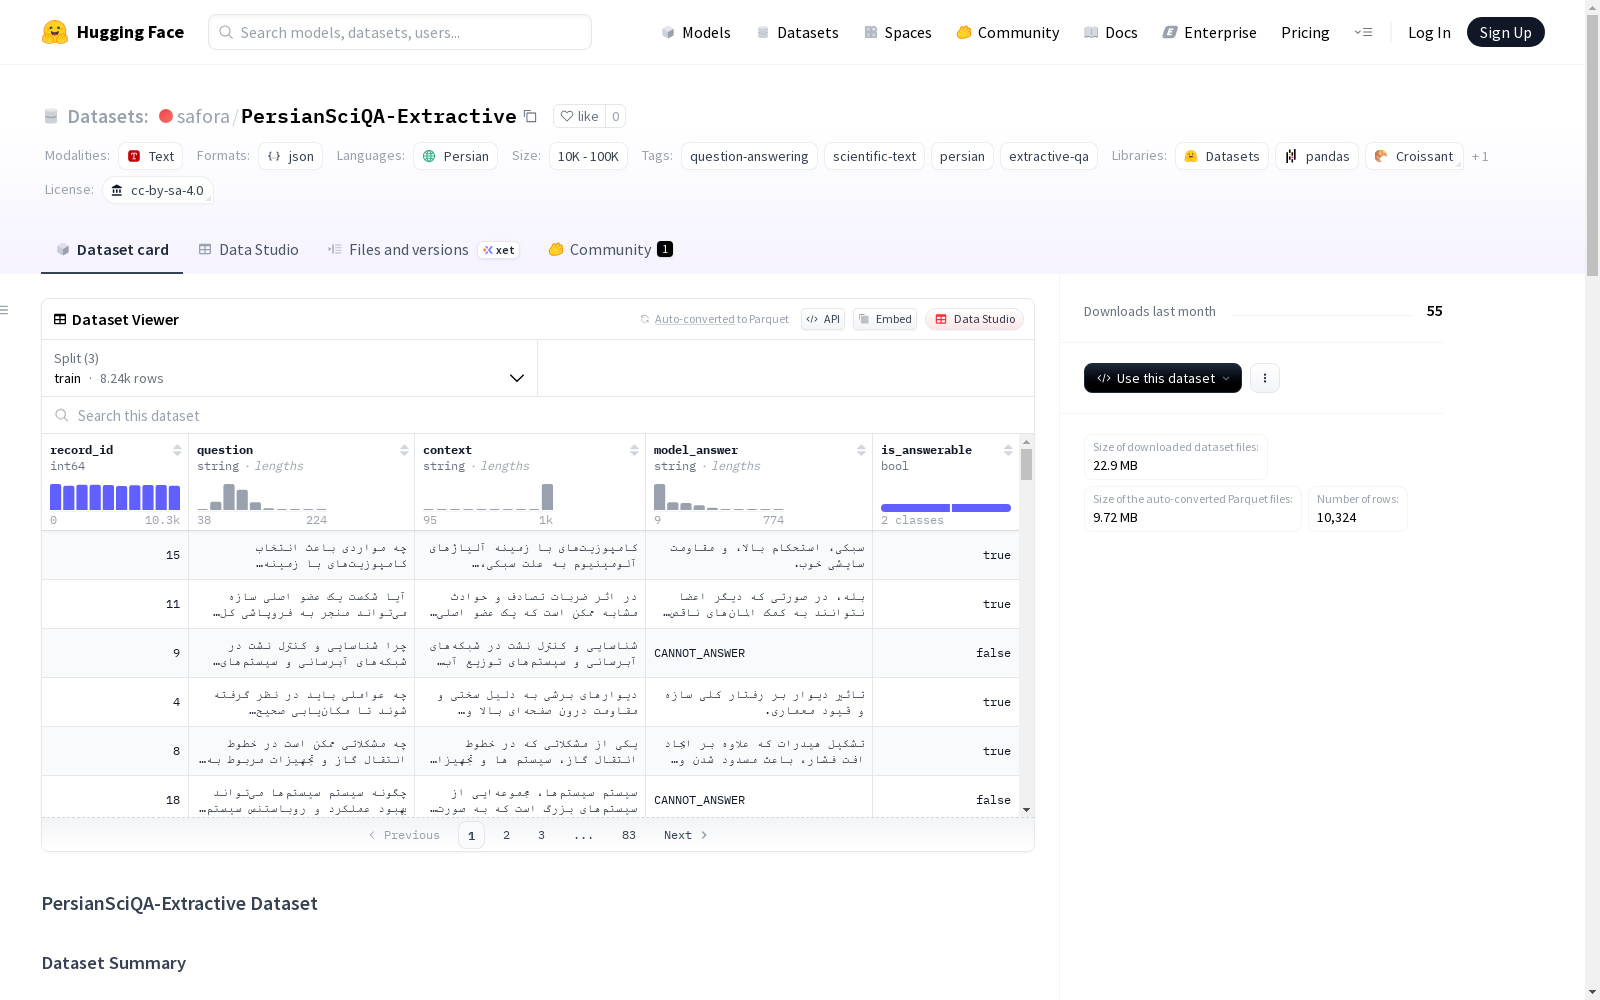
record_id:唯一标识符(整数)question:波斯语问题(字符串)context:波斯语科学摘要(字符串)model_answer:AI生成的答案或 "CANNOT_ANSWER"(字符串)is_answerable:是否可回答的标志(布尔值)
数据划分
采用基于源摘要的分组划分方法:
- 训练集:80% 的记录
- 验证集:10% 的记录
- 测试集:10% 的记录
引用信息
如需使用本数据集,请引用原始论文和本仓库:
@misc{safora2025persiansciqa_extractive, author = {Aghadavoud Jolfaei, Safoura}, title = {PersianSciQA-Extractive}, year = {2025}, publisher = {Hugging Face}, journal = {Hugging Face repository}, howpublished = {https://huggingface.co/datasets/safora/PersianSciQA-Extractive}, }