
遇见数据集

FluidInference/musan

收藏
Hugging Face2025-08-02 更新2025-09-13 收录
官方服务:

资源简介:

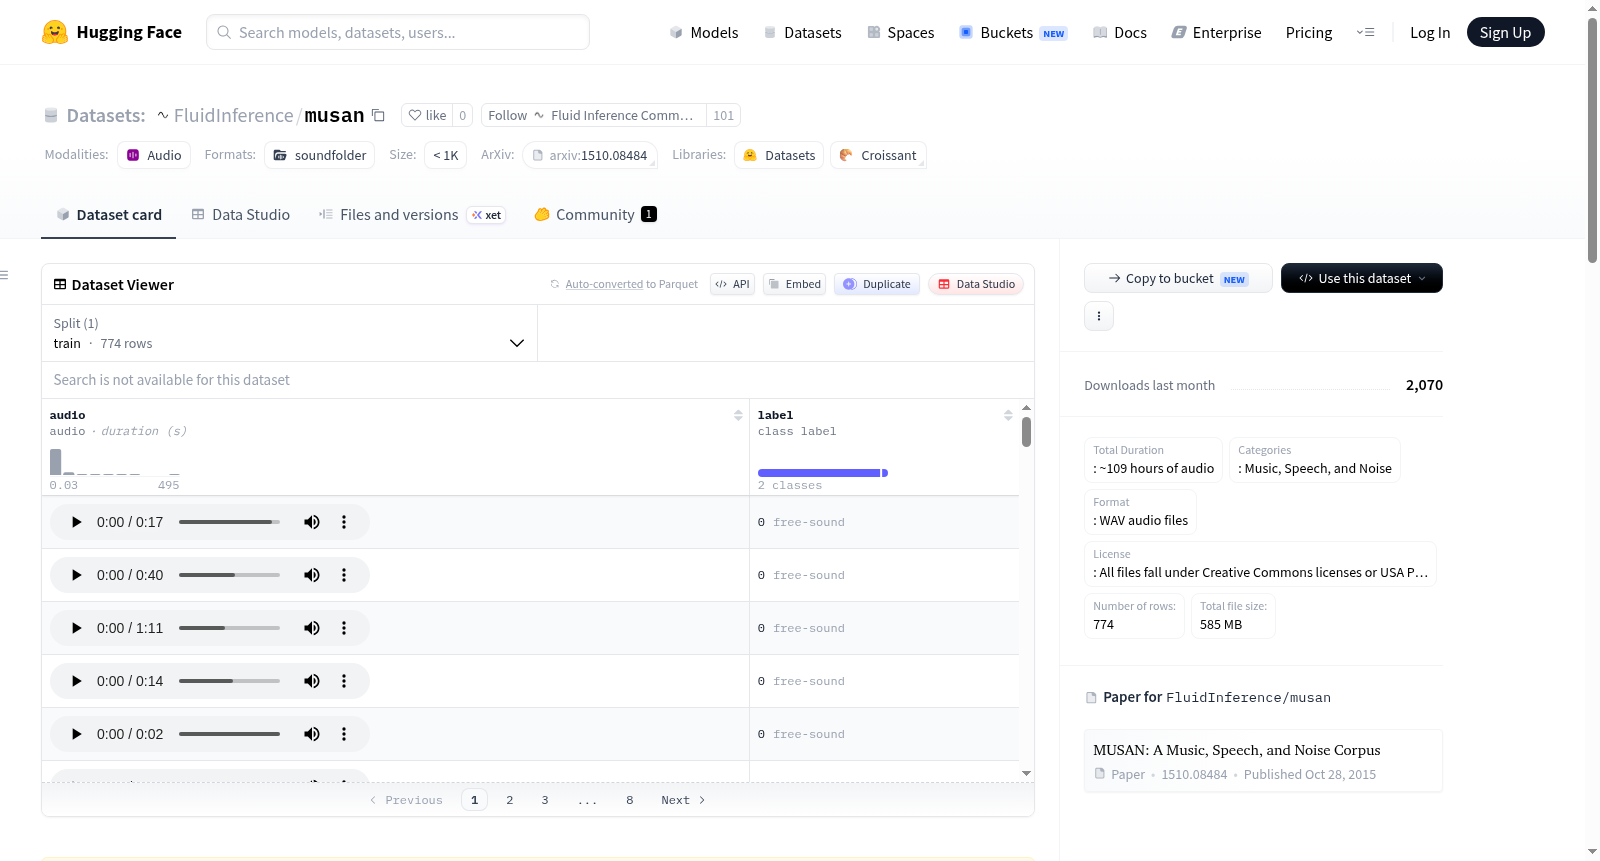
MUSAN是一个包含音乐、语音和噪声录音的语料库,设计用于训练用于语音活动检测和音乐/语音区分的模型。这个综合性的收集适用于各种音频处理任务。数据集总时长约为109小时,包含音乐、语音和噪声三个类别,音频格式为WAV。音乐类别包括古典、流行/摇滚、爵士等子类别;语音类别主要是英语,包含不同演讲者朗读书籍和美国政府记录;噪声类别包括环境声音和技术噪音等。所有文件都遵循Creative Commons授权或美国公有领域(无商业使用限制)。

MUSAN is a corpus of music, speech, and noise recordings designed for training models for voice activity detection and music/speech discrimination. The dataset comprises approximately 109 hours of audio across three categories: Music, Speech, and Noise, in WAV format. The Music category includes subcategories such as Classical, Pop/Rock, Jazz, etc., sourced from the Free Music Archive, Jamendo, and others. The Speech category is primarily in English, featuring various speakers reading books and government proceedings from sources like LibriVox and US Government recordings. The Noise category consists of environmental sounds and technical noises from Free Sound and other sound effect collections. All files in this corpus are available under Creative Commons licenses or in the USA Public Domain, with no restrictions on non-commercial use.
提供机构:
FluidInference
搜集汇总
数据集介绍
FluidInference/musan 数据集图片
构建方式
MUSAN数据集由David Snyder等人精心构建,旨在为语音活动检测与音乐/语音判别任务提供训练资源。其语料库涵盖音乐、语音与噪声三大类别,总时长约109小时。音乐部分约42小时,源自Free Music Archive与Jamendo等平台,细分为古典、流行、爵士等子类,包含器乐与声乐作品。语音部分约60小时,主要来自LibriVox公共领域有声读物及美国政府录音,以英语为主,涵盖多位朗读者。噪声部分约7小时,采集自Free Sound及音效合集,包括环境声与技术噪声。所有音频均以WAV格式存储,并遵循知识共享许可或美国公共领域授权,确保无商业使用限制。
使用方法
研究者可直接从HuggingFace平台加载FluidInference/musan数据集,利用其预划分的类别进行模型训练与评估。典型应用场景包括语音活动检测、音乐/语音分类及噪声鲁棒性增强。使用时需注意各子目录的许可文件,确保符合Creative Commons或公共领域条款。推荐将音频文件按需重采样至统一采样率,并配合数据增强策略如随机噪声叠加以提升模型泛化能力。对于学术引用,应参考原始论文(arXiv:1510.08484)以尊重创作者贡献。
背景与挑战
背景概述
MUSAN数据集由David Snyder、Guoguo Chen和Daniel Povey于2015年创建,旨在为语音活动检测和音乐/语音判别任务提供训练资源。该数据集整合了约109小时的音频,涵盖音乐(42小时)、语音(60小时)和噪声(7小时)三大类别,其构建依托Free Music Archive、LibriVox等公开资源,所有音频均遵循Creative Commons许可或美国公共领域协议。作为音频处理领域的基准数据集,MUSAN在推动鲁棒性语音识别、环境噪声抑制及多模态音频分析研究中发挥了关键作用,被广泛用于评估模型在复杂声学环境下的泛化能力。其开源特性与结构化设计为后续研究(如语音分离、声学事件检测)提供了标准化评估平台,影响力持续延伸至深度学习驱动的音频AI领域。
当前挑战
MUSAN数据集面临的核心挑战包括:1) 领域问题层面,语音活动检测与音乐/语音判别需应对真实场景中噪声类型多样(如非平稳环境声)、音乐与语音频谱重叠等难题,现有模型在低信噪比或动态背景噪声下易出现误判;2) 构建过程中,音频来源的异构性(采样率、编码格式差异)和标注一致性(如噪声类别的模糊边界)增加了数据预处理复杂度,部分噪声片段时长过短(<1秒)限制了模型对短时事件的捕捉能力;此外,版权许可的分散性(不同子目录需单独验证)与公共领域资源的时效性(部分录音年代久远)可能引入数据偏差,影响模型对现代声学特征的适应性。
常用场景
经典使用场景
MUSAN数据集作为音频处理领域的重要资源,其最经典的使用场景在于为语音活动检测(VAD)和音乐/语音区分任务提供训练与评估的基础数据。该数据集精心收录了约109小时的音频素材,涵盖音乐、语音和噪声三大类别,其中音乐部分包含古典、流行、爵士等多样风格,语音部分源自LibriVox有声读物与美国政府录音,噪声部分则囊括环境音与技术噪音。研究者可基于此构建鲁棒的音频分类模型,尤其适用于需要区分语音与非语音信号的真实场景,如智能音箱的唤醒词检测或会议系统的语音分割。数据集的结构化设计使得它成为训练神经网络处理复杂音频混合信号的理想选择,其丰富的样本多样性确保了模型在跨域应用中的泛化能力。
解决学术问题
在学术研究层面,MUSAN数据集有效解决了音频信号处理中多个长期存在的挑战。其一,它缓解了语音活动检测模型在噪声环境下性能退化的问题,通过提供多样化的噪声样本,研究者可模拟真实世界的干扰条件,从而设计出更具鲁棒性的VAD算法。其二,针对音乐与语音的自动区分这一基础性难题,该数据集提供了明确标注的语料,支持监督式学习方法的探索,推动了音频事件检测领域的发展。其三,MUSAN的公开许可与规范化组织方式降低了学术复现的门槛,使得不同团队的研究成果可在统一基准下进行比较。这一数据集的发布不仅填补了高质量多类别音频语料库的空白,还促进了基于深度学习的音频分析技术从理论走向实践,为后续研究奠定了坚实的实验基础。
实际应用
在实际应用层面,MUSAN数据集的价值体现在多个前沿技术领域。在智能语音助手系统中,它被用于训练噪声抑制模块,使设备能在嘈杂环境中准确捕捉用户指令,提升人机交互的自然度。在自动字幕生成与媒体内容分析中,该数据集辅助开发音乐与语音分离模型,从而实现音频内容的智能标注与检索。此外,在安防监控领域,基于MUSAN训练的音频事件检测模型能够识别异常声响,如玻璃破碎或警报声,为智能安防系统提供可靠信号。医疗健康场景中,该数据集还可用于构建听诊辅助工具,通过区分心音与环境噪声来支持远程诊断。这些应用充分展现了MUSAN作为通用音频基准语料库的广泛适配性,其跨场景迁移能力使其成为工业界部署音频AI系统的关键资源。
数据集最近研究
最新研究方向
在语音与音频处理领域,MUSAN数据集作为音乐、语音与噪声的综合性语料库,其前沿研究方向聚焦于鲁棒性语音活动检测与音乐/语音判别模型的训练优化。随着远程会议、智能语音助手及音频内容分析等应用的蓬勃发展,如何从复杂声学环境中精准分离语音信号成为核心挑战。MUSAN凭借其涵盖古典、流行等多种音乐风格、约60小时的多样化语音录音及7小时环境噪声的丰富构成,为构建抗噪能力强的深度学习模型提供了关键基准。近期研究倾向于利用该数据集探索多任务学习框架,例如结合时域与频域特征增强语音端点检测精度,或通过对比学习提升音乐与语音的区分度,这些工作直接推动了更可靠的语音交互系统与自动音频标注技术的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

