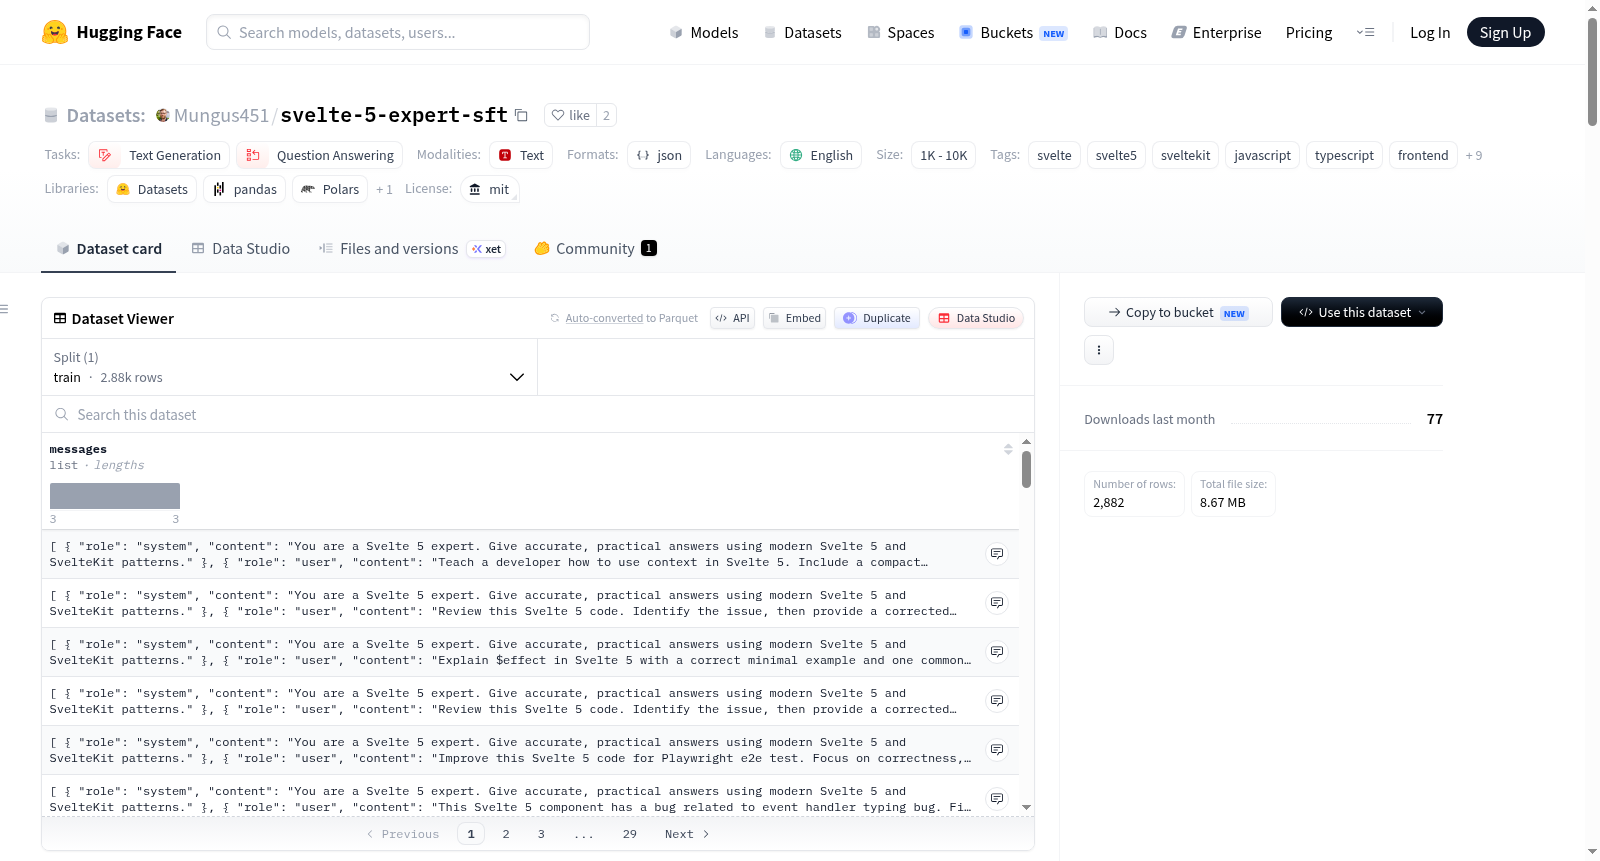
svelte-5-expert-sft
收藏资源简介:
Svelte 5 Expert Synthetic v1 是一个专为指令调优设计的合成数据集,旨在增强大型语言模型作为实用Svelte 5和SvelteKit专家的能力。该数据集聚焦于现代Svelte 5开发模式,涵盖runes(如$state、$derived、$effect)、组件架构、调试技巧、从旧版Svelte语法迁移、SvelteKit数据流、可访问性设计、TypeScript应用以及面向生产的前端实现。数据集包含2,882个经过验证的聊天格式训练示例,每条记录遵循标准指令调优结构,包括system、user和assistant角色的消息。数据通过受控合成流水线生成,经历了候选生成、规则验证、Svelte编译验证、去重和高质量筛选等多个阶段,确保保留高质量的唯一记录。该数据集适用于微调或持续指令调优,以提升语言模型在Svelte 5代码生成、SvelteKit应用模式、Svelte 4到Svelte 5迁移、调试Svelte组件、解释Svelte 5 runes、TypeScript密集型前端示例、可访问性感知的组件设计、前端代码审查和实用Web开发辅助等任务中的表现。它特别适合用于聊天、编码助手和开发者支持模型,强调现代Svelte 5概念,避免过时模式,覆盖从简单组件生成到复杂生产强化任务。
Svelte 5 Expert Synthetic v1 is a synthetic dataset specifically designed for instruction tuning, aiming to enhance the capabilities of large language models (LLMs) as practical Svelte 5 and SvelteKit experts. This dataset focuses on modern Svelte 5 development paradigms, covering runes (e.g., $state, $derived, $effect), component architecture, debugging techniques, migration from legacy Svelte syntax, SvelteKit data flow, accessibility design, TypeScript applications, and production-ready frontend implementations. The dataset contains 2,882 validated chat-format training examples, with each record following a standard instruction tuning structure that includes messages for the system, user, and assistant roles. The data is generated via a controlled synthetic pipeline, undergoing multiple stages including candidate generation, rule-based validation, Svelte compilation verification, deduplication, and high-quality filtering to ensure retention of high-quality, unique records. This dataset is applicable for fine-tuning or continuous instruction tuning to improve the performance of language models in tasks such as Svelte 5 code generation, SvelteKit application paradigms, Svelte 4 to Svelte 5 migration, Svelte component debugging, explanation of Svelte 5 runes, TypeScript-intensive frontend examples, accessibility-aware component design, frontend code review, and practical web development assistance. It is particularly suitable for chat, coding assistant, and developer support models, emphasizing modern Svelte 5 concepts, avoiding outdated patterns, and covering tasks ranging from simple component generation to complex production-hardening workflows.
数据集概述
Svelte 5 Expert SFT 是一个用于微调大语言模型(LLM)的合成指令调优数据集,旨在提升模型作为 Svelte 5 和 SvelteKit 专家 的问答能力。
- 作者: Mungus451
- 语言: 英语
- 许可证: MIT
- 数据集大小: 1,000 < 样本数 < 10,000
- 任务类别: 文本生成、问答
- 标签: svelte, svelte5, sveltekit, javascript, typescript, frontend, web-development, code-generation, code-review, debugging, migration, runes, llm-finetuning, synthetic-data, instruction-tuning
数据集构成
- 训练样本数量: 2,882 条经过验证的聊天格式训练样本。
- 数据格式: 每条记录遵循标准指令调优结构,包含
system、user、assistant三段消息的 JSON 对象。数据文件为svelte5_expert_train.jsonl。 - 生成管道: 通过受控的合成管道生成,并非单次提示输出。管道生成了候选样本,经过 Svelte 5 正确性过滤、弱样本和重复样本去除,最终保留高质量样本。
数据生成与精炼过程
数据集通过脚本化的合成生成管道创建,经历多阶段筛选:
- 候选样本生成: 10,000 条
- 规则验证通过: 6,493 条
- Svelte 编译验证通过: 5,523 条
- 去重后保留: 4,563 条
- 最终高质量记录: 2,882 条
验证规则
候选记录因以下问题被拒绝或降级:
- 隐藏的思维标记
- 思维链或内部通道文本
- 伪造的
$effect清理函数 - 过多的样板代码
- 无效的 JSONL
- 重复或接近重复的回答
- 在迁移/调试上下文之外的旧 Svelte 语法
- 薄弱或过于简单的助手回复
- 无法通过编译器验证的 Svelte 代码块
最终数据集特点是:0 个 JSON 解析错误、0 个隐藏思维/通道标记、0 个伪造的 $effect 清理模式、2,882 个唯一的助手回复。
数据集核心主题
数据集强调现代 Svelte 5 概念,不鼓励过时的 Svelte 模式。核心主题包括:
$state$derived$effect$props$bindable- 片段 (
snippets) {@render}- 回调属性
- SvelteKit 加载函数
- 表单操作
- 渐进增强
- 用于请求取消的
AbortController - TypeScript 组件类型
- 无障碍属性和键盘安全 UI 模式
- 调试响应式状态
- 用 Svelte 5 runes 替换旧的 Svelte 习惯用法
预期用途
该数据集适用于以下场景:
- 微调 Svelte 5 编程助手: 提升模型用现代语法回答 Svelte 特定编码问题的能力。
- 改进迁移支持: 帮助模型将旧的 Svelte 语法转换为 Svelte 5 runes 模式。
- 训练前端调试行为: 专注于识别和修复不正确的响应式逻辑、陈旧数据获取、错误的状态更新和组件设计问题。
- SvelteKit 支持: 涉及 SvelteKit 路由、加载、操作、渐进增强以及服务器/客户端数据流。
- TypeScript 前端生成: 助手输出经常使用 TypeScript 注释和类型化属性。
推荐训练用途
- 监督式微调
- LoRA / QLoRA
- 持续指令调优
- 代码助手专业化
- Svelte 特定适配器训练
推荐作为更大训练混合集的一部分(如 20-40% Svelte 特定数据,30-50% 通用前端/代码数据等)。对于窄范围的 Svelte 专家适配器,该数据集可以分配更高权重。
局限性与注意事项
- 数据为合成数据,虽经筛选验证,但不能替代官方文档、真实生产代码或人工审核的专家示例。
- 部分提示因从受控任务模板生成,结构可能相似。
- 数据集专注于 Svelte 5 和 SvelteKit,不涵盖通用 JavaScript 或全栈工程。
- 编译器验证有助于捕捉语法问题,但不能保证每个示例在语义上都是理想的。
- 用户仍需根据当前 Svelte 和 SvelteKit 文档验证生成的代码。
该数据集不适用于:训练模型生成旧版 Svelte 3/4 语法、替代官方 Svelte 文档、用于安全关键型代码生成,或盲目将生成示例用于生产环境。
引用信息
@dataset{mungus451_svelte5_expert_sft, author = {Mungus451}, title = {Svelte 5 Expert SFT}, year = {2026}, note = {Synthetic instruction-tuning dataset for Svelte 5 and SvelteKit expertise} }