
遇见数据集

zzzrw/GEM-250K

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

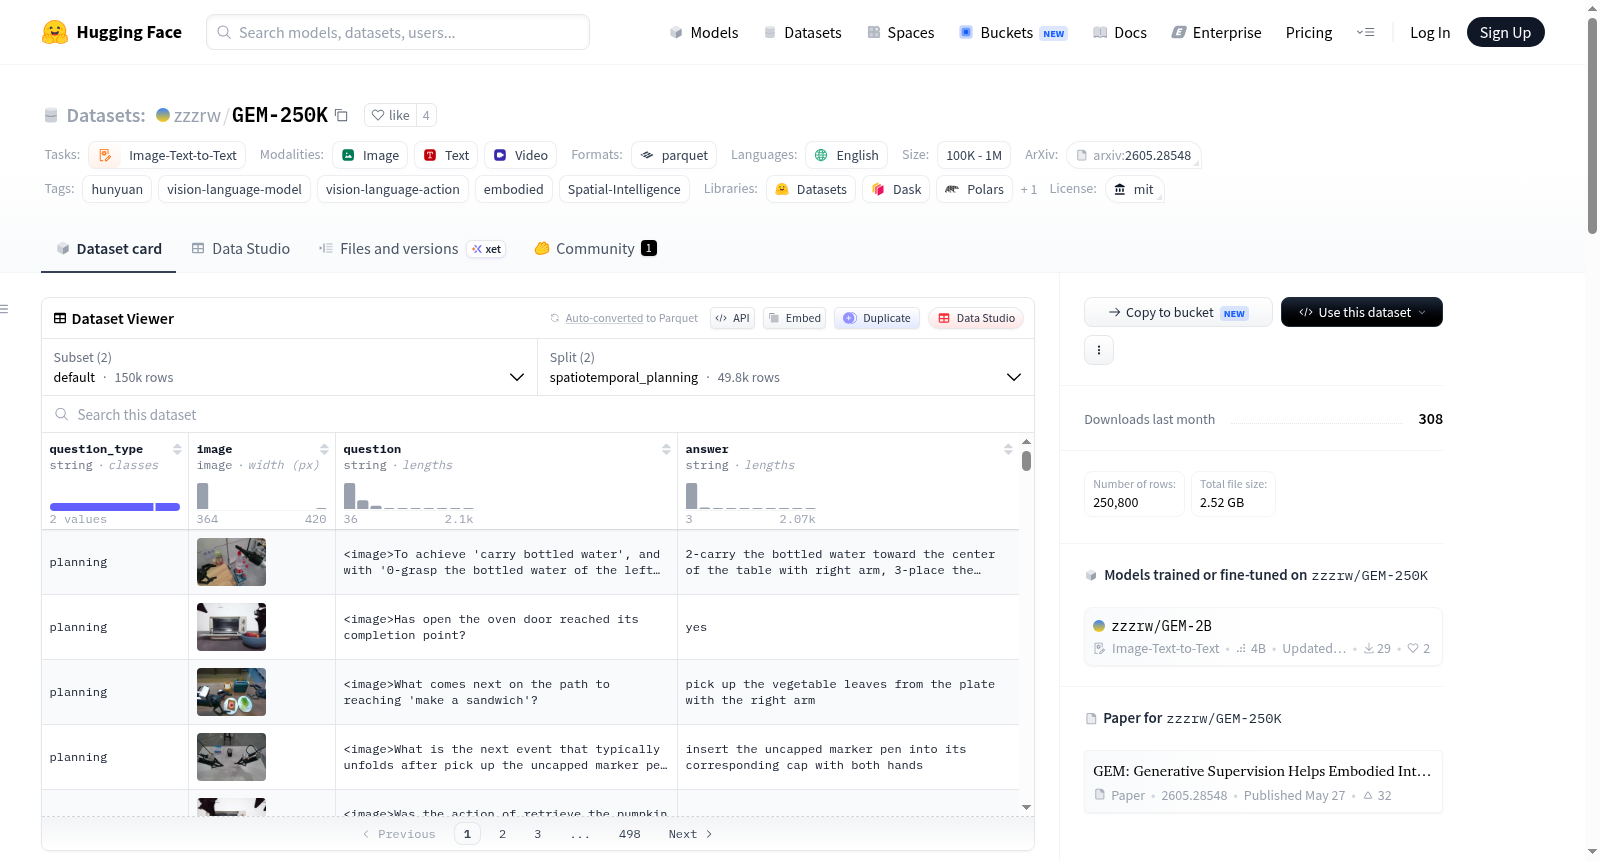
GEM-250K(或相关GEM-4M)是一个大规模多模态数据集,旨在支持生成式监督的具身视觉语言模型(GEM)的预训练。该数据集通过集成深度图生成任务,弥合了高级语义理解与低级空间物理知识之间的差距,以增强具身智能。数据集包含三种主要类型的数据:具身 grounding(涉及图像、问题和答案,用于基础感知)、空间推理(涉及视频、问题和答案,用于空间理解)以及时空规划(涉及图像、问题和答案,用于规划任务)。所有数据均配有高质量深度监督信息,帮助模型学习物理环境中的空间关系。数据集结构包括多个分割(spatiotemporal_planning, embodied_grounding, spatial_reasoning),总计超过25万个示例,总数据量约2.5 GB,支持图像-文本到文本的任务分类,语言为英语。

GEM-250K (or related GEM-4M) is a large-scale multimodal dataset designed to support the pre-training of Generative-supervised Embodied vision-language Models (GEM). By integrating a depth map generation task, the dataset bridges the gap between high-level semantic understanding and low-level spatial and physical knowledge, enhancing embodied intelligence. It comprises three main types of data: embodied grounding (involving images, questions, and answers for basic perception), spatial reasoning (involving videos, questions, and answers for spatial understanding), and spatiotemporal planning (involving images, questions, and answers for planning tasks). All data are paired with high-quality depth supervision to aid models in learning spatial relationships in physical environments. The dataset structure includes multiple splits (spatiotemporal_planning, embodied_grounding, spatial_reasoning), totaling over 250,000 examples with an overall size of approximately 2.5 GB, supporting image-text-to-text task categories, and the language is English.

提供机构:
zzzrw
搜集汇总
数据集介绍
zzzrw/GEM-250K 数据集图片
构建方式
GEM-250K数据集是GEM项目的重要组成部分,旨在通过生成式监督范式赋能具身智能体的视觉-语言理解能力。该数据集由三个核心子集构成:embodied_grounding(包含10万条具身视觉定位数据)、spatiotemporal_planning(包含4.98万条时空规划数据)以及spatial_reasoning(包含10.1万条空间推理数据)。所有数据均以parquet格式存储,其中embodied_grounding和spatiotemporal_planning子集提供图像、问题与答案对,并配有高质量的深度图作为生成式监督信号;而spatial_reasoning子集则以视频片段为输入,涵盖空间推理任务。数据集整体的构建逻辑在于将深度图生成任务嵌入视觉-语言模型的预训练阶段,以此弥合高层语义理解与低层空间物理知识之间的鸿沟。
特点
GEM-250K数据集的核心特色在于其融合了多模态感知与生成式监督的协同设计。数据集不仅提供了丰富的定位、推理与规划场景,还通过深度图生成任务作为隐式监督,显著增强了模型对三维空间结构与物理交互的认知能力。其中,embodied_grounding子集侧重视觉-语言-动作的对齐,spatiotemporal_planning子集强调时间维度上的动作序列规划,而spatial_reasoning子集则专注于空间关系的深度推理。此外,数据集的规模达到25万条样本,覆盖多种具身智能任务,使得训练出的模型在仿真环境和真实场景中均展现出卓越的任务执行性能。
使用方法
使用GEM-250K数据集时,研究人员可通过HuggingFace的datasets库直接加载,支持spatiotemporal_planning、embodied_grounding和spatial_reasoning三个拆分。加载default配置即可获取包含图像、问题和答案字段的多模态数据,并可配合深度图进行生成式监督训练;若需使用视频数据,则可选择spatial_reasoning配置。该数据集适用于视觉-语言模型(VLM)的预训练微调,特别是在具身智能领域的视觉-语言-动作(VLA)框架中,可有效提升模型的空间感知与任务规划能力。用户可将数据与GEM模型配合使用,或作为独立基准用于评估具身推理算法的性能。
背景与挑战
背景概述
GEM-250K数据集由清华大学与腾讯混元大模型团队于2026年联合发布,旨在解决具身视觉-语言模型(VLM)在高层次语义理解与低层次空间物理知识之间的鸿沟。该数据集包含约25万样本,涵盖具身接地、时空规划与空间推理三大任务,并创新性地在预训练阶段引入深度图生成任务作为监督信号,从而强化模型对三维空间结构的感知能力。GEM-250K的提出推动了具身智能从纯语义理解向物理世界交互的跨越,其构建的GEM模型在多种具身基准测试中达到最优性能,为机器人自主决策与操作提供了关键数据支撑,显著影响了视觉-语言-动作(VLA)范式的发展。
当前挑战
GEM-250K所解决的领域挑战主要在于传统文本引导的预训练范式忽视了具身环境所需的低层空间与物理知识,导致模型在执行物理操作时缺乏对深度、位置和时间的精准理解。构建过程中,团队面临两大挑战:一是如何设计并获取大规模、高质量的深度监督数据,以支持生成性训练目标;二是如何平衡接地、推理与规划等多任务数据的分布,确保模型在语义理解与物理执行间的协同提升。此外,数据的多样性与真实性也构成挑战,需在仿真环境与真实场景中保持一致的标注精度,以保障模型泛化能力。
常用场景
经典使用场景
GEM-250K数据集专为具身智能领域中的视觉-语言-动作(VLA)模型训练而设计,其经典使用场景涵盖空间推理、时空规划与具身接地三大核心任务。在空间推理子集中,研究人员可利用视频与问答对训练模型理解动态场景中的物体布局与空间关系;时空规划子集则聚焦于长时序动作序列的生成与任务分解能力;具身接地子集通过海量图像与指令配对,推动模型将自然语言指令精准映射至机器人底层操作指令。该数据集以深度图作为生成式监督信号,为预训练阶段注入物理世界几何与拓扑知识,显著弥合高层语义理解与低层空间执行之间的鸿沟。
衍生相关工作
GEM-250K的发布催生了一系列重要的衍生工作,最具代表性的是基于该数据集训练的GEM-2B基础模型与GEM-VLA动作模型,两者分别在视觉-语言理解和具身控制任务上取得了突破。此外,该数据集提出的深度图生成式监督思想启发了后续研究,如将几何先验编码进多模态大模型的预训练流程,以及构建含物理约束的仿真训练环境。围绕GEM-250K,研究者还探索了跨数据集迁移、低样本学习下的空间推理泛化等前沿课题,推动了具身智能统一评估标准的建立,并催生了多个将生成式视觉任务与强化学习结合的新范式,显著加速了该领域的理论创新与工程迭代。
数据集最近研究
最新研究方向
GEM-250K数据集聚焦于具身智能领域中视觉-语言模型(VLM)的前沿研究,通过引入深度图生成的生成式监督信号,弥合高级语义理解与低级空间物理知识之间的鸿沟。该数据集包含时空规划、具身接地与空间推理三大子集,共计约25万样本,为具身智能体在复杂环境中的自主决策与操作提供了丰富的多模态训练资源。其创新性地将生成式任务融入预训练阶段,显著提升了模型在仿真与真实场景下的任务执行能力,推动了家庭服务机器人、自动驾驶等具身应用的发展。该工作由清华大学与腾讯混元大模型团队联合推出,代表了具身智能从感知到行动一体化建模的重要突破。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

