HalluMix
收藏资源简介:
HalluMix是一个面向现实世界场景的多领域、任务无关的虚构内容检测基准数据集,包含来自医疗、法律、科学和新闻等多个领域的示例,涵盖摘要、问答和自然语言推理等多种任务。
HalluMix is a real-world scenario-oriented, multi-domain, task-agnostic benchmark dataset for fictitious content detection. It includes examples from multiple domains such as healthcare, law, science, and journalism, covering a variety of tasks including summarization, question answering, and natural language inference.
HalluMix 数据集概述
基本信息
- 许可证: Apache-2.0
- 语言: 英语 (en)
- 标签: hallucination-evaluation, benchmark
- 名称: HalluMix
数据集简介
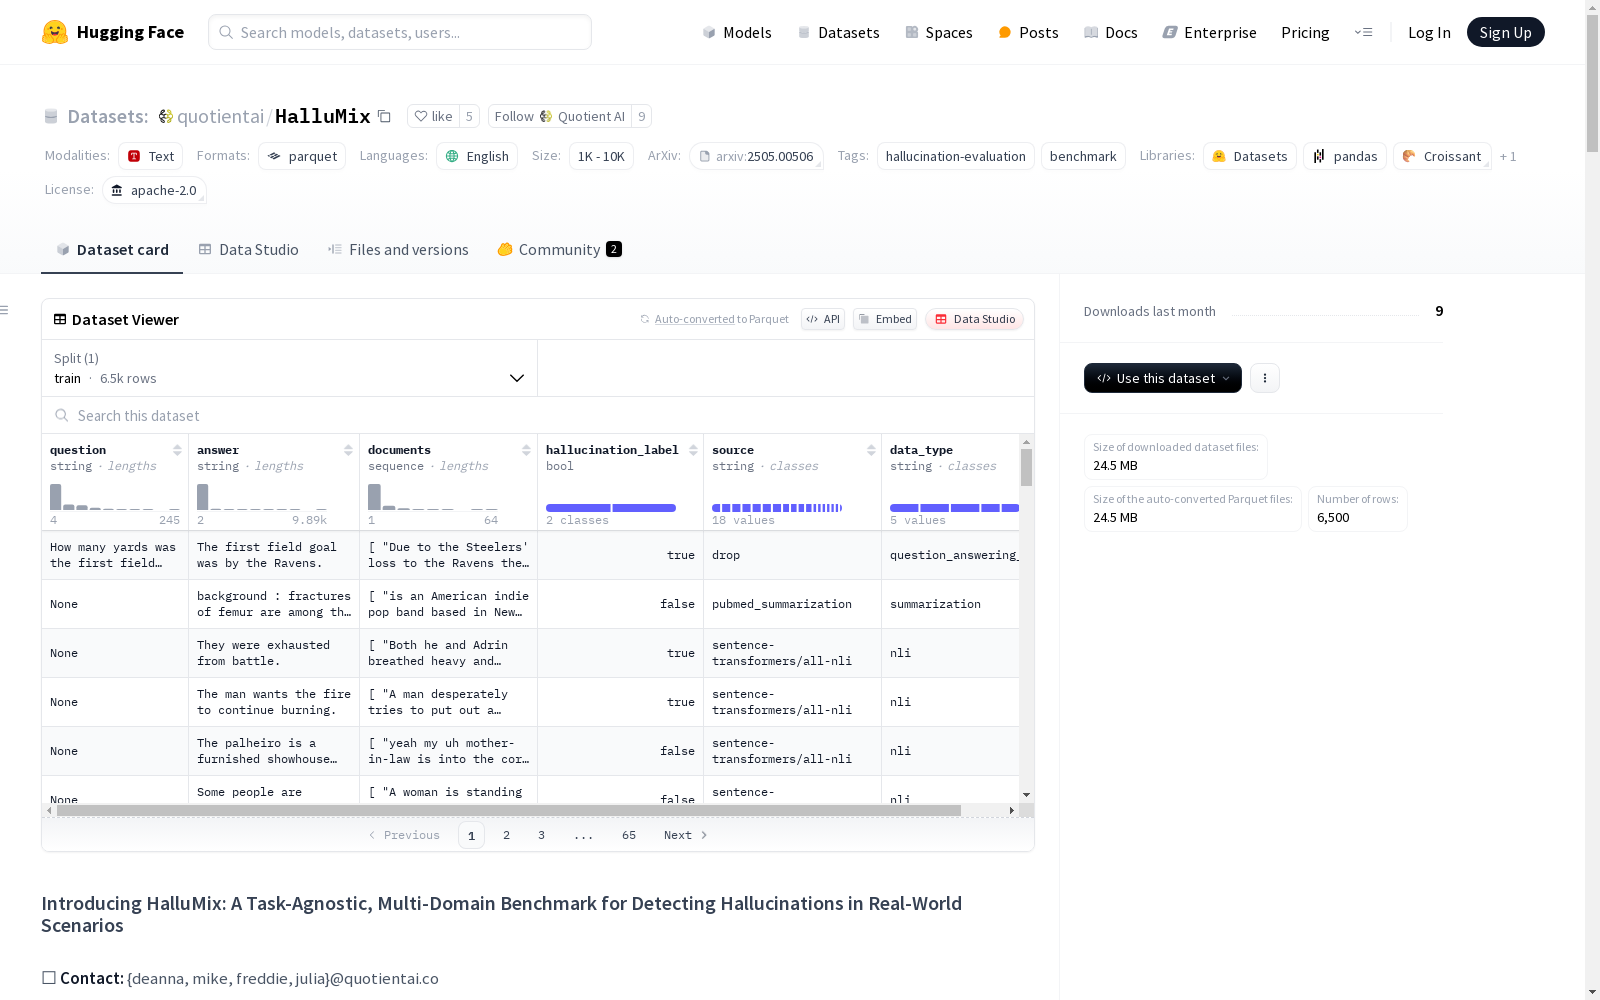
HalluMix 是一个任务无关、多领域的基准数据集,旨在评估真实场景中的幻觉检测。数据集包含来自多个领域(如医疗、法律、科学和新闻)和多个任务(如摘要、问答、自然语言推理)的示例。
数据集内容
每个示例包含以下部分:
- 文档: 上下文表示为打乱的文本块列表,包含随机无关的文档块,模拟真实世界的检索增强生成(RAG)场景。
- 答案: 需要评估的假设,如摘要句子、答案或声明。
- 幻觉标签: 二元标签,标记响应是否包含幻觉。
- 源标识符: 原始数据集的标签,用于来源追踪。
数据集构建
HalluMix 通过以下方式整合高质量的人工标注数据集:
- 自然语言推理 (NLI) 数据集: 将“蕴含”标签映射为忠实,“中性/矛盾”标签映射为幻觉。
- 摘要数据集: 通过将摘要与不相关的文档匹配生成幻觉实例。
- 问答 (QA) 数据集: 包括上下文-答案不匹配、LLM生成的看似合理但不正确的答案,并将单字答案转换为陈述句。
数据集规模
- 示例数量: 6,500 个
- 领域: 医疗、法律、科学、新闻等
- 任务: 摘要、问答、自然语言推理等
评估结果
使用 HalluMix 评估了七种领先的幻觉检测系统,结果如下:
- Quotient Detections: 最佳整体性能(准确率: 0.82,F1分数: 0.84)。
- Azure Groundedness: 高精度但召回率较低。
- Ragas Faithfulness: 高召回率但精度较低。
关键发现
- 子源过拟合: 部分检测系统对特定数据集过拟合,泛化能力有限。
- 内容长度挑战: 幻觉检测的有效性高度依赖于上下文长度和句子间连贯性。
- 架构权衡: 连续上下文方法在长文本上表现良好,而句子级方法在短文本上表现优异。
引用
如需引用 HalluMix,请使用以下 BibTeX 条目: bibtex @article{emery2025hallumix, title={HalluMix: A Task-Agnostic, Multi-Domain Benchmark for Real-World Hallucination Detection}, author={Deanna Emery and Michael Goitia and Freddie Vargus and Iulia Neagu}, year={2025}, journal={arXiv preprint arXiv:2505.00506}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2505.00506}, }
示例
幻觉响应示例
- 文档: 描述了一场橄榄球比赛的详细过程。
- 响应: "第一个射门是由乌鸦队完成的。"
- 标签: 幻觉
忠实响应示例
- 文档: 包含多个无关文本块,其中一个提到“最终幻想”由坂口博信创建。
- 响应: "最终幻想由坂口博信创建。"
- 标签: 忠实