
遇见数据集

misbah1122/alpaca

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

Alpaca数据集是一个包含52,000条指令和演示的数据集,这些指令和演示由OpenAI的text-davinci-003引擎生成。该指令数据可用于对语言模型进行指令微调,使语言模型更好地遵循指令。作者基于Self-Instruct框架的数据生成管道进行了以下修改:使用text-davinci-003引擎生成指令数据;编写了新提示,明确向text-davinci-003提供指令生成要求;采用了更激进的批量解码,即一次性生成20条指令,显著降低了数据生成成本;通过丢弃分类和非分类指令之间的差异简化了数据生成管道;每个指令只生成一个实例,而不是像Self-Instruct中那样生成2到3个实例。这产生了一个包含52K示例的指令遵循数据集,成本更低(低于500美元)。在初步研究中,作者还发现生成的52K数据比Self-Instruct发布的数据更多样化。数据集为英文,主要用于指令训练预训练语言模型。

Alpaca is a dataset of 52,000 instructions and demonstrations generated by OpenAIs text-davinci-003 engine. This instruction data can be used to conduct instruction-tuning for language models and make the language model follow instruction better. The authors built on the data generation pipeline from Self-Instruct framework and made the following modifications: The text-davinci-003 engine to generate the instruction data instead of davinci; A new prompt was written that explicitly gave the requirement of instruction generation to text-davinci-003; Much more aggressive batch decoding was used, i.e., generating 20 instructions at once, which significantly reduced the cost of data generation; The data generation pipeline was simplified by discarding the difference between classification and non-classification instructions; Only a single instance was generated for each instruction, instead of 2 to 3 instances as in Self-Instruct. This produced an instruction-following dataset with 52K examples obtained at a much lower cost (less than $500). In a preliminary study, the authors also found that the 52K generated data to be much more diverse than the data released by Self-Instruct. The data in Alpaca are in English, and it is designed for instruction training pretrained language models.
提供机构:
misbah1122
搜集汇总
数据集介绍
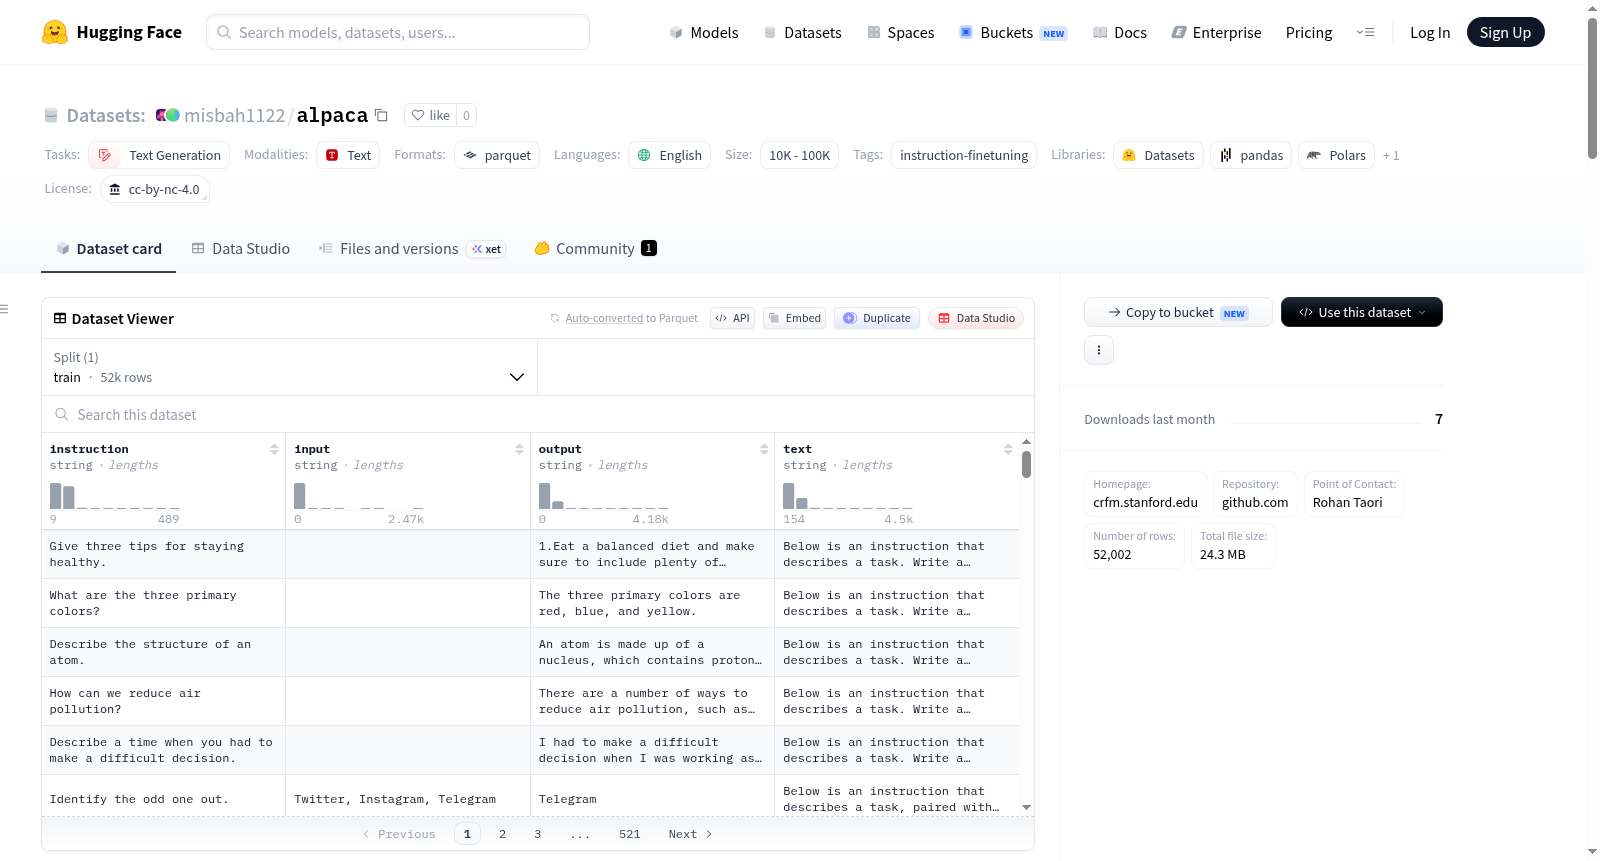
misbah1122/alpaca 数据集图片
构建方式
Alpaca数据集由斯坦福大学研究团队构建,旨在为语言模型提供高质量的指令微调数据。其构建过程基于Self-Instruct框架,但进行了多项关键改进:使用OpenAI的text-davinci-003引擎替代原先的davinci引擎,以生成更高质量的指令数据;设计全新的提示模板,明确向引擎阐述指令生成的要求;采用激进的批量解码策略,每次生成20条指令,大幅降低数据生成成本;简化数据生成流程,不再区分分类与非分类指令;同时为每条指令仅生成单一实例,而非Self-Instruct中的2至3个。最终,以不到500美元的成本,生成了包含52,000条指令与演示数据的高质量数据集。
特点
该数据集的核心特点在于其显著的成本效益与数据多样性。52,000条指令均为通过text-davinci-003引擎生成的独特样本,每条指令都配有可选的上下文输入以及模型生成的响应输出。与Self-Instruct发布的数据相比,该数据集展现出更高的多样性,为指令微调提供了更丰富的训练素材。此外,数据集中约有40%的样本包含输入字段,增强了任务的复杂性和实用性。整个数据集采用统一的文本格式,将指令、输入和输出按特定提示模板整合,便于直接用于模型微调。
使用方法
Alpaca数据集专用于语言模型的指令微调,旨在增强模型遵循人类指令的能力。使用该数据集时,可直接利用数据集中预格式化的'text'字段进行训练,该字段已按照作者微调时所使用的提示模板整合了指令、输入和输出。研究人员也可根据实际需求,灵活提取'instruction'、'input'和'output'字段,设计自定义的提示模板。数据集以JSON格式存储,每条样本包含四个字段,方便加载与处理。该数据集仅包含训练集,共52,002个样本,适用于监督微调场景。
背景与挑战
背景概述
Alpaca数据集由斯坦福大学Rohan Taori、Percy Liang等研究人员于2023年3月创建,旨在解决大语言模型指令跟随能力的提升问题。该数据集包含52,000条由OpenAI的text-davinci-003引擎生成的指令及对应输出,基于Self-Instruct框架改进而来。其核心研究问题在于以低成本的合成数据实现高效指令微调,从而使较小的基础模型(如LLaMA 7B)展现出接近大型模型的指令遵循能力。Alpaca的发布对自然语言处理领域产生了深远影响,不仅验证了合成数据在指令微调中的可行性,还推动了后续如Vicuna、WizardLM等系列工作的发展,成为低成本构建指令微调数据集的重要基准。
当前挑战
Alpaca数据集主要面临三重挑战:首先,在领域问题层面,如何使有限的指令数据覆盖多样化的任务类型并保证泛化能力,是制约语言模型指令微调效果的核心难题,尽管Alpaca通过合成生成了52K样本,但其任务多样性仍受限于种子任务集和生成引擎的偏差。其次,构建过程中需平衡数据质量与成本,采用text-davinci-003生成指令虽降低了费用,但模型输出的错误和偏见无法避免,且缺乏人工审核环节,导致数据集中存在潜在的不准确或有害内容。此外,版权和合规性问题尤为突出,数据集基于CC BY-NC 4.0协议仅限非商业使用,但生成引擎的调用涉及OpenAI服务条款,长期维护的合法性存疑。
常用场景
经典使用场景
Alpaca数据集的核心应用在于对预训练语言模型进行指令微调(instruction tuning),以增强模型遵循人类指令的能力。该数据集包含了52,000条由OpenAI的text-davinci-003引擎生成的指令与对应输出,覆盖了多样化的自然语言任务,包括文本分类、摘要生成、信息抽取和推理等。在经典使用场景中,研究者利用Alpaca对LLaMA等基础模型进行微调,使其从单纯的文本生成模型转化为能够准确理解并执行用户指令的对话式智能体。这一数据集的轻量级特性和高效构建方式,使得低成本复现具备指令理解能力的语言模型成为可能,从而成为指令微调领域的重要基准资源。
实际应用
在实际应用层面,Alpaca数据集赋予了语言模型从‘能说话’到‘会办事’的质变能力。经过Alpaca微调的模型可以广泛应用于智能客服系统(如精准回答用户问题)、文本编辑助手(如根据指令修改文风或总结内容)、教育辅导工具(如自动生成习题或解释概念)以及代码生成辅助(如依据自然语言描述编写脚本)。此外,该数据集还推动了轻量级本地化部署的可能性,允许企业在不依赖云端大模型接口的前提下,利用微调后的开源模型处理敏感数据,解决了隐私保护和离线运行的核心痛点。Alpaca所代表的指令微调范式,已成为现代对话式AI产品落地的关键技术基石。
衍生相关工作
Alpaca数据集的发布引发了一系列具有深远影响的衍生工作。在数据增强方面,Guanaco项目通过扩大语言模型多样性生成了更大规模的多语言指令数据;在模型优化方面,Vicuna通过收集高质量用户共享对话进一步提升了微调效果;在安全对齐方向,Beavertails探索了如何在指令微调过程中嵌入价值观约束。此外,Chinese-Alpaca等本土化工作利用翻译和种子拓展策略,将Alpaca范式迁移至中文场景,催生了大量针对中文大模型的指令微调数据集。这些衍生活动不仅验证了Alpaca方法的可复制性和可扩展性,更构建了从数据生成、模型训练到安全部署的完整研究生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

