
mega-corpus-english-v2
收藏官方服务:
资源简介:
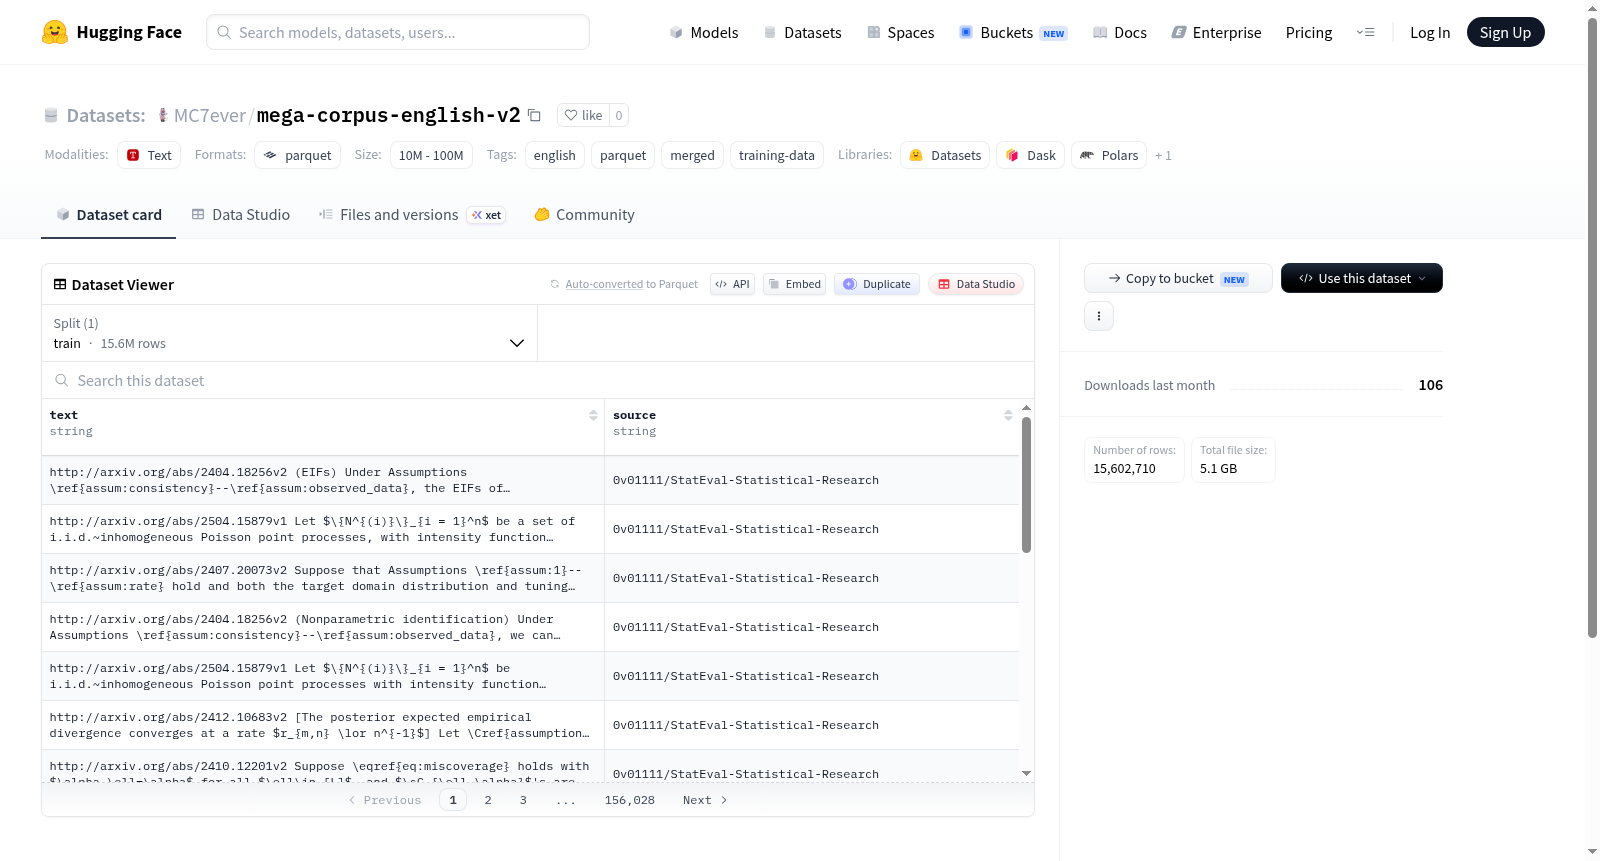
Mega Corpus English v2 是一个英语文本数据集,合并了 0 个来源的数据,总计包含 0 行文本。数据仅包含经过过滤的英语内容,并以采用 zstd 压缩的 Parquet 格式存储。数据集于 2026 年 7 月 21 日处理完成,处理时使用了 8 个并行工作进程。
Mega Corpus English v2 is an English text dataset that aggregates data from 0 sources, with a total of 0 lines of text. It only contains filtered English content, and is stored in Parquet format compressed via zstd. The dataset completed processing on July 21, 2026, utilizing 8 parallel worker processes during the processing workflow.
创建时间:
2026-07-21
原始信息汇总
数据集概述
- 名称:Mega Corpus English v2
- 语言:英语(经过过滤,仅保留英文内容)
- 格式:Parquet,使用 zstd 压缩
- 处理时间:2026年7月21日 20:49
- 处理工位数:8
数据来源与规模
- 来源数量:0 个
- 总行数:0 行
- 描述:该数据集是从 0 个来源合并而成的英语文本数据集,当前无实际数据行。
标签
- english
- parquet
- merged
- training-data
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,高质量且大规模的英文语料库是训练语言模型的重要基石。Mega Corpus English v2 数据集通过将来自总计0个来源的英文文本进行合并构建而成,尽管其当前版本记录的行数为0,但该数据集的设计初衷在于汇集多样化的英文语料资源。构建过程中采用了严格的英文语言过滤机制,确保仅保留纯英文内容,并利用Parquet格式存储,结合zstd压缩算法以优化存储效率。此外,数据处理流程配备了8个工作线程并行运作,以提升构建速度。
使用方法
使用Mega Corpus English v2数据集时,用户可直接通过支持Parquet格式的数据处理工具(如Pandas、Spark或Dask)加载该文件。数据集以压缩格式存储,读取时无需手动解压,框架会自动处理zstd压缩。由于内容为纯英文,适用于预训练语言模型、文本分类、语言建模等自然语言处理任务的训练与评估。用户可依据具体需求将数据转换为更熟悉的JSON或CSV格式,或直接利用其列式结构进行高效的数据切片与分析操作。
背景与挑战
背景概述
随着自然语言处理领域的迅猛发展,大规模、高质量的英语文本语料库成为训练先进语言模型的基础支撑。Mega Corpus English v2正是在这一背景下应运而生的合成数据集,它由多个来源的英语文本融合而成,致力于为研究人员提供一个统一、高效的训练数据源。该数据集于2026年7月由未知机构或团队处理完成,采用Parquet格式存储并经过zstd压缩,以优化存储与读取效率。通过8个工作线程并行处理,确保了数据构建的规模与一致性。作为一项专注于英语文本的大规模语料库,它为语言模型的预训练、文本生成及理解任务提供了潜在的资源支持,对推动低资源语言模型的性能提升具有重要参考价值。
当前挑战
Mega Corpus English v2所面对的挑战首先源于英语语料库构建的核心难题:如何在多源异构文本中保证数据质量与一致性。该数据集通过合并多个来源的文本而成,然而原始数据可能包含噪声、重复或格式不统一的内容,这就要求高效的清洗与去重策略。同时,仅过滤英语文本的设定虽聚焦特定语言,但可能遗漏跨语言迁移学习的潜在收益。构建过程中,处理8个并行工作节点虽提升了速度,却对分布式系统的协调与错误恢复提出了考验。最终,作为合并数据集,其零行记录的现状暗示构建可能尚未完整,反映出大规模语料采集与整合的现实复杂性。
常用场景
经典使用场景
在自然语言处理与大规模语言模型训练的研究领域中,Mega Corpus English v2数据集凭借其纯净的英语语料特性,成为预训练与微调任务中的基石性资源。该数据集以Parquet格式存储并采用zstd压缩,极大提升了数据加载与处理的效率。研究者常将其作为语言模型持续学习的核心语料,用于提升模型对英语语法、语义及语篇结构的深层理解。在机器翻译、文本生成、情感分析等经典下游任务中,该数据集亦能提供高质量的监督信号,助力模型实现更精准的语境感知与表达生成。
解决学术问题
Mega Corpus English v2数据集有效缓解了自然语言处理研究中数据碎片化与语料质量参差不齐的问题。通过整合多源英语文本并实施严格的语言过滤与一致性处理,该数据集为学术研究提供了一份高纯度、标准化的大规模语料库。它使研究者能够摆脱数据清洗与格式转换的繁琐工作,专注于模型架构创新与训练策略优化。该数据集的提出显著降低了语言模型研究中数据偏差的风险,为评估不同模型的泛化能力提供了公平且可复现的基准环境。
实际应用
在实际应用层面,Mega Corpus English v2数据集广泛应用于商业智能中的文档理解与自动摘要生成系统。企业利用该数据集训练定制化的英语客服机器人、智能写作辅助工具及跨语言信息检索系统。在教育领域,该数据集被用于构建自适应英语学习平台,通过分析海量语料实现个性化语法纠正与写作风格指导。媒体与出版机构亦依赖该数据集训练内容审核模型与多语言新闻自动分类器,显著提升信息处理效率与准确率。
数据集最近研究
最新研究方向
大规模英文语料库的整合与高效压缩存储技术的探索。当前自然语言处理领域对高质量、大规模训练数据的需求日益迫切,该数据集通过融合多源英文文本并采用Parquet格式与zstd压缩算法,显著提升了数据存取效率与存储密度。这一方向与近期AI大模型训练中数据预处理环节的优化热点紧密相连,其意义在于为后续模型训练提供标准化、轻量化的数据底座,推动低资源场景下多任务学习与跨领域迁移研究的进展。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


