
遇见数据集

Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1-prompt-only

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

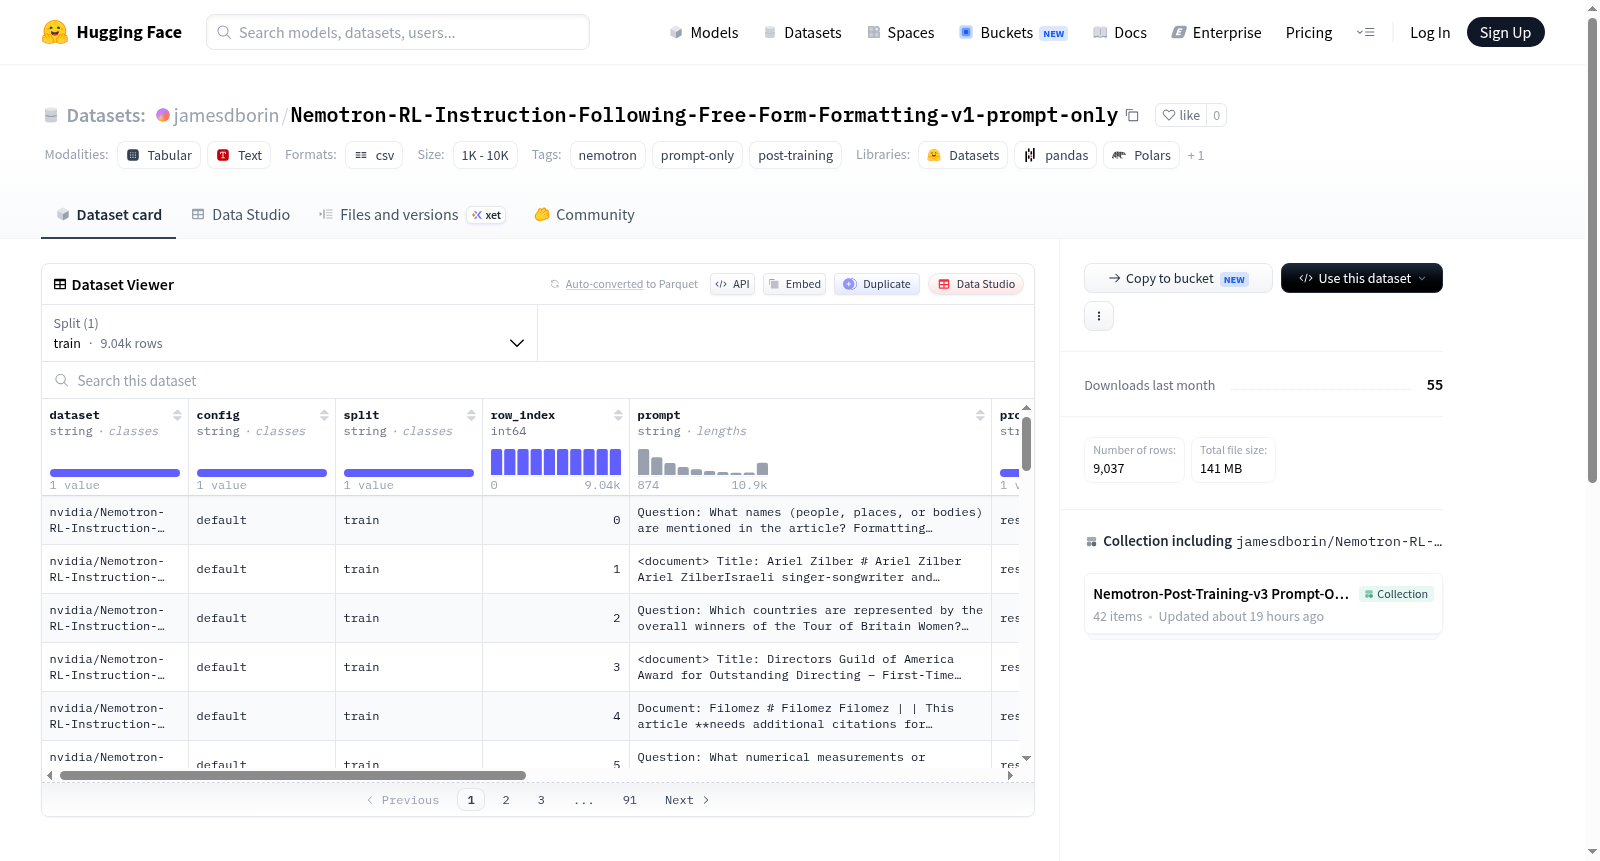
Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1-prompt-only 是一个专门从源数据集 nvidia/Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1 中提取提示词(prompt)的数据集。它包含9037条提取记录,每条记录对应源数据集的一行数据,以CSV文件格式组织。主要字段包括:提取的提示词(prompt)、分离的系统提示词(system_prompt)以及当源数据定义可用工具时的结构化工具信息(tools),其中嵌套值以JSON格式编码在CSV单元格内。数据集还提供了元数据文件,包括数据统计摘要和标识空或无效提示行的索引文件。该数据集是Nemotron后训练工作流的一部分,专门用于提示词提取任务,适用于指令跟随、自由形式格式化和基于提示的语言模型训练等场景。

Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1-prompt-only is a dataset specifically designed to extract prompts from the source dataset nvidia/Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1. It contains 9,037 extracted records, each corresponding to one row of data from the source dataset, and is organized in CSV file format. Its core fields include: the extracted prompt, the separated system prompt, and structured tool information (tools) when the source data defines available tools, where nested values are encoded in JSON format within CSV cells. The dataset also provides metadata files, including a statistical summary of the data and an index file that identifies empty or invalid prompt rows. This dataset is part of the Nemotron post-training workflow, specifically tailored for prompt extraction tasks, and is applicable to scenarios such as instruction following, free-form formatting, and prompt-based language model training.
创建时间:
2026-06-26
搜集汇总
数据集介绍
Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1-prompt-only 数据集图片
构建方式
Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1-prompt-only数据集源自于NVIDIA发布的同名大规模指令遵循数据集,经过精细的提示词提取流程,从原始数据中剥离出纯提示部分。具体而言,该数据集通过自动化脚本遍历源数据集的每一行记录,提取出包含用户提示、系统提示以及结构化工具定义的关键字段,并将嵌套的JSON值编码到CSV单元格中,最终生成仅含提示信息的高密度子集。整个提取过程严格保留了原始数据的完整性,共获得9037条有效记录,无任何失败的提示提取案例,确保了数据集的纯净与可靠性。
特点
该数据集的核心特点在于其纯粹性与结构化丰富性,仅包含提示词而不保留任何响应内容,为强化学习后训练阶段的提示词工程提供了高度专注的素材。每条记录均由清晰的系统提示、用户提示以及可选的结构化工具定义构成,使得模型能够学习如何在特定工具上下文中生成符合格式要求的指令遵循行为。此外,数据集以CSV格式呈现,便于快速加载与预处理,同时附带了完整的数据提取统计摘要,包括行数变化和空提示检查,为用户提供了透明的质量控制视图。
使用方法
使用该数据集时,开发者可直接加载prompts.csv文件,利用其中的system_prompt、prompt和tools字段进行模型微调或提示词优化实验。对于需要工具调用能力的场景,tools字段提供了预定义的函数结构,可用于训练模型在对话中动态激活外部工具。数据集的纯提示特性适用于离线评估与采样策略设计,可将其作为强化学习奖励模型的输入,或与指令响应数据配对以构建端到端的训练管线。建议结合Python的pandas库进行高效的数据筛选与批量处理,以充分发挥其结构化优势。
背景与挑战
背景概述
Nemotron-RL-Instruction-Following-Free-Form-Formatting-v1-prompt-only数据集由NVIDIA在2024年发布,旨在为大规模语言模型的后训练阶段提供指令遵循能力的强化学习数据。该数据集从原始多模态数据源中提取纯提示信息,专注于自由格式格式化任务,其创建团队隶属于NVIDIA的Nemotron后训练项目。核心研究问题在于如何通过仅保留提示文本(不含响应)来优化模型对复杂指令的解析与格式化输出能力。作为Nemotron系列的一部分,该数据集推动了强化学习在语言模型对齐中的应用,为提升模型在开放式问答、工具调用等场景下的指令遵循精度提供了关键基准。
当前挑战
当前挑战首先体现在领域问题层面:语言模型在遵循自由格式指令时易出现格式化错误(如JSON结构不完整)或工具调用遗漏,该数据集需提供足够多样的提示样本以覆盖边界情况。构建过程中主要面临提示提取的保真度挑战——从原始数据中分离系统提示与工具定义时,需确保嵌套JSON值的完整编码与CSV单元格的兼容性;同时需处理多源数据的空提示或重复提示清洗问题。此外,仅保留提示的设计虽聚焦于指令层,却可能因缺少响应标注而难以评估模型输出与提示的语义匹配度,增加了后训练阶段奖励建模的复杂度。
常用场景
经典使用场景
该数据集专为指令遵循与自由格式生成任务而设计,其核心应用在于评估和优化大语言模型对复杂、多步骤指令的理解与执行能力。通过提供结构化的系统提示、用户提示及可选工具描述,它被广泛用于训练模型以精确遵循给定约束,并生成符合特定格式要求的文本输出。研究者常利用该数据集测试模型在零样本或少样本条件下的泛化表现,尤其是在涉及动态规则调整或工具调用的场景中。其精简的‘仅提示’形式确保了数据集的轻量性与专注性,使其成为强化学习与偏好对齐等后训练阶段的重要基准。
实际应用
在实际应用中,该数据集被广泛用于优化智能助手、代码生成工具及企业级自动化系统中的指令解析模块。例如,在金融与医疗领域,模型需依据严格格式输出报告,并调用数据库等外部工具——该数据集提供的多样化工具描述和结构化提示可帮助训练模型准确识别执行边界。此外,在软件开发场景中,它可提升模型生成API调用或配置文件时的格式一致性。企业常将其作为后训练阶段的关键资源,以降低模型因指令理解偏差导致的输出错误率,从而增强产品的用户信任度与商业落地的稳定性。
衍生相关工作
该数据集衍生了一系列聚焦于指令对齐与格式化生成的经典工作。例如,基于其提示-工具映射结构,研究者开发了工具增强型指令学习框架,促使模型在复杂工作流中动态调用插件。同时,它启发了多任务强化学习方法,通过奖励模拟格式正确性与工具使用效率来提升模型鲁棒性。部分工作进一步将其与偏好数据集结合,提出了混合对齐策略,以同时优化通用性指令遵循与领域特异性格式要求。这些衍生研究共同推进了后训练阶段从单纯指令遵循向自适应格式生成与工具协同的范式演化。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

