pseudolabel-dialects-youtube-whisper-large-v3
收藏资源简介:
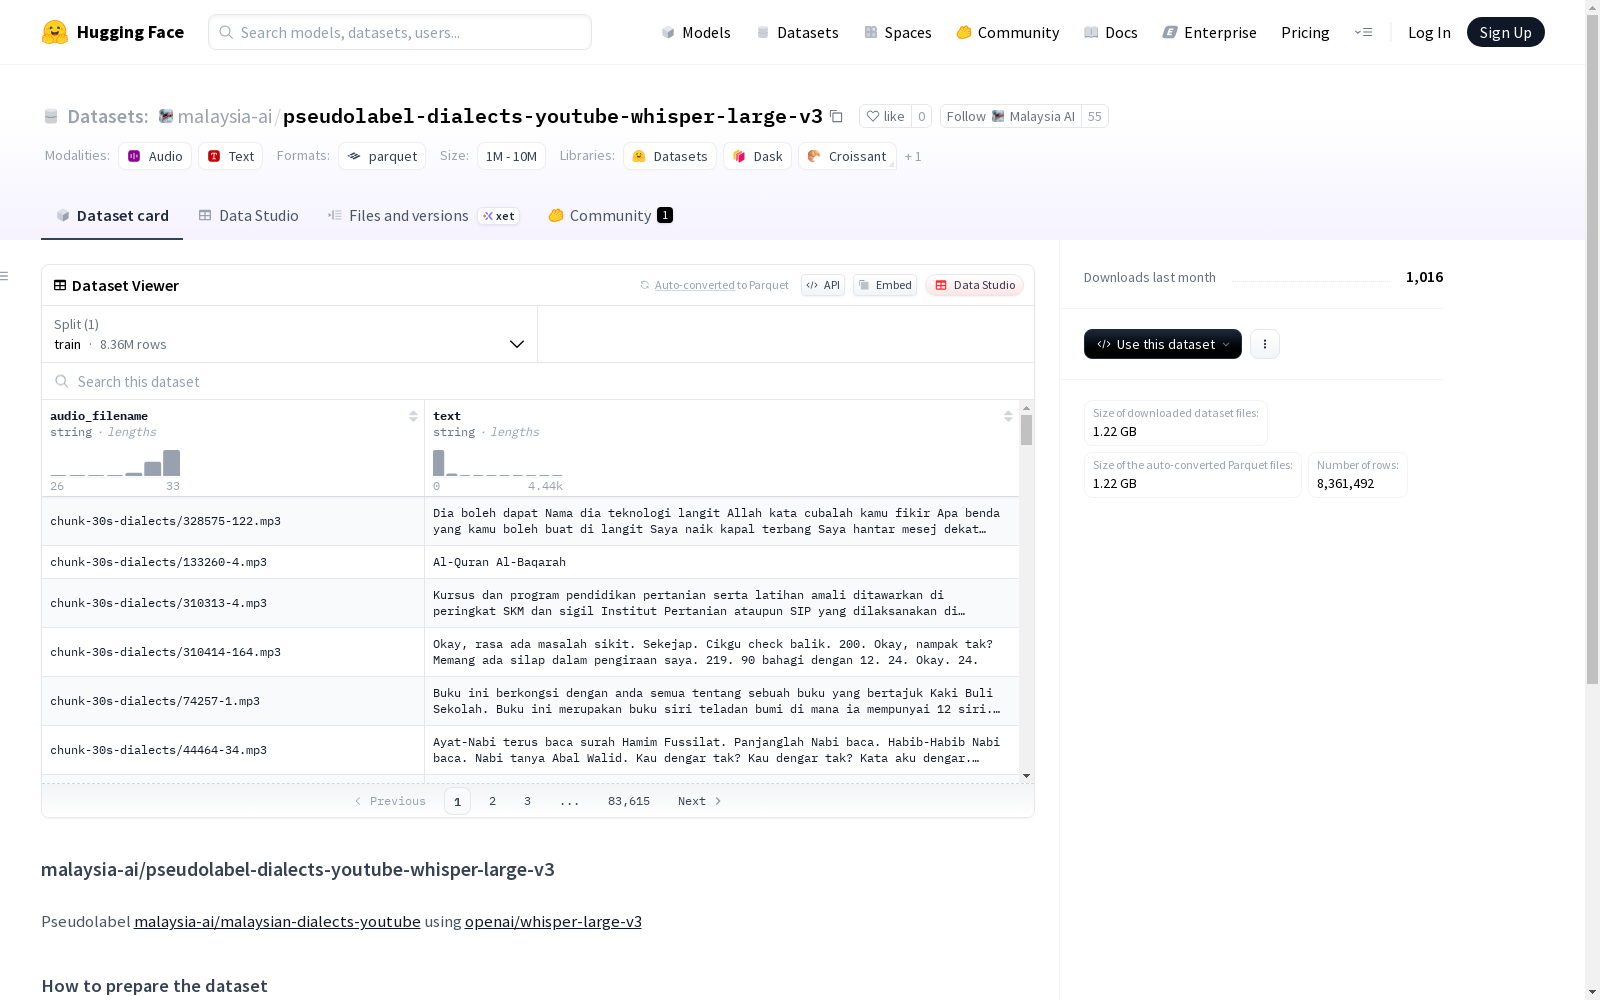
这是一个由malaysia-ai创建的数据集,名为pseudolabel-dialects-youtube-whisper-large-v3,它是基于malaysia-ai/malaysian-dialects-youtube数据集使用openai/whisper-large-v3模型生成的伪标签。数据集包含音频文件名和文本,适用于训练和评估。训练集大小为8361492个示例,数据集总大小为2.22GB。
This is a dataset developed by malaysia-ai, titled pseudolabel-dialects-youtube-whisper-large-v3. It generates pseudolabels based on the malaysia-ai/malaysian-dialects-youtube dataset via the openai/whisper-large-v3 model. The dataset contains audio filenames and their corresponding transcriptions, and is suitable for model training and evaluation. The training set includes 8,361,492 samples, with a total dataset size of 2.22 GB.
数据集概述:malaysia-ai/pseudolabel-dialects-youtube-whisper-large-v3
数据集基本信息
- 来源:基于malaysia-ai/malaysian-dialects-youtube生成伪标签
- 生成工具:使用openai/whisper-large-v3模型生成伪标签
数据集结构
- 特征字段:
audio_filename:音频文件名(字符串类型)text:文本内容(字符串类型)
- 数据划分:
train:训练集- 样本数量:8,361,492
- 数据大小:2,229,329,827字节(约2.23GB)
- 下载信息:
- 下载大小:1,220,920,889字节(约1.22GB)
- 数据集存储大小:2,229,329,827字节(约2.23GB)
数据准备方法
-
使用
huggingface-cli下载数据集: bash huggingface-cli download --repo-type dataset --include *.zip --local-dir ./ --max-workers 20 malaysia-ai/pseudolabel-dialects-youtube-whisper-large-v3 -
下载并运行解压脚本: bash wget https://gist.githubusercontent.com/huseinzol05/2e26de4f3b29d99e993b349864ab6c10/raw/9b2251f3ff958770215d70c8d82d311f82791b78/unzip.py python3 unzip.py