omnilingual-gaia2-results
收藏资源简介:
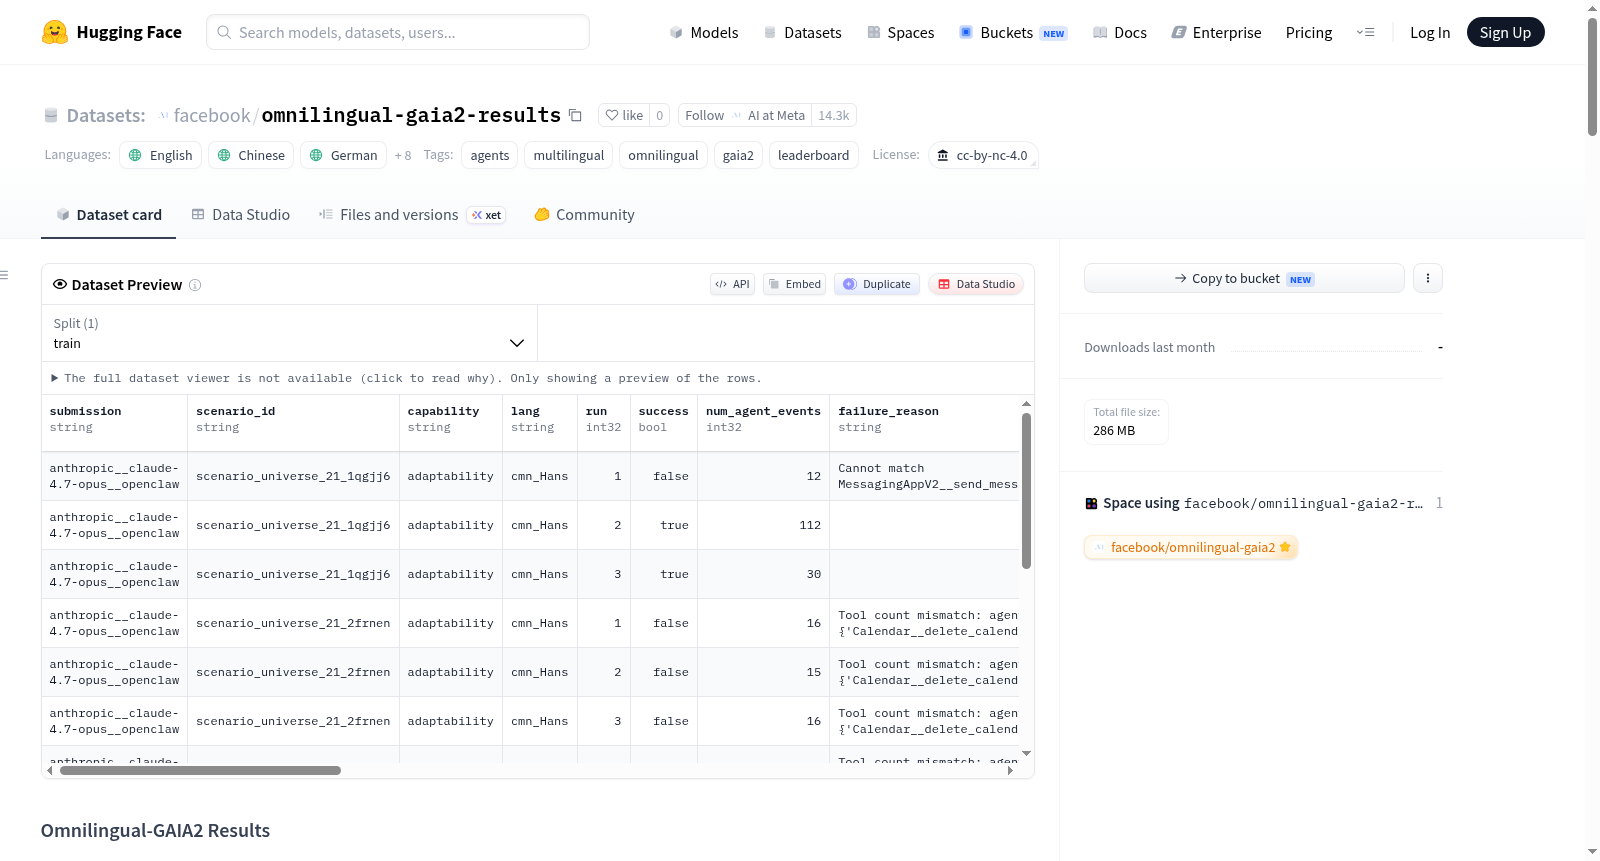
Omnilingual-GAIA2 Results 是一个用于多语言AI Agent评估的数据集,记录了Omnilingual-GAIA2排行榜中多个提交在11种语言上的评分结果。数据集包含来自7个提供商的agent在11种FLORES语言(包括英语、中文、德语、法语、印地语、印度尼西亚语、意大利语、日语、葡萄牙语、西班牙语、土耳其语)上的评估数据,覆盖四种能力:执行(execution)、搜索(search)、歧义(ambiguity)和适应性(adaptability)。数据规模为147,840行,22列,77个分片,总大小约279 MB。关键字段包括:submission(提交标识)、scenario_id(场景ID)、capability(能力)、lang(语言)、run(运行编号)、success(是否成功,null表示不可评分)、num_agent_events(agent事件数)、failure_reason(失败原因)、trace_published(是否发布轨迹)、harness(评估框架)、judge_model(评判模型)、judge_prompt_version(评判提示版本)等。此外还包含三个JSON字符串字段:judgments(逐轮评判细节)、events(工具调用轨迹,每项含app, fn, args, ret, write, turn, is_agent)、reasoning(思维链,含seq, turn, reasoning)。注意:n_events是真实未截断的事件计数,但events字段截断为150条;n_turns记录了用户与agent的轮次,但对某些提交可能不完整。reasoning字段仅对三个本地部署的开放权重提交有效。该数据集可用于复现排行榜指标、进行细粒度分析、研究agent行为等。数据集当前为私有,需通过认证的HF_TOKEN访问。许可为CC-BY-NC-4.0。
Omnilingual-GAIA2 Results is a dataset for multilingual AI Agent evaluation, recording the scoring results of multiple submissions in 11 languages on the Omnilingual-GAIA2 leaderboard. The dataset contains evaluation data from agents of 7 providers across 11 FLORES languages (including English, Chinese, German, French, Hindi, Indonesian, Italian, Japanese, Portuguese, Spanish, Turkish), covering four capabilities: execution, search, ambiguity, and adaptability. The dataset has 147,840 rows, 22 columns, 77 shards, and a total size of approximately 279 MB. Key fields include: submission, scenario_id, capability, lang, run, success (null if not scorable), num_agent_events, failure_reason, trace_published, harness, judge_model, judge_prompt_version, etc. Additionally, there are three JSON string fields: judgments (per-turn judging details), events (tool call traces with app, fn, args, ret, write, turn, is_agent), and reasoning (chain-of-thought with seq, turn, reasoning). Note: n_events is the true untruncated event count, but the events field is truncated to 150; n_turns records user-agent turns but may be incomplete for some submissions. The reasoning field is only valid for three locally deployed open-weight submissions. This dataset can be used to reproduce leaderboard metrics, perform fine-grained analysis, and study agent behavior. The dataset is currently private and requires an authenticated HF_TOKEN for access. License: CC-BY-NC-4.0.
Omnilingual-GAIA2 Results 数据集详情
数据集概述
Omnilingual-GAIA2 Results 是一个多语言智能体评测结果数据集,包含 7 个模型提交在 11 种语言上的 GAIA2 基准测试评分结果,支撑 Facebook 的 Omnilingual-GAIA2 排行榜。该数据集目前为私有状态,需授权访问。
基本信息
- 许可证: CC-BY-NC-4.0
- 语言: 英语、中文、德语、法语、印地语、印尼语、意大利语、日语、葡萄牙语、西班牙语、土耳其语(共11种)
- 标签: agents, multilingual, omnilingual, gaia2, leaderboard
- 数据量: 147,840 行,77 个分片,279 MB,22 列
数据组织
数据文件以 data/<provider>__<model>__<harness>__<lang>.parquet 格式存储,每个文件对应一个(提交, 语言)组合。语言使用 FLORES 代码标识:
- 比较基准:
eng_Latn - 其他语言:
cmn_Hans,deu_Latn,fra_Latn,hin_Deva,ind_Latn,ita_Latn,jpn_Jpan,por_Latn,spa_Latn,tur_Latn
评测能力维度包含:execution(执行)、search(搜索)、ambiguity(歧义处理)、adaptability(适应性)。
核心字段说明
已发布指标相关字段(12列):
submission: 模型提交标识scenario_id: 场景IDcapability: 能力类型lang: 语言run: 运行编号success: 成功与否(不可评分时为null而非false,共195行)num_agent_events: 智能体事件数量failure_reason: 失败原因trace_published: 是否发布轨迹harness: 评测框架judge_model: 评判模型(当前为 gpt-oss-120b)judge_prompt_version: 评判提示版本(当前为 omnilingual-gaia2)
滚动形状字段(3列):
num_oracle_events: 参考解决方案的Oracle事件数(场景属性,范围1-41,中位数7)n_turns: 用户与智能体交互轮数(Kimi提交为部分重建,可能低估)n_events: 真实未截断事件数(Kimi提交为null)
记录字段(4列):agent_response, model, started_at, pass_at
JSON字符串字段(3列):
judgments: 逐轮评判详情events: 工具调用轨迹(上限150条,超出部分截断)reasoning: 思维链(无长度限制,共1,069,891,434字符,覆盖1,024,523条记录)
特殊说明
- 多语言基准: 所有单元格以
eng_Latn为比较基准进行评分 - 评判标准: 所有行使用
gpt-oss-120b作为评判模型,omnilingual-gaia2作为评判提示版本(按语言本地化的评分标准),与其他GAIA2官方结果不可直接比较 - 缺失值语义: 各字段的null值具有明确含义(如Kimi提交无轨迹、Bedrock不返回思考内容等)
- Kimi提交限制:
moonshotai__kimi-2.6__opencode未发布任何轨迹,其事件、推理等字段为null,轮数统计仅为下界
访问与验证
- 数据集当前为私有,需通过
HF_TOKEN认证访问 - 排行榜的五个派生表公开存储在 Space 仓库的
data/tables/目录下,无需访问此数据集即可查看 - 可通过
load_dataset("facebook/omnilingual-gaia2-results", split="train")加载,或使用 DuckDB 直接查询 Parquet 文件 - 可通过运行
rederive.py脚本验证已发布表格与原始数据的字节级一致性