
natyu666/SoloAI-SFT-20260501-1352
收藏官方服务:
资源简介:
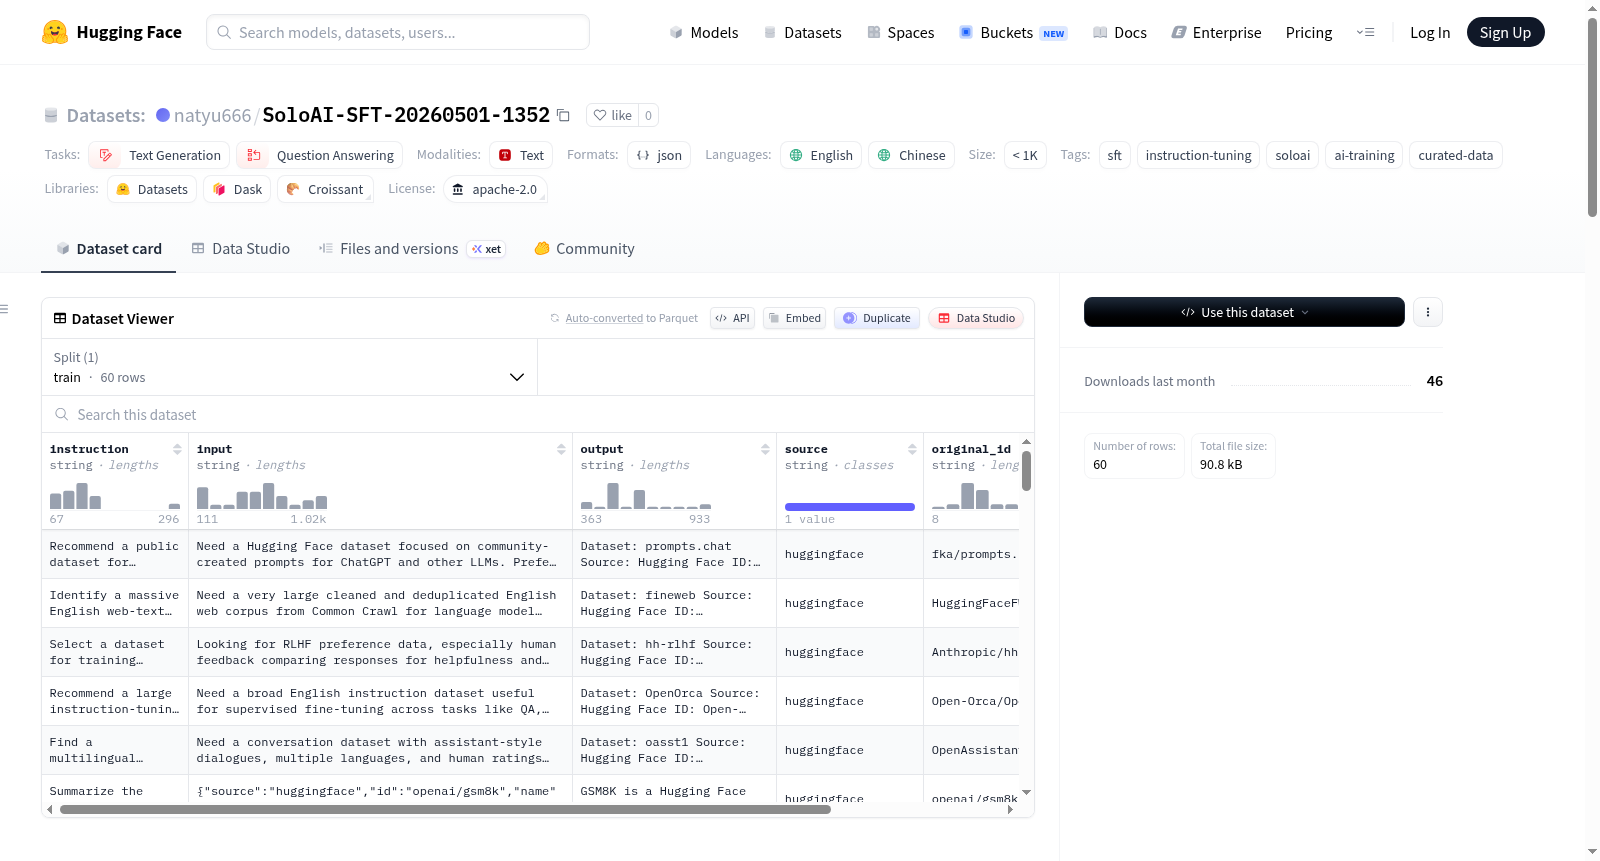
SoloAI SFT数据集是一个用于SFT微调和指令调优的数据集,包含30条数据,格式为Instruction-Input-Output,支持英文和中文。数据集适用于LLM指令微调、Prompt Engineering研究等场景。数据来源于HuggingFace Datasets Hub,经过AI清洗和质量过滤。
The SoloAI SFT Dataset is designed for SFT fine-tuning and instruction tuning, containing 30 data entries in Instruction-Input-Output format, supporting both English and Chinese. It is suitable for scenarios such as LLM instruction tuning and Prompt Engineering research. The data is sourced from HuggingFace Datasets Hub, processed and quality-filtered by AI.
提供机构:
natyu666搜集汇总
数据集介绍
构建方式
SoloAI-SFT-20260501-1352数据集由SoloAI自动化数据管道精心构建而成。其构建流程始于从HuggingFace Datasets Hub中甄别与发现高质量数据集,随后通过人工智能技术将其清洗并转化为标准的SFT格式,即Instruction-Input-Output三元组结构。每一数据条均包含明确的指令描述、输入上下文以及期望输出,确保了数据的一致性与可用性。最终,经过严格的质量过滤与审核,该数据集得以正式发布,为指令微调与提示词工程研究提供了可靠的数据基础。
特点
该数据集具备多项显著特点。首先,它涵盖英文与中文两种语言,支持多语言场景下的模型微调。其次,数据规模精巧,包含30条高质量样本,适合快速实验与原型验证。每条数据均以Instruction-Input-Output格式组织,结构清晰,便于直接用于监督式微调任务。此外,数据集来源于经过筛选的优质社区资源,并遵循Apache-2.0开源许可,兼顾了开放性与版权合规性。其标签覆盖文本生成与问答等任务,展现出良好的通用性与适配能力。
使用方法
使用该数据集时,用户可直接加载JSON格式的数据,依据Instruction、Input与Output三个字段进行模型训练或评估。典型应用场景包括大型语言模型的指令微调、对话式AI助手的训练,以及提示词工程的优化研究。用户可将其作为SFT训练集输入至各类微调框架中,结合模型进行有监督学习。同时,数据集支持中英文双语处理,适用于跨语言模型的调优。对于商业或定制化需求,还可通过联系SoloAI团队获取更深度、更大规模的数据服务与管道支持。
背景与挑战
背景概述
在大型语言模型(LLM)快速发展的背景下,高质量的指令微调(SFT)数据成为提升模型对话能力与任务执行精度的关键要素。SoloAI-SFT-20260501-1352数据集由SoloAI团队于2026年5月创建,旨在为研究者与开发者提供经过清洗与格式化的多语言指令数据。该数据集从HuggingFace Datasets Hub中筛选优质来源,经自动化管道转换为Instruction-Input-Output格式,支持LLM指令微调与提示工程研究。尽管规模较小(仅30条),但其探索了从社区共享数据集到标准化SFT格式的自动化流程,为小规模、高定制化的数据构建提供了范例,对垂直领域模型调优与数据管道研究具有一定启发意义。
当前挑战
该数据集所面临的挑战主要体现在两方面。在领域问题层面,指令微调数据集的通用性与领域专业化之间长期存在矛盾:大规模通用数据集往往缺乏深度,而小规模定制数据又难以覆盖多样化的指令模式,导致模型泛化能力受限。在构建过程层面,自动化数据管道的质量把控是一大难题,包括从原始数据中提取任务指令的准确性、输入输出对齐的严谨性、多语言内容的语义保真度,以及如何在极小样本(30条)下维持数据多样性以避免过拟合。此外,商业合作中数据定价与定制服务的标准化也构成实际运营挑战。
常用场景
经典使用场景
在自然语言处理领域,指令微调数据集SoloAI-SFT-20260501-1352以其精心设计的Instruction-Input-Output三重结构,为大语言模型的指令遵循能力训练提供了高质量的素材。该数据集最经典的使用场景是针对开源LLM进行监督式微调,尤其适用于构建对话型AI助手的初始训练阶段。通过让模型学习如何从给定的指令和上下文中生成精准、结构化的输出,研究者能够显著提升模型在多轮对话、信息检索和任务型交互中的表现。此外,该数据集也常被用于Prompt Engineering的实证研究,帮助分析提示词的语义组织与模型输出质量之间的内在关联。
衍生相关工作
受SoloAI-SFT-20260501-1352数据构建思路的启发,相关领域衍生出一系列围绕自动化数据生成与质量控制的经典工作。一方面,研究者开始探索如何利用更大规模的社区平台数据,通过多轮过滤和格式转换,持续产出高质量的SFT样本池,从而减轻对人工标注的依赖。另一方面,该数据集采用的Instruction-Input-Output结构被后续工作吸收并扩展,衍生出诸如多轮对话SFT模板、分层指令编排策略等创新方法。这些工作共同推动了从数据采集、清洗到微调训练的完整流水线标准化,为构建更强大的通用AI助手奠定了数据基础。
数据集最近研究
最新研究方向
在指令微调(Instruction Tuning)与提示工程(Prompt Engineering)交叉融合的前沿探索中,SoloAI-SFT-20260501-1352数据集以其精炼的30条Instruction-Input-Output结构化样本,为小样本高质量SFT数据的自动化管道构建提供了范例。当前,领域内的热点正聚焦于如何借助此类经AI清洗与质量过滤的策展数据,高效适配多语言对话型AI助手的微调需求,尤其是在资源受限场景下实现指令跟随能力的快速迁移。该数据集的发布,不仅推动了社区对Prompt库推荐系统与检索增强生成(RAG)的实证研究,也凸显了自动化数据流水线在降低人工标注成本、加速垂直领域模型迭代中的关键作用。
以上内容由遇见数据集搜集并总结生成


