
遇见数据集

mteb/MultilingualNanoSCIDOCSRetrieval

收藏
Hugging Face2026-06-21 更新2026-07-22 收录
官方服务:

资源简介:

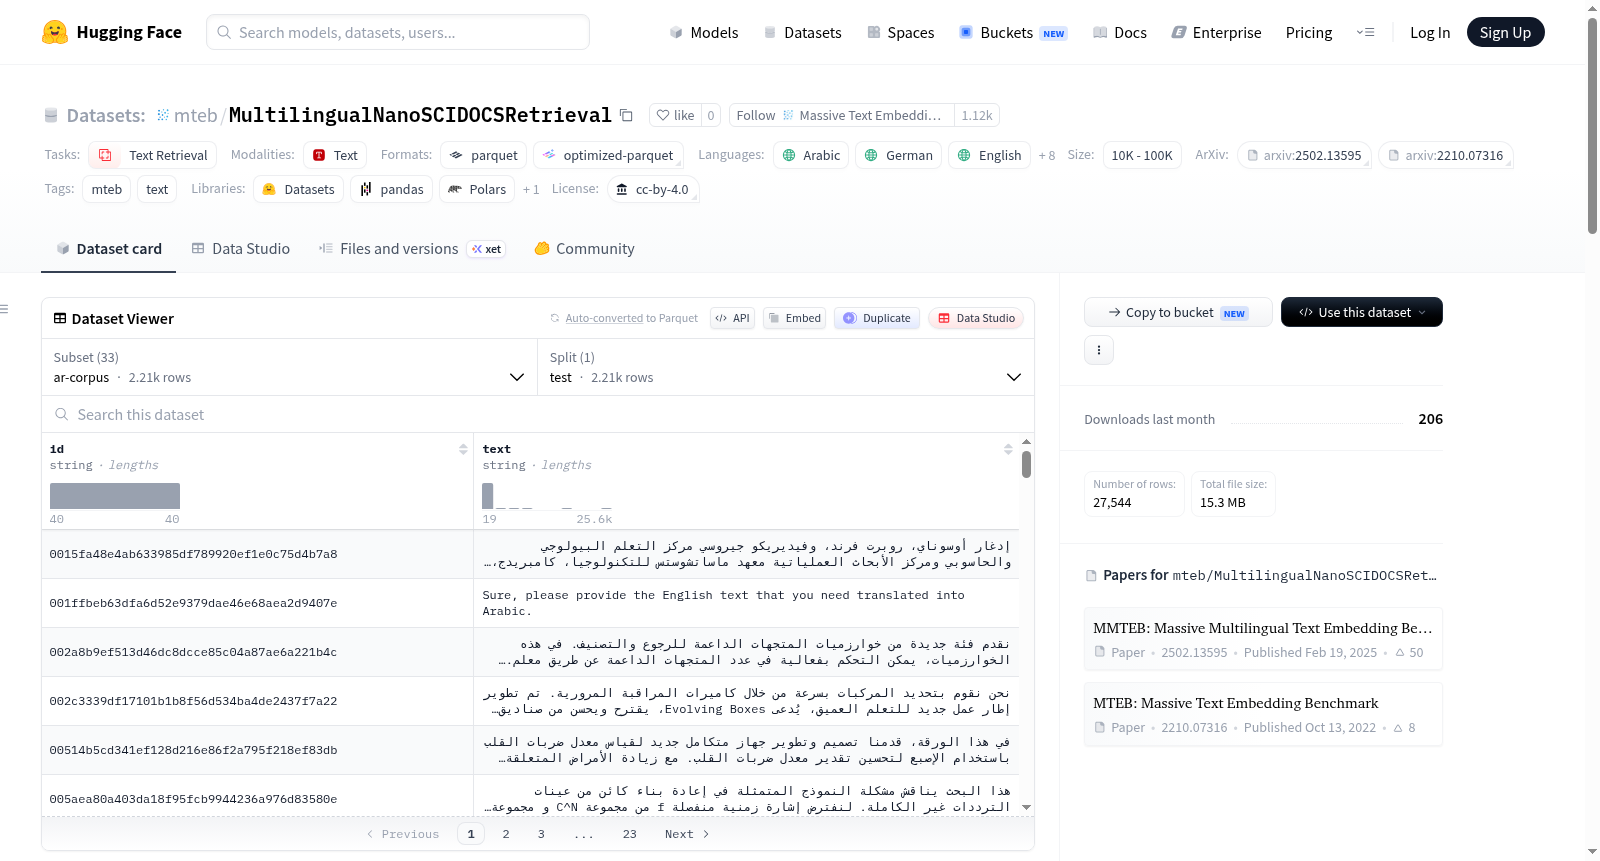
MultilingualNanoSCIDOCSRetrieval是一个多语言文本检索数据集,属于MTEB(大规模文本嵌入基准)的一部分。该数据集是NanoFiQA2018的较小子集,而NanoFiQA2018又源自SciDocs,后者是一个包含七个文档级任务的评估基准,涵盖引用预测、文档分类和推荐等任务。任务类别为文本到文本检索,领域涉及学术、书面和非虚构内容。数据集支持11种语言:阿拉伯语、德语、英语、法语、意大利语、日语、韩语、挪威语、葡萄牙语、西班牙语和瑞典语。数据来源于两个源数据集:zeta-alpha-ai/NanoSCIDOCS和LiquidAI/nanobeir-multilingual-extended,并包含测试集,具体包括语料库、查询和相关度评分(qrels)等组件,用于评估嵌入模型在多语言环境下的检索性能。

MultilingualNanoSCIDOCSRetrieval is a multilingual text retrieval dataset that forms part of the MTEB (Massive Text Embedding Benchmark). It is a smaller subset of NanoFiQA2018, which itself is derived from SciDocs—a benchmark evaluation suite comprising seven document-level tasks covering citation prediction, document classification, recommendation, and more. The task falls under the text-to-text retrieval category, with the domain spanning academic, written, and non-fiction content. The dataset supports 11 languages: Arabic, German, English, French, Italian, Japanese, Korean, Norwegian, Portuguese, Spanish, and Swedish. It is sourced from two original datasets: zeta-alpha-ai/NanoSCIDOCS and LiquidAI/nanobeir-multilingual-extended, and includes a test set with components such as corpus, queries, and relevance scores (qrels) to evaluate the retrieval performance of embedding models in multilingual settings.
提供机构:
mteb
搜集汇总
数据集介绍
mteb/MultilingualNanoSCIDOCSRetrieval 数据集图片
构建方式
MultilingualNanoSCIDOCSRetrieval数据集的构建源于对SciDocs基准测试的精简与多语言化拓展。其基础英文语料取自NanoSCIDOCS,内含2210篇学术文献,同时从LiquidAI/nanobeir-multilingual-extended中获取了涵盖阿拉伯语、德语、法语、意大利语、日语、韩语、挪威语、葡萄牙语、西班牙语及瑞典语等十种语言的高质量机器翻译版本。每条语言配置下均包含语料库(corpus)、查询集(queries)及其对应的相关性标注(qrels),形成完整的检索任务单元。
特点
该数据集最显著的特征在于其多语言检索评测能力,统一采用文本-文本检索任务范式,覆盖学术与书面非虚构领域。每个子语言配置均保持50条查询、2210篇文档与244条相关性标签的均衡规模,共计24310篇文档与550条查询构成整体评测矩阵。查询平均长度为71字符,文档平均篇幅达893字符,每条查询拥有约4.88条相关文档,确保了评测的区分度与信效度。数据集隶属于MTEB评测体系,具有标准化接口与可复现性。
使用方法
研究者可借助MTEB框架便捷调用该数据集进行嵌入模型评估。通过mteb.get_task('MultilingualNanoSCIDOCSRetrieval')加载任务,再结合mteb.get_model(YOUR_MODEL)指定待评估模型,最后调用mteb.evaluate(model, task)即可获取标准化的检索性能指标。数据集已按语言划分为33个子配置(11种语言×3种组件),用户亦可根据需要单独加载特定语言的语料或查询数据,灵活适配跨语言检索模型与单语言模型的评测需求。
背景与挑战
背景概述
MultilingualNanoSCIDOCSRetrieval 数据集源自大规模文本嵌入基准(MTEB)框架,旨在评估多语言环境下学术文档的检索性能。该数据集于 2025 年由 Kenneth Enevoldsen 等研究人员在 MMTEB 项目中创建,基于原始 SciDocs 基准中的 NanoSCIDOCS 子集,并通过翻译扩展至涵盖阿拉伯语、德语、英语等 11 种语言。其核心研究问题聚焦于跨语言文本嵌入模型在学术文献检索任务中的泛化能力,为多语言信息检索领域提供了标准化的评测平台。作为 MTEB 的重要组成部分,该数据集推动了多语言嵌入模型的比较与发展,对自然语言处理中的跨语言语义理解产生了深远影响。
当前挑战
该数据集所解决的领域挑战在于多语言学术文献检索的评估困境。传统检索基准多集中于英语,缺乏对低资源语言及跨语言场景的覆盖,导致模型在多语言环境下的性能难以衡量。构建过程中面临的挑战包括:如何确保翻译后的查询与文档保持语义一致性,避免因机器翻译引入的噪声;在维持原始 NanoSCIDOCS 任务结构(如引用预测)的同时,适配不同语言的语法和术语差异;以及处理各语言子集在数据规模上的平衡,以满足公平评测的需求。这些挑战的克服使得多语言检索评估成为可能,但翻译质量与任务适配的鲁棒性仍需持续优化。
常用场景
经典使用场景
在科学文献计量学与信息检索领域,MultilingualNanoSCIDOCSRetrieval 数据集专为跨语言学术文档检索任务而设计。其经典应用场景聚焦于评估和微调文本嵌入模型在跨语言环境下的语义匹配能力,尤其是在学术场景中,研究者可基于该数据集构建系统,实现从多语言查询到非英语科学文献库的高效检索。该数据集包含来自12种语言、2210篇科学文档的语料库,并提供针对50个查询的精细相关性判断,为跨语言检索提供了标准化的评测基准。
衍生相关工作
该数据集的发布催生了一系列围绕多语言文本嵌入与跨语言检索的经典工作。首先,它被集成进 MMTEB(大规模多语言文本嵌入基准)框架,为后续多语言嵌入模型如 LaBSE、SBERT 的多语言变体提供了标准化评测任务。其次,研究者基于该数据集探索了知识蒸馏与零样本跨语言迁移技术在学术检索中的应用,衍生出针对低资源语言的增强型检索模型。此外,该数据集也启发了对多语言检索中查询意图对齐、跨语言文档聚类等课题的深入探讨,拓展了跨语言信息检索的理论边界。
数据集最近研究
最新研究方向
在信息检索与自然语言处理领域,MultilingualNanoSCIDOCSRetrieval 数据集的问世标志着跨语言学术文本检索迈入全新的精细化阶段。其源自 SciDocs 基准的子集,并经由大规模多语言翻译扩展,覆盖阿拉伯语、德语、英语、法语、日语、韩语、挪威语、葡萄牙语、西班牙语及瑞典语等 11 种语言,紧密呼应了 MMTEB(大规模多语言文本嵌入基准)框架的构建需求。当前的前沿研究着力于评估与优化多语言文本嵌入模型在学术文献检索中的零样本泛化能力,尤其关注跨语言语义对齐的鲁棒性以及稀疏标注场景下的检索精度。该数据集的出现不仅为探索低资源语言与高资源语言之间的检索性能鸿沟提供了标准化测试床,更推动了诸如 SPECTER 等基于引文信息的文档表征模型在多语言环境下的适应性研究,对构建真正全球化、可复现的学术知识检索系统具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

