
遇见数据集

Peacockery/tajik-asr-corpus-v0

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

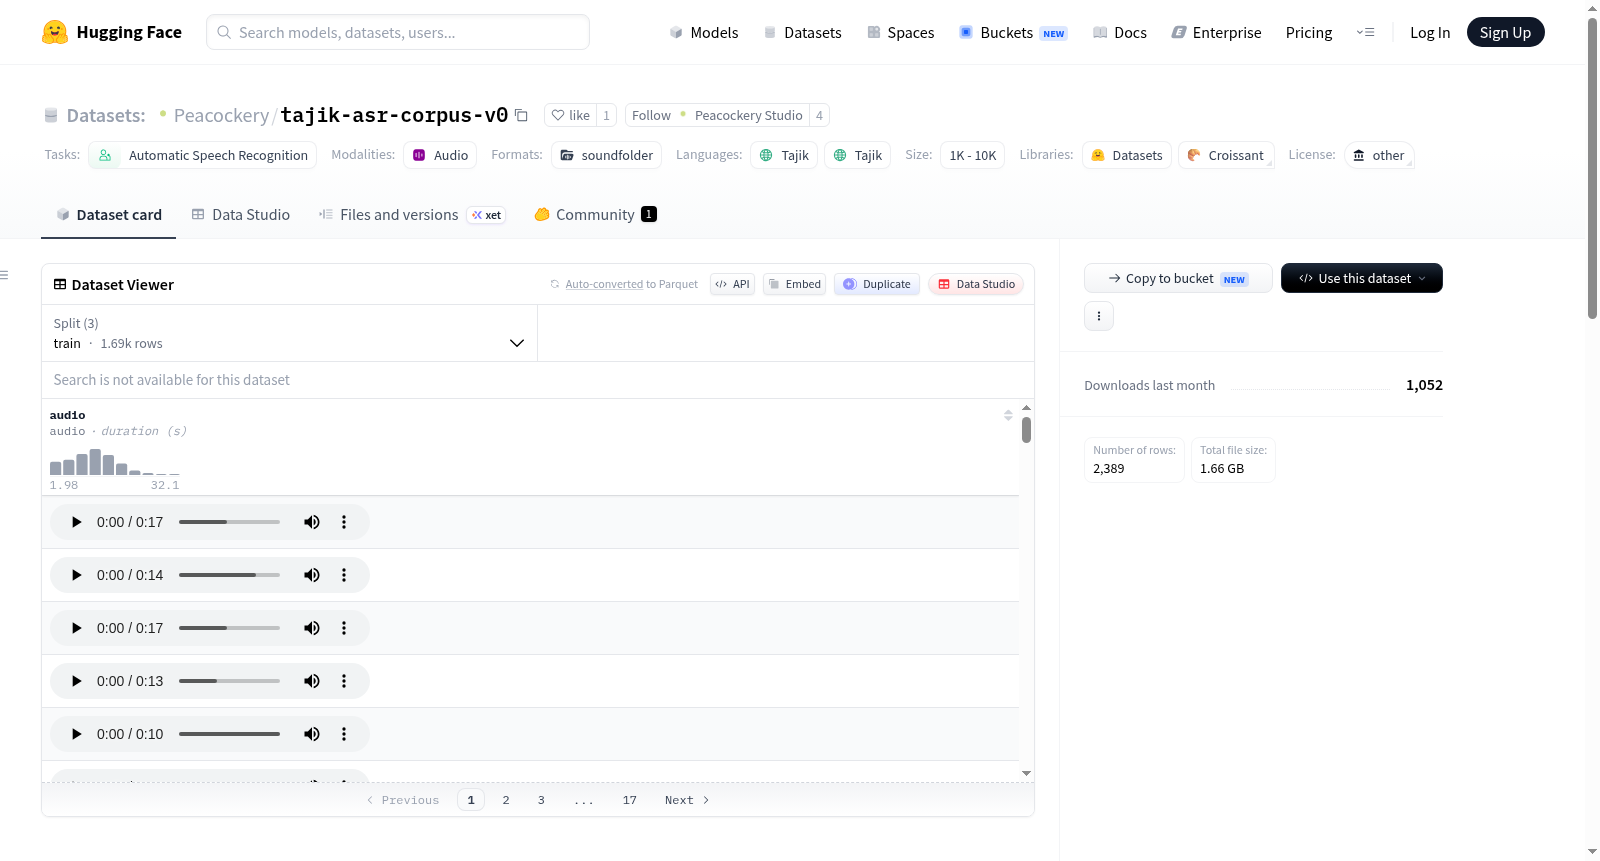
Tajik ASR Corpus v0 是一个塔吉克语自动语音识别语料库,版本为v0。它通过去重处理,从多个源数据集组装而成,包括FLEURS衍生的语音数据、Mozilla Common Voice 25的塔吉克语部分以及Muhtasham Tajik ASR增强数据。数据集格式包括每个分割(如训练、开发、测试)的TSV文件(data.tsv)和音频目录(audio/),TSV列涵盖id、音频文件名、原始转录、转录、字符数、音频字节、来源、来源ID和重复计数。此外,还提供了一个SQLite数据库(tajik_asr_combined.sqlite),用于本地管理,包含标准化文本、来源分割和来源元数据JSON。数据集规模为:训练集1,885行,开发集263行,测试集441行;去重后各源数据贡献行数为:fleurs_tg_tj 1,815行,common_voice_25_tg 572行,muhtasham_tajik_asr_augmented_test 200行,shunyalabs_tajik_speech_dataset 2行。

Tajik ASR Corpus v0 is a deduplicated Tajik automatic speech recognition corpus assembled from FLEURS-derived speech data, Mozilla Common Voice 25 Tajik, and Muhtasham Tajik ASR augmented data. The dataset format includes a TSV file (data.tsv) and an audio directory for each split (train, dev, test), with TSV columns such as id, audio_filename, raw_transcription, transcription, characters, audio_bytes, source, source_id, and duplicate_count. It also provides an SQLite database (tajik_asr_combined.sqlite) for local curation, containing normalized_text, source_split, and source_metadata_json. The dataset counts are: train split with 1,885 rows, dev split with 263 rows, test split with 441 rows; after deduplication, source contributions are: fleurs_tg_tj with 1,815 rows, common_voice_25_tg with 572 rows, muhtasham_tajik_asr_augmented_test with 200 rows, and shunyalabs_tajik_speech_dataset with 2 rows.
提供机构:
Peacockery
搜集汇总
数据集介绍
Peacockery/tajik-asr-corpus-v0 数据集图片
构建方式
塔吉克语作为中亞地區的重要語言,其自動語音辨識資源相對匱乏。為此,研究者整合了多個公開語料庫,包括FLEURS、Mozilla Common Voice 25、Muhtasham Tajik ASR augmented test以及Shunyalabs Tajik Speech Dataset,構建了去重後的塔吉克語語音辨識語料庫。通過去除重複樣本,最終保留了2,589條音頻-文本對,並依據訓練、開發與測試劃分為三個子集,分別包含1,885、263及441條記錄。此外,該語料庫提供了TSV格式的索引文件和對應的audio目錄,便於直接加載,並附帶SQLite數據庫以支持本地化編輯與元數據管理。
特点
該數據集的核心特點在於其多源融合與去重策略,有效提升了數據的多樣性與純淨度。原始數據來自FLEURS、Common Voice等多個渠道,涵蓋不同錄音環境與口音,經過去重後,FLEURS貢獻了1,815條樣本,成為主要來源,而Common Voice和Muhtasham測試集則分別提供了572和200條。數據集中每個樣本均包含音頻文件名、原始轉寫、標準化文本、字符序列、字節數、來源標記及重複計數等字段,為語音辨識模型的訓練與評估提供了豐富的結構化信息,同時支持細粒度的數據溯源與品質控制。
使用方法
使用該數據集進行自動語音辨識(ASR)模型訓練時,可直接讀取train、dev、test三個子集對應的data.tsv文件,並根據audio_filename字段定位音頻文件路徑。由於數據已預先劃分,無需手動拆分,適用於端到端模型訓練。對於需要更深度定制的場景,可通過附帶的tajik_asr_combined.sqlite數據庫進行本地查詢與編輯,利用normalized_text和source_metadata_json等字段進行擴展分析。建議在加載前進行音頻重採樣至16kHz以符合常見ASR模型輸入格式,並可基於duplicate_count字段過濾高重複樣本以進一步優化訓練集質量。
背景与挑战
背景概述
塔吉克语作为伊朗语支的重要语言,在全球范围内拥有超过800万使用者,然而其自动语音识别(ASR)技术发展长期受限于高质量标注语料库的匮乏。为此,研究团队整合来自Google FLEURS、Mozilla Common Voice 25、Muhtasham Tajik ASR增强测试集及Shunyalabs Tajik语音数据集等多源数据,于2025年发布了Tajik ASR Corpus v0数据集。该数据集由多个机构的研究人员联合构建,旨在解决低资源语言ASR领域的核心瓶颈——即跨领域、多口音场景下训练数据稀缺与分布不一致的问题。通过系统性的去重与标准化处理,数据集最终涵盖训练集1885条、开发集263条及测试集441条样本,为塔吉克语ASR模型的鲁棒性评估提供了标准化基准。这一开创性工作不仅填补了中亚低资源语言语音资源的空白,也为其他语言社区提供了可复现的数据整合范式,其影响力随着后续模型的部署将持续扩展。
当前挑战
塔吉克语ASR研究面临的核心挑战在于领域适配与数据多样性不足。现有公开语音数据往往局限于朗读式话语,缺乏自然对话、嘈杂环境及不同方言口音的覆盖,导致模型在真实场景中的泛化能力严重受限。此外,构建过程中的核心挑战源自多源数据的异构性与噪声管理:不同来源的采样率、背景噪声等级及标注规范存在显著差异,且原始数据集中存在大量重复片段(如Common Voice与FLEURS来源的样本重叠),需依赖基于文本标准化与声学特征的联合去重策略。同时,极低资源语言的特殊性使得人工标注成本高昂,自动流水线产生的伪标签(如Muhtasham增强测试集)可能引入字词错误或发音不匹配的问题,进一步加剧模型训练的偏差控制难度。
常用场景
经典使用场景
塔吉克语作为中亚地区的重要语言,其语音资源长期匮乏,严重制约了低资源语言语音技术的发展。Tajik ASR Corpus v0 数据集的经典使用场景聚焦于自动语音识别(ASR)系统的训练与评估。研究者和工程师可利用该数据集的高质量去重语音-文本对,构建端到端或混合架构的语音识别模型,实现对塔吉克语口语的精准转写。该数据集融合了FLEURS、Common Voice等多源数据,并经过精细的去重与格式化处理,为模型提供了覆盖不同说话人、口音及录音环境的训练样本,特别适用于在资源受限条件下提升ASR系统的鲁棒性与泛化能力。
实际应用
在实际应用场景中,Tajik ASR Corpus v0 赋能了众多塔吉克语智能交互系统的落地。例如,面向塔吉克斯坦的语音助手、智能客服系统可基于该数据集训练出的模型,实现对用户语音指令的准确理解。在媒体领域,该数据集可用于开发音频内容的自动字幕生成工具,提升塔吉克语新闻、播客的可访问性。此外,在教育与政府服务中,该数据集成为了构建语音听写系统、口语评测工具的核心支撑,降低了语言障碍,助力数字化服务在塔吉克语社区的推广与普及,真正实现了技术对多元语言文化的包容性支持。
衍生相关工作
Tajik ASR Corpus v0 的发布催生了一系列卓有成效的衍生工作。一方面,研究者基于该数据集微调了多语言预训练ASR模型(如Whisper、Wav2Vec 2.0),产出了针对塔吉克语的高性能专用版本。另一方面,该数据集促进了塔吉克语文本语料库的扩充与语音合成技术的研究,形成了语音识别与合成相互增强的良性循环。也有工作以此为评估基准,对比不同数据增强、自监督策略在低资源场景下的效用,为后人指明优化方向。继承该数据集的构建范式,学界还陆续推出了针对其他中亚低资源语言的相似集合,共同织就了区域性语音研究的协作网络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

