agri-slm-india-v1
收藏资源简介:
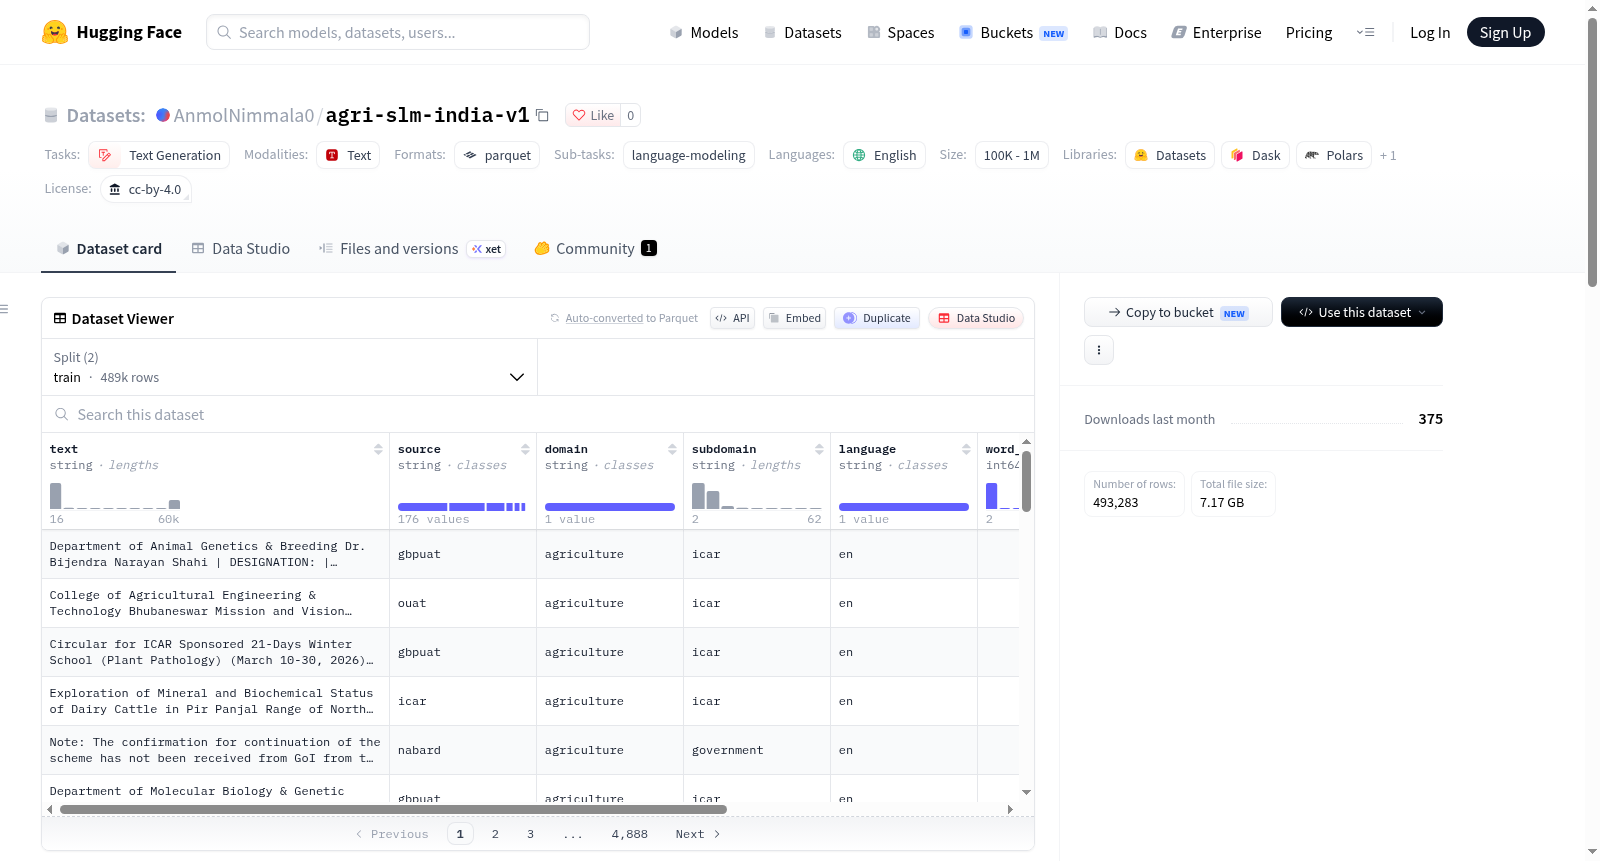
Agri-SLM India v1 是一个面向印度农业领域的英文预训练语料库,专为训练约3亿参数的小型语言模型(SLM)而设计。该数据集包含约556,765个文档,总计约3.45B个token(使用GPT-2分词器)。数据来源涵盖印度农业相关的多个渠道,包括ICAR国家论文库(krishikosh)约20.1万篇硕博论文、Kisan呼叫中心问答记录(kcc_kaggle)约14.5万条、PubMed Central印度农业论文全文(pubmed_pmc)约3.9万篇、OpenAlex研究论文摘要(openalex)约11万篇、Down To Earth调查报道(downtoearth)约1.9万篇、Krishijagran农业媒体(krishijagran)约1.6万篇、维基百科农业文章(wikipedia_agri)约1.7万篇、开放获取期刊全文(doaj)约886篇,以及来自ICAR、邦立大学、政府门户网站和新闻来源的更多数据。每个文档被标注为29个精细农业子类别中的一个或多个,并指定一个主要类别。这些类别包括:作物农艺学、土壤科学、水分与灌溉、肥料与作物营养、病虫害管理、作物病害与病理学、种子与作物育种、园艺学、畜牧与乳业、渔业与水产养殖、采后与储存、农业经济学与市场、政府计划与政策、气候与天气、有机与可持续农业、小米与粗粮、种植园与经济作物、林业与农林业、农业机械化与技术、农村生计与推广、杂草科学、蚕桑与养蜂、植物生理与生物化学、农业统计与生物计量、农业工程、食品科学与技术、微生物学与生物肥料、农业纳米技术、性别与农业/女性农民。数据集以Parquet格式存储,共124个分片,包含字段:文本(text)、来源(source)、领域(domain,固定为agriculture)、子领域(subdomain,即来源名称)、语言(language,固定为en)、词数(word_count)、类别列表(categories)、主要类别(primary_category)。该数据集适用于文本生成、语言建模等任务,尤其是针对印度农业领域的知识增强预训练。
Agri-SLM India v1 is an English pre-training corpus tailored for the Indian agricultural domain, specifically designed for training small language models (SLM) with approximately 300 million parameters. This dataset contains roughly 556,765 documents, totaling approximately 3.45 billion tokens when using the GPT-2 tokenizer. The data sources cover multiple channels related to Indian agriculture, including around 201,000 master's and doctoral dissertations from the ICAR National Repository (krishikosh), approximately 145,000 question-and-answer records from the Kisan Call Center (kcc_kaggle), roughly 39,000 full-text agricultural research papers from PubMed Central India (pubmed_pmc), about 110,000 research paper abstracts from OpenAlex (openalex), approximately 19,000 investigative reports from Down To Earth (downtoearth), around 16,000 agricultural media articles from Krishijagran (krishijagran), roughly 17,000 agricultural articles from Wikipedia (wikipedia_agri), approximately 886 full-text articles from open access journals (doaj), as well as additional data sourced from ICAR, state universities, government portals, and news outlets. Each document is annotated with one or more of the 29 fine-grained agricultural subcategories, with a designated primary category. The full list of categories includes: Crop Agronomy, Soil Science, Water and Irrigation, Fertilizers and Crop Nutrition, Pest and Disease Management, Crop Diseases and Pathology, Seeds and Crop Breeding, Horticulture, Animal Husbandry and Dairy Science, Fisheries and Aquaculture, Post-harvest Handling and Storage, Agricultural Economics and Markets, Government Programs and Policies, Climate and Weather, Organic and Sustainable Agriculture, Millets and Coarse Grains, Plantations and Cash Crops, Forestry and Agroforestry, Agricultural Mechanization and Technology, Rural Livelihoods and Extension, Weed Science, Sericulture and Beekeeping, Plant Physiology and Biochemistry, Agricultural Statistics and Biometrics, Agricultural Engineering, Food Science and Technology, Microbiology and Biofertilizers, Agricultural Nanotechnology, Gender and Agriculture/Female Farmers. The dataset is stored in Parquet format, split into 124 shards, and includes the following fields: text, source, domain (fixed as "agriculture"), subdomain (i.e., source name), language (fixed as "en"), word_count, categories, primary_category. This dataset is applicable to tasks such as text generation and language modeling, particularly for knowledge-enhanced pre-training focused on the Indian agricultural domain.
数据集概述:Agri-SLM India v1
Agri-SLM India v1 是一个面向印度农业领域、用于预训练300M参数小型语言模型(SLM)的英文语料库,包含约556,765篇文档,总词元数约34.5亿(基于GPT-2分词器),数据规模在10万至100万条之间,采用CC-BY-4.0许可。
数据规模与格式
- 文档数量:556,765条训练样本
- 数据文件:124个parquet文件(路径为
data/train-*.parquet) - 分词规模:约34.5亿词元(GPT-2分词器)
- 语言:仅英语
数据集字段
每条记录包含以下字段:
text:完整文档文本source:来源URL或来源标识符domain:农业领域subdomain:来源名称language:语言标识word_count:词数categories:类别列表(可包含多个类别)primary_category:主要类别
类别体系
数据集包含29个细粒度农业子类别,每个文档标记一个或多个类别,并指定一个主要类别。类别涵盖作物农艺学、土壤科学、水利与灌溉、肥料与作物营养、病虫害管理、作物疾病与病理学、种子与作物育种、园艺学、畜牧与乳业、渔业与水产养殖、收获后与储藏、农业经济与市场、政府计划与政策、气候与天气、有机与可持续农业、小米与粗粮、种植园与经济作物、林业与农林业、农业机械化与技术、农村生计与推广、杂草科学、蚕桑与养蜂、植物生理与生物化学、农业统计与生物统计、农业工程、食品科学与技术、微生物与生物肥料、农业纳米技术、性别与农业/农村妇女等。
数据来源
主要来源包括8个高占比来源和26个以上其他来源:
| 来源 | 文档数 | 描述 |
|---|---|---|
| krishikosh | 约201K | ICAR国家论文库(硕博论文) |
| kcc_kaggle | 约145K | 农民呼叫中心问答记录 |
| pubmed_pmc | 约39K | PubMed Central印度农业论文全文 |
| openalex | 约110K | 研究论文摘要 |
| downtoearth | 约19K | 印度农业调查新闻 |
| krishijagran | 约16K | 印度最大农业媒体 |
| wikipedia_agri | 约17K | 精选农业维基百科文章 |
| doaj | 约886 | 开放获取期刊全文 |
其余来源包括ICAR、邦立大学、政府门户网站和新闻源等。