
遇见数据集

ServiceNow/context-is-key

收藏
Hugging Face2025-07-24 更新2025-08-09 收录
官方服务:

资源简介:

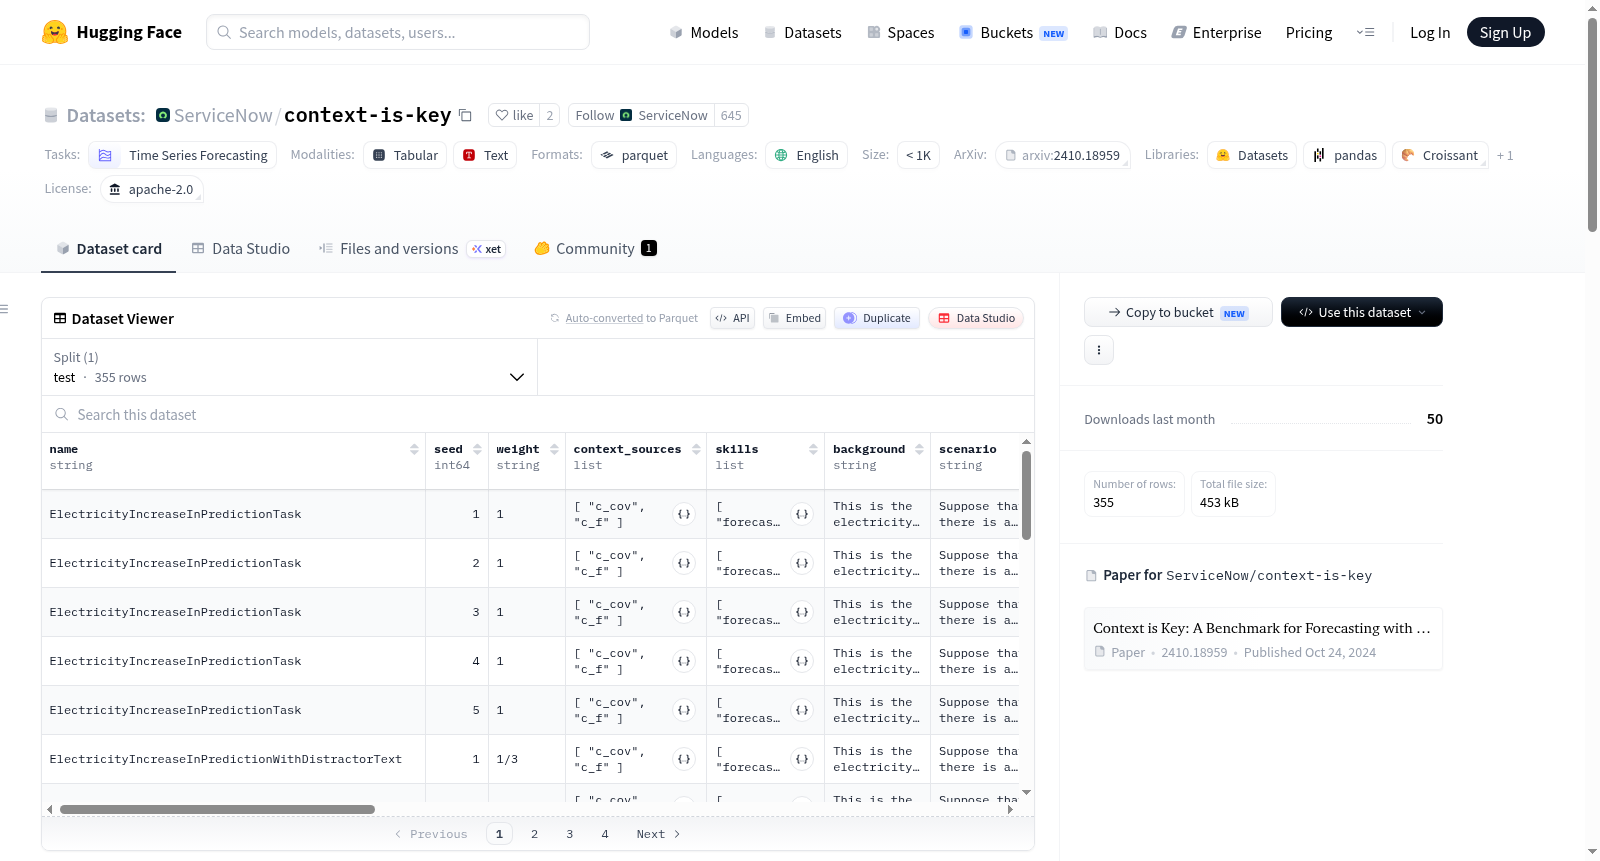
Context is Key数据集是一个用于时间序列预测的基准数据集,包含了任务名称、随机种子、权重、上下文信息来源、技能、背景、场景、约束、季节周期、过去时间序列、未来时间序列、指标缩放、感兴趣区域、约束最小值、约束最大值、约束变量最大索引和约束变量最大值等特征。这些特征有助于模型训练和RCPRS指标的计算。数据集分为测试集和ICML2025版本,适用于不同的实验需求。

The Context is Key dataset is a benchmark dataset for time-series forecasting, containing features such as task name, random seed, weight, context sources, skills, background, scenario, constraints, seasonal period, historical time series, future time series, metric scaling, region of interest, constraint minimum, constraint maximum, constraint variable maximum index, and constraint variable maximum values. These features are useful for model training and calculating the RCPRS metric. The dataset is split into a test set and an ICML2025 version, catering to different experimental needs.
提供机构:
ServiceNow
搜集汇总
数据集介绍
ServiceNow/context-is-key 数据集图片
构建方式
该数据集源自《Context is Key》基准测试,旨在为时间序列预测领域提供标准化的评估框架。其构建基于多种公开数据集,包括蒙特利尔消防统计数据、因果实验数据、电力消耗、ATM取款、太阳辐射、零售数据、太阳能生产、美国失业率及加州交通数据等,这些数据均采用公共领域或CC-BY-4.0许可协议。数据集包含355个测试样本,每个样本由任务名称、随机种子、权重、上下文来源、技能标签、背景文本、场景描述、约束条件、季节性周期、历史与未来时间序列(以JSON格式存储)等丰富特征组成。特别地,数据集通过显式约束(如约束变量最大值)和区域兴趣索引,为评估模型在复杂上下文中的预测能力提供了精细化设计。
特点
该数据集的核心特点在于其上下文驱动的评估范式。每个样本不仅包含时间序列数据,还融入了背景、场景和约束条件等文本化上下文信息,模拟真实世界中预测任务的多维性。数据集设计了多种技能标签(如因果推理、季节性处理),引导模型利用上下文线索提升预测准确性。此外,通过权重分配和区域兴趣机制,实现了对任务重要性和局部预测精度的差异化评估。数据集仅包含测试集,避免了训练数据泄露,确保了基准测试的公正性。其独特之处在于将显式约束(如最小/最大值)与RCPRS指标结合,对违反约束的预测施加惩罚,从而强化了预测的可行性与合理性。
使用方法
使用该数据集时,研究者应仅向模型提供背景文本、场景描述、约束条件、季节性周期及历史时间序列特征,同时附带未来时间点的时间戳以生成预测。模型输出需与未来时间序列的真实值比较,并通过RCPRS指标评估性能。数据集提供了`compute_rcrps_with_hf_dataset.py`脚本,用于计算RCPRS指标。用户需通过`pd.read_json(StringIO(entry["past_time"]))`将JSON格式的时间序列转换为Pandas DataFrame。需要注意的是,其他特征(如约束变量最大值)仅用于指标计算和任务分类,不应作为模型输入。该数据集适合作为时间序列预测模型的基准测试平台,尤其适用于研究上下文信息对预测性能的影响。
背景与挑战
背景概述
时序预测作为机器学习领域的核心任务之一,长期受困于模型对上下文信息的浅层利用,难以在复杂约束下生成可靠预测。由ServiceNow研究团队于2024年提出的Context is Key数据集,旨在系统性地评估模型融合多源语境信息(如历史趋势、因果结构、显式约束)的能力。该数据集基于ICML 2025发表的同名基准论文构建,整合了来自蒙特利尔火灾统计、因果腔室实验、电力消耗记录等九类公开数据源,涵盖355个精心设计的测试样本。通过引入加权连续性排序概率得分(RCPRS)与领域特定约束,该数据集为时序预测领域树立了新的评估标杆,推动学界从单纯追求数值精度转向对语境理解的深度探索。
当前挑战
Context is Key数据集所解决的领域挑战在于传统时序预测模型普遍忽视上下文信息的交互作用,例如无法同时处理季节性周期、显式约束与隐式因果依赖,导致在金融、能源等高风险场景中预测失效。构建过程中的核心挑战包括:1)从异构数据源中提取标准化语境特征(如背景、场景、约束字段),需平衡不同领域的语义差异;2)设计加权RCPRS指标以统一评估跨尺度任务,避免量纲差异对模型排名的扭曲;3)确保355个样本在仅含测试集的情况下仍能覆盖多样化约束类型(如变量上下限、区域权重),这对任务生成算法的泛化性提出严苛要求。
常用场景
经典使用场景
在时序预测领域,Context is Key数据集以其独特的上下文信息整合能力,成为评估模型在复杂约束条件下预测性能的经典基准。该数据集包含来自多个公开来源的多样化时序数据,如蒙特利尔火灾统计、因果腔室实验数据、电能消耗记录等,每项任务均附带丰富的背景描述、场景设定及显式约束条件。研究者通过仅向模型提供背景、场景、约束、季节周期及历史时序数据,要求其在给定未来时间戳下生成预测,从而精准衡量模型对上下文信息的理解与利用能力。这一设计使得数据集特别适用于探索语言模型与时间序列预测的交叉前沿,推动多模态信息融合的预测范式发展。
衍生相关工作
自Context is Key数据集发布以来,其衍生工作主要集中于两大方向:一是基于大语言模型的时序预测方法创新,例如利用预训练语言模型直接处理文本背景与数值序列的联合输入,探索提示工程在约束预测中的效果;二是可约束预测框架的构建,如开发能够自动解析约束条件并调整输出分布的神经架构。此外,该数据集的RCPRS评估指标(区域约束百分位秩评分)也被后续研究广泛采用,成为衡量预测不确定性及约束遵从度的标准化工具。其配套代码库中的任务生成器更被用于扩展至更多领域,如医疗时序预测中的临床约束建模,持续推动着上下文感知预测领域的理论演进与实证突破。
数据集最近研究
最新研究方向
Context is Key数据集聚焦于时间序列预测中的上下文理解与因果推理能力,代表了该领域从传统统计建模向深度语义融合的前沿转向。该基准通过引入显式约束、因果背景和技能标签,迫使模型超越纯数值模式识别,转而利用文本化场景描述与领域知识进行预测。这一方向与近期大语言模型在时间序列上的应用热潮相呼应,尤其是如何将非结构化上下文(如政策变化、季节性事件)编码为可操作的预测信号。数据集对RCPRS指标的精细设计,包括约束惩罚和区域加权,进一步推动了评估体系从单一精度向多维度约束满足的演进,对金融、能源和公共安全等高风险场景的智能决策具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

