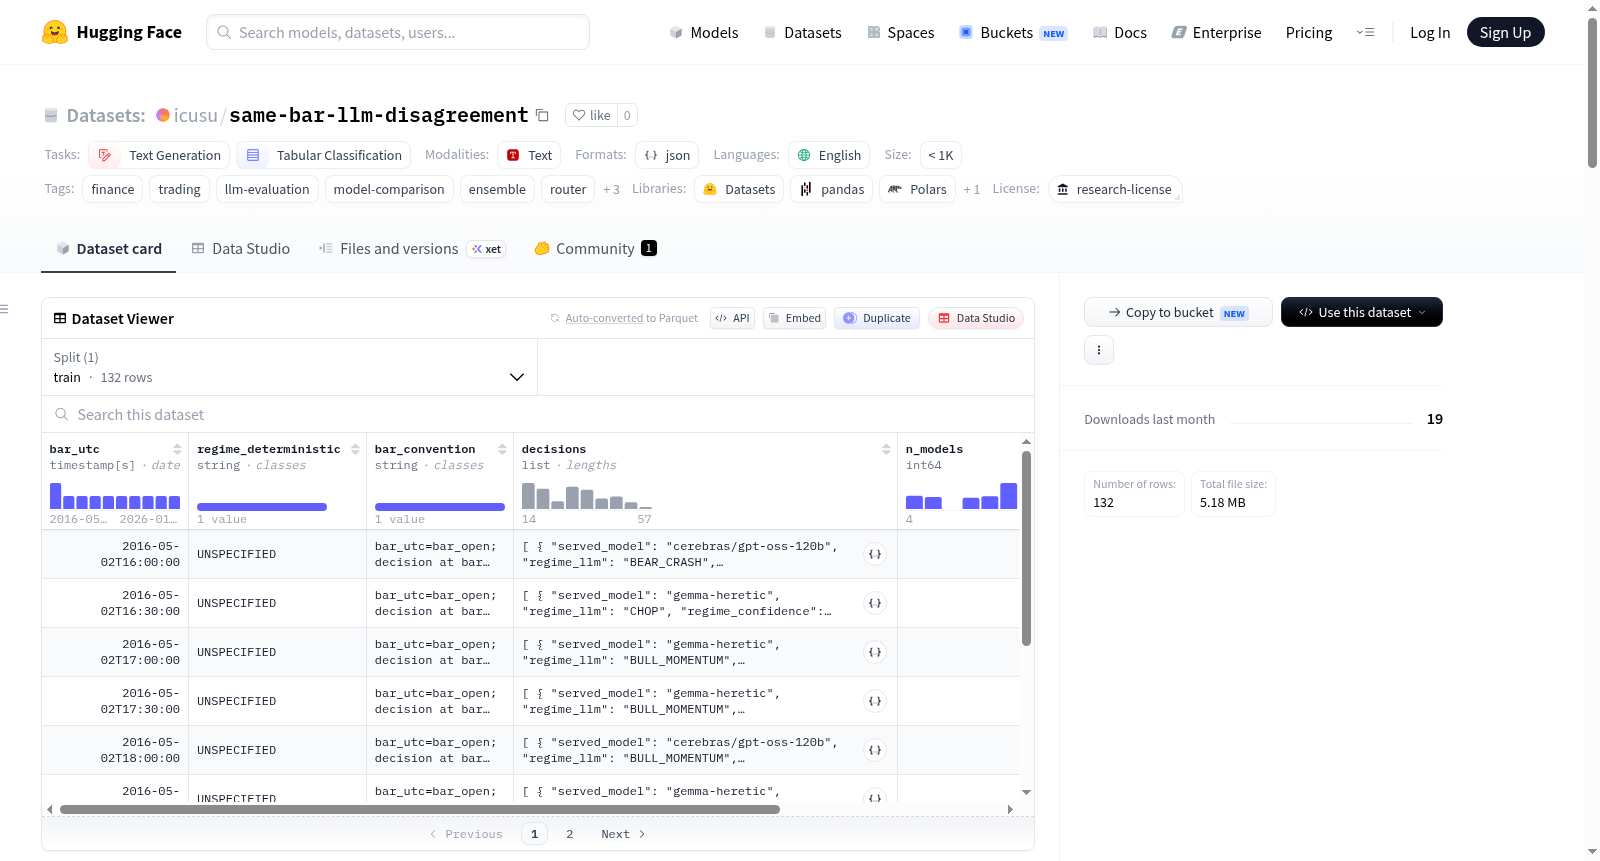
same-bar-llm-disagreement
收藏资源简介:
Same-Bar Cross-Model Disagreement 数据集记录了20多个LLM系列(包括GPT-5.x、Gemini-3.x、GLM-5.2、Grok-4.20、Claude-Opus-5等)对相同SPY 30分钟bar的决策判断,所有模型使用字节一致、哈希固定的提示。数据集包含约907,000个决策,覆盖39个模型路线、33,344个SPY 30分钟bar(2016-2026年),其中28,877个bar被至少4个不同模型评判。每个bar的决策包括模型动作(HOLD/OPEN_CALL/OPEN_PUT/CLOSE)、规模、合约规格、理由、哈希值以及因果模拟结果(PNL)。该数据集旨在支持路由器与集成研究、DPO偏好对挖掘、校准研究以及行为指纹分析等任务。数据集提供样本(4,000+决策),完整数据集通过研究许可获取,不支持直接重新分发。
The Same-Bar Cross-Model Disagreement dataset records decision-making of over 20 LLM series (including GPT-5.x, Gemini-3.x, GLM-5.2, Grok-4.20, Claude-Opus-5, etc.) on identical SPY 30-minute bars, with all models using byte-consistent, hash-fixed prompts. The dataset contains approximately 907,000 decisions, covering 39 model lineages and 33,344 SPY 30-minute bars (2016-2026), of which 28,877 bars are evaluated by at least 4 different models. Each bars decision includes model action (HOLD/OPEN_CALL/OPEN_PUT/CLOSE), size, contract specifications, reasoning, hash value, and causal simulation results (PNL). The dataset is designed to support tasks such as router and ensemble research, DPO preference pair mining, calibration research, and behavioral fingerprint analysis. It provides a sample (4,000+ decisions), while the full dataset is available under a research license and does not support direct redistribution.
数据集概述
Same-Bar Cross-Model Disagreement (LLM Trading Decisions) 是一个用于研究多个大语言模型(LLM)在同一市场状态下决策分歧的数据集,旨在为路由、集成学习、偏好对挖掘、校准研究及行为指纹识别等领域提供基础数据。
核心特点
- 数据规模:完整数据集包含约 907,000 条模型决策,覆盖 39 个模型路线(20+ 模型家族),数据每日更新。
- 市场数据范围:基于 33,344 根 SPY 30分钟K线(2016年5月至2026年7月),其中 28,877 根K线由至少4个不同模型在字节级一致、哈希固定的提示词下进行判断,平均每根K线约有 27 条模型决策。
- 免费样本:提供 4,000+ 条决策 样本可供免费使用。
数据集内容
- 每个K线记录包含模型对 HOLD / OPEN_CALL / OPEN_PUT / CLOSE 四种操作的决策、理由说明及约100字的备忘录。
- 每条记录包含提示词哈希(
user_prompt_sha256和system_prompt_sha256),确保提示词的字节级一致性。 - 交易结果使用 因果模拟(决策在K线收盘时做出,30分钟后成交),避免了前视偏差。
- 实验表明,日期盲化处理仅影响约 1/40 的K线决策(97.5%一致性),证明模型并非依赖记忆的日历日期。
关键洞察
- 在样本中,58% 的多模型K线 显示模型间存在行动分歧。
- 在完整数据集的 10,844 根分歧K线中,不同模型路线的“正确率”从 65%(gpt-5.5-instant)到 45%(gpt-oss-120b)不等,且一些低成本模型(如 gemini-3-flash 达 63%、laguna-s 达 64%)表现优于多个旗舰模型。
可用切片
- 完整数据集支持按市场状态(regime)、模型家族、DPO 偏好对等自定义切片导出。
获取方式
- 完整数据集需通过 研究许可 获取,联系邮箱:kinase@tutanota.com,需说明用途。
- 允许基于数据集产出衍生模型和论文(需引用),但禁止重新分发数据集本身。