
遇见数据集

saraiki-sentiment-analysis-dataset

收藏
Hugging Face2026-08-16 更新2026-08-17 收录
官方服务:

资源简介:

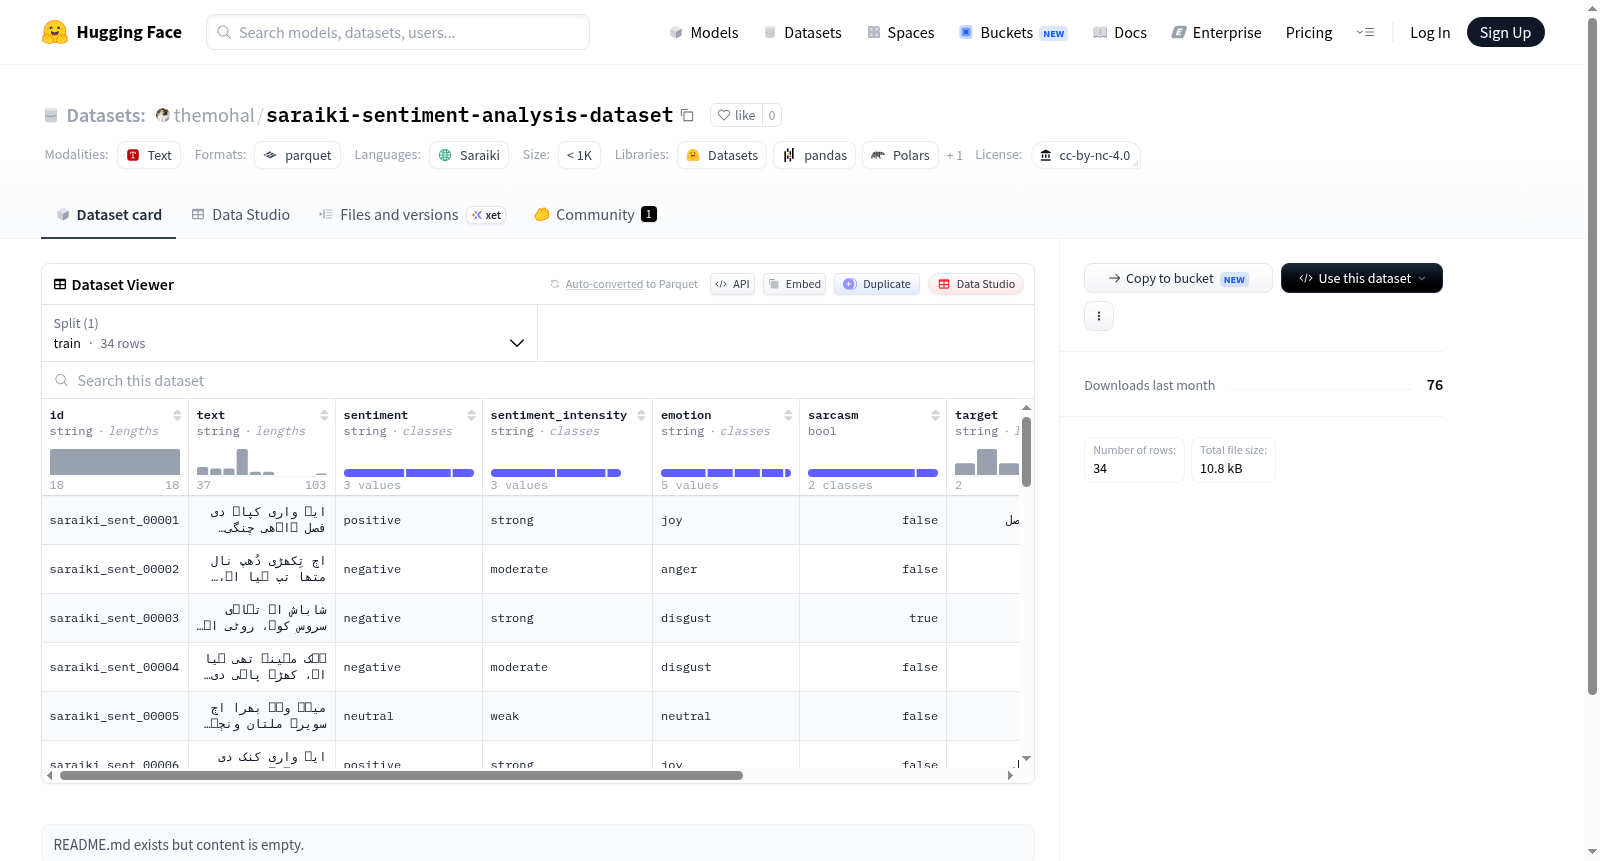
该数据集是一个面向情感分析与观点挖掘的多标签标注数据集,语言为skr。数据集包含34条训练样本,每条样本包含文本及其对应的情感倾向(sentiment)、情感强度(sentiment_intensity)、情绪类别(emotion)、是否讽刺(sarcasm)、评价目标(target)、评价方面(aspect)以及方面级情感(aspect_sentiment)。适用于情感分类、讽刺检测、方面级情感分析、情绪识别等自然语言处理任务。数据集采用CC-BY-NC 4.0许可证。

This dataset is a multi-label annotated dataset for sentiment analysis and opinion mining, with the language being skr. It contains 34 training samples, each with text and its corresponding sentiment polarity, sentiment intensity, emotion category, sarcasm flag, evaluation target, evaluation aspect, and aspect-level sentiment. It is suitable for natural language processing tasks such as sentiment classification, sarcasm detection, aspect-level sentiment analysis, and emotion recognition. The dataset is licensed under CC-BY-NC 4.0.

创建时间:
2026-08-14
原始信息汇总

数据集概述

  • 数据集名称:saraiki-sentiment-analysis-dataset
  • 许可证:CC BY-NC 4.0(知识共享-非商业使用4.0)
  • 语言:Saraiki(代码:skr)
  • 数据集大小:约6.9 KB
  • 下载大小:约7.7 KB
  • 数据划分:仅包含训练集(train),共34条样本

数据特征

该数据集包含以下字段:

字段名 数据类型 含义
id string 样本唯一标识符
text string 评论文本内容
sentiment string 情感倾向(如正面/负面/中性)
sentiment_intensity string 情感强度等级
emotion string 具体情绪类型
sarcasm bool 是否包含讽刺/反讽
target string 情感指向的目标实体
aspect string 评论涉及的方面/属性
aspect_sentiment string 针对该方面的情感态度

用途

该数据集适用于Saraiki语言的情感分析、情绪识别、讽刺检测及细粒度方面级情感分析等自然语言处理任务。由于样本量较小(仅34条),可能更适合作为小规模实验或研究原型的数据资源。
搜集汇总
数据集介绍
saraiki-sentiment-analysis-dataset 数据集图片
构建方式
本数据集聚焦于旁遮普语系下的萨莱基语,旨在填补低资源语言情感分析领域的空白。其构建过程严谨,通过从社交媒体及文本平台采集真实语料,经过专业标注人员对每条文本进行多维度的语义标注,涵盖了情感倾向、情感强度、情绪类别、讽刺识别、目标对象及方面级情感等关键信息,最终形成包含34条训练样本的精炼数据集,每条样本都携带丰富的语义标签,为低资源语言的自然语言处理研究提供了宝贵的基础资源。
特点
该数据集的显著特点在于其多层次的注释体系,不仅提供了传统的情感极性分类(如正面、负面、中性),还进一步细化了情感强度与具体情绪类别,同时引入了讽刺检测与目标/方面级的情感标注,使得对文本的理解更加深入和细腻。这种多维度的信息整合,使得数据集在情感分析任务中具有高度的信息密度,适合用于训练模型进行细粒度的情感理解,尤其在处理讽刺性语言和跨领域情感迁移时表现出独特价值。
使用方法
此数据集适用于多种自然语言处理任务,包括情感分类、情绪识别、讽刺检测以及方面级情感分析。研究人员可直接加载默认配置的训练集,采用标准的监督学习范式,利用文本特征结合上述标注进行模型训练。鉴于数据规模较小,建议结合迁移学习或数据增强技术以提升模型泛化能力。此外,该数据集也可用于评估多语言情感分析模型的跨语言鲁棒性,尤其针对低资源语言的场景。
背景与挑战
背景概述
该数据集名为saraiki-sentiment-analysis-dataset,创建于2023年,由巴基斯坦的研究人员开发,旨在填补萨莱基语(Saraiki)情感分析资源的空白。萨莱基语是巴基斯坦旁遮普省南部地区使用的一种印度-雅利安语系语言,拥有超过2000万使用者,但在自然语言处理(NLP)领域一直缺乏标注数据。该数据集包含34条训练样本,每条样本标注了情感极性(sentiment)、情感强度(sentiment_intensity)、情绪类别(emotion)、讽刺标记(sarcasm)以及目标、方面和方面级情感(aspect_sentiment)等丰富信息。这是首个公开的萨莱基语情感分析数据集,为低资源语言的情感分析研究提供了基础资源,对推动南亚地区语言的NLP发展具有里程碑意义。
当前挑战
该数据集面临的主要挑战包括:其一,领域问题层面,萨莱基语作为一种低资源语言,缺乏足够的语料库和语言工具,情感分析任务因语言复杂性(如方言变体、多义表达)而更具难度,现有模型多依赖英语或乌尔都语资源,直接迁移效果不佳。其二,构建过程层面,数据采集需克服标注人员稀缺、标注标准不一致等问题,且34条样本量极小,难以训练有效的深度学习模型,易导致过拟合和泛化能力不足。此外,讽刺和情感强度的标注主观性强,需设计细致的标注指南以保障一致性,但样本量限制使得模型无法有效捕捉这些细微特征。未来需要扩大数据集规模,并开发针对该语言的预训练模型以提升性能。
常用场景
经典使用场景
该数据集聚焦于萨莱基语(Saraiki)的情感分析,为低资源语言的自然语言处理研究提供了珍贵的语料资源。在情感分析领域,数据集的稀缺性长期制约着非主流语言的研究进展,此数据集的出现填补了这一空白。其经典使用场景包括对文本进行情感极性分类,将评论文本划分为正面、负面或中性,同时提供情感强度标注,支持更细粒度的情感程度分析。此外,数据集中还包含情绪类别、讽刺标记等丰富注释,使得研究者能够开展多维度情感解析任务,如情感原因识别、讽刺检测以及目标与方面级情感分析,为深入理解萨莱基语文本中的情感表达提供了全面的实验基础。
实际应用
在实际应用中,该数据集可服务于多种社会与商业场景。对于社交媒体监测,利用此数据集训练的模型能够实时分析萨莱基语用户的评论与反馈,帮助政府或企业洞察公众情绪,及时响应舆情事件。在电商与客户服务领域,该模型可对萨莱基语产品评论进行情感分类,辅助商家了解用户满意度,改进产品与服务。此外,数据集中的讽刺与情感强度标注有助于构建更精准的对话系统,提升人机交互体验。在新闻与媒体分析中,该数据集也能用于评估新闻文章的情感倾向,支持舆情分析与决策支持。这些应用不仅促进了萨莱基语信息处理技术落地,也增强了该语言社群在数字世界的参与度。
衍生相关工作
基于该数据集,研究者可衍生出多项经典工作。其一,可构建萨莱基语情感分析基线系统,对比不同机器学习与深度学习模型(如LSTM、Transformer)在低资源语言上的表现,并探索数据增强、预训练语言模型微调等策略的有效性。其二,利用数据集的细粒度标注,可开展多任务学习研究,同时进行情感极性、情绪分类与讽刺检测,以提升模型对复杂情感语义的建模能力。其三,该数据集可作为跨语言情感分析的测试集,评估多语言模型(如mBERT、XLM-R)在低资源语言上的零样本或少样本迁移性能。其四,数据集中的目标与方面信息支持方面级情感分析研究,可衍生出基于注意力机制的细粒度情感预测模型。这些工作将进一步丰富低资源语言NLP研究方向,并为相关社区提供有价值的参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

