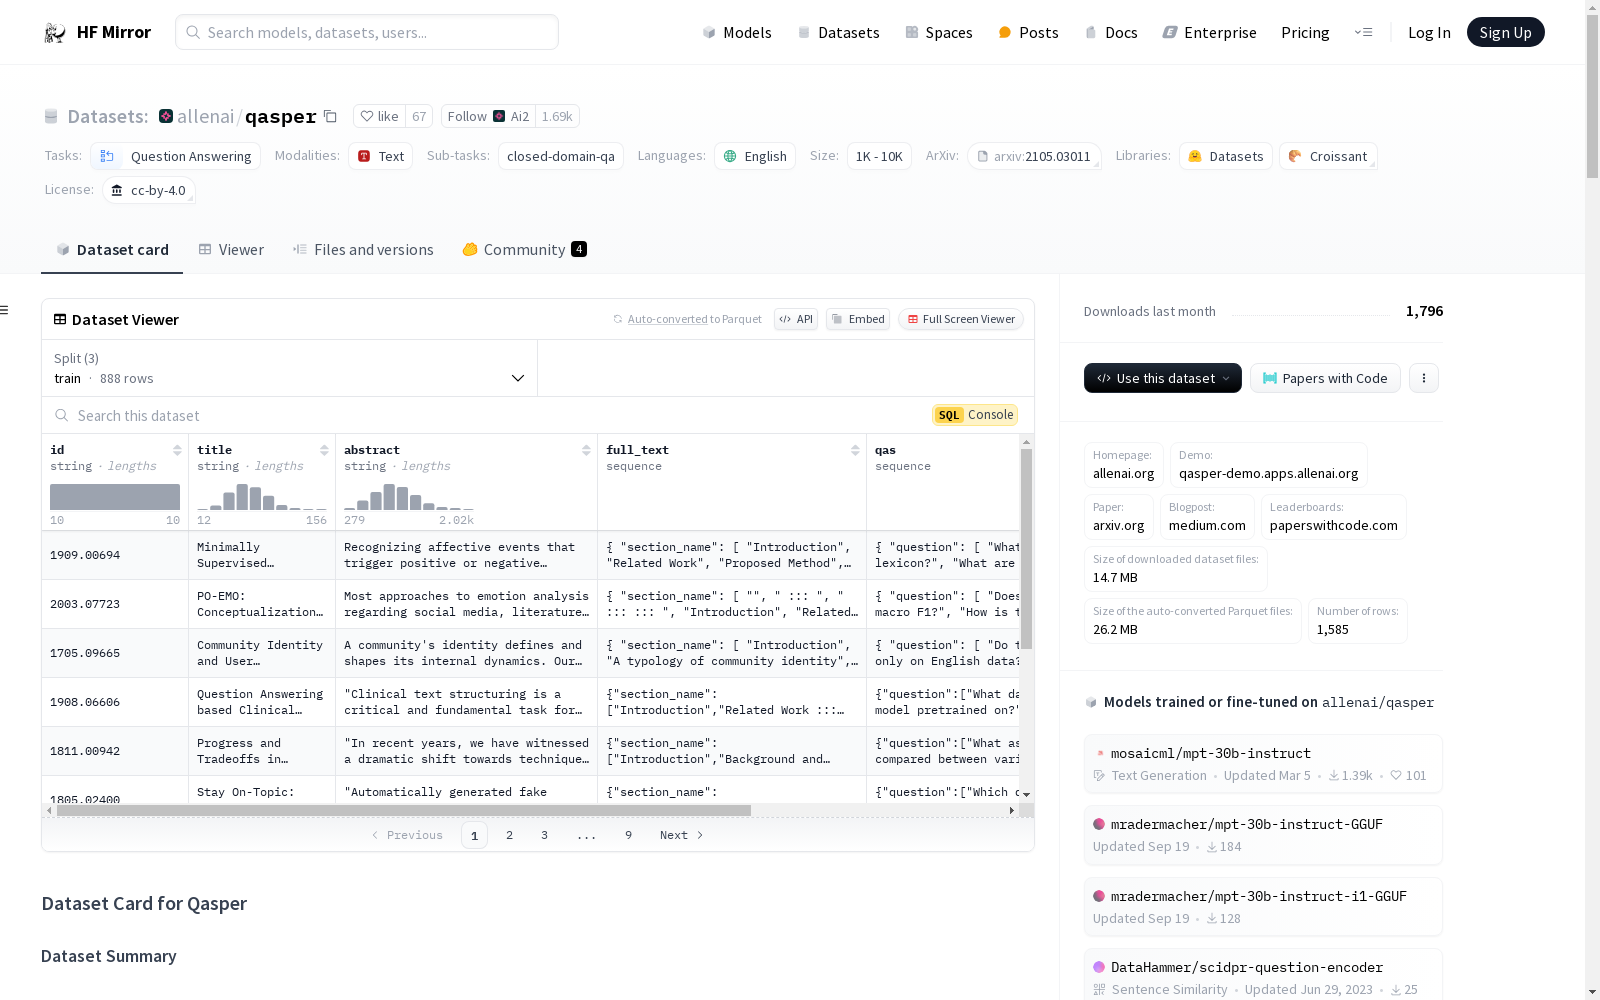
allenai/qasper
收藏资源简介:
QASPER是一个用于科学论文问答的数据集,包含5,049个问题,覆盖1,585篇自然语言处理领域的论文。问题由NLP从业者根据论文的标题和摘要提出,并由另一组NLP从业者提供答案和支持证据。数据集支持的任务包括问答和证据选择,且有一个活跃的排行榜。数据集的语言为英语,数据字段详细解释了问题和答案的相关信息。
QASPER is a dataset designed for scientific paper-based question answering. It contains 5,049 questions spanning 1,585 papers in the field of natural language processing. The questions were formulated by NLP practitioners based on the titles and abstracts of the target papers, while the corresponding answers and supporting evidence were provided by another cohort of NLP practitioners. The tasks supported by this dataset include question answering and evidence selection, and an active leaderboard is maintained for benchmarking. The dataset is in English, and its data fields detail the relevant information associated with both questions and their corresponding answers.
数据集概述
名称: QASPER
语言: 英语(en-US)
许可证: CC BY 4.0
多语言性: 单语
大小: 10K<n<100K
来源数据集: 扩展自s2orc
任务类别: 问答(question-answering)
任务ID: closed-domain-qa
论文代码ID: qasper
数据集描述
概述: QASPER是一个针对科学研究论文的问答数据集,包含5,049个问题,涉及1,585篇自然语言处理(NLP)论文。每个问题由阅读了论文标题和摘要的NLP实践者编写,旨在从全文获取信息。问题的答案由另一组NLP实践者提供,并附有支持证据。
支持的任务和排行榜:
- 问答(question-answering): 用于训练问答模型,成功标准为高F1分数。官方基线模型使用Longformer,当前Token F1分数为33.63。
- 证据选择(evidence-selection): 用于训练证据选择模型,成功标准为高F1分数。官方基线模型使用Longformer,当前F1分数为39.37。
数据集结构
数据实例: 每个实例包括论文ID、标题、摘要、全文(包含段落和节标题)、问题和答案(包括回答者ID、答案内容、证据和支持的段落)。
数据字段:
- 问题相关字段: 包括问题编写者的NLP背景、主题背景、是否阅读过论文及搜索查询。
- 答案相关字段: 包括是否可回答、提取的答案段落、自由形式答案、是/否答案、证据和支持的文本段落。
数据分割:
- 训练集: 888篇论文,2593个问题,2675个答案。
- 验证集: 281篇论文,1005个问题,1764个答案。
数据集创建
注释者: 由NLP实践者进行注释,非专家研究人员。
许可证: 数据集遵循CC BY 4.0许可证。
引用信息:
@inproceedings{Dasigi2021ADO, title={A Dataset of Information-Seeking Questions and Answers Anchored in Research Papers}, author={Pradeep Dasigi and Kyle Lo and Iz Beltagy and Arman Cohan and Noah A. Smith and Matt Gardner}, year={2021} }