
遇见数据集

nassimjp/perfect-pashto-reasoning-sft

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

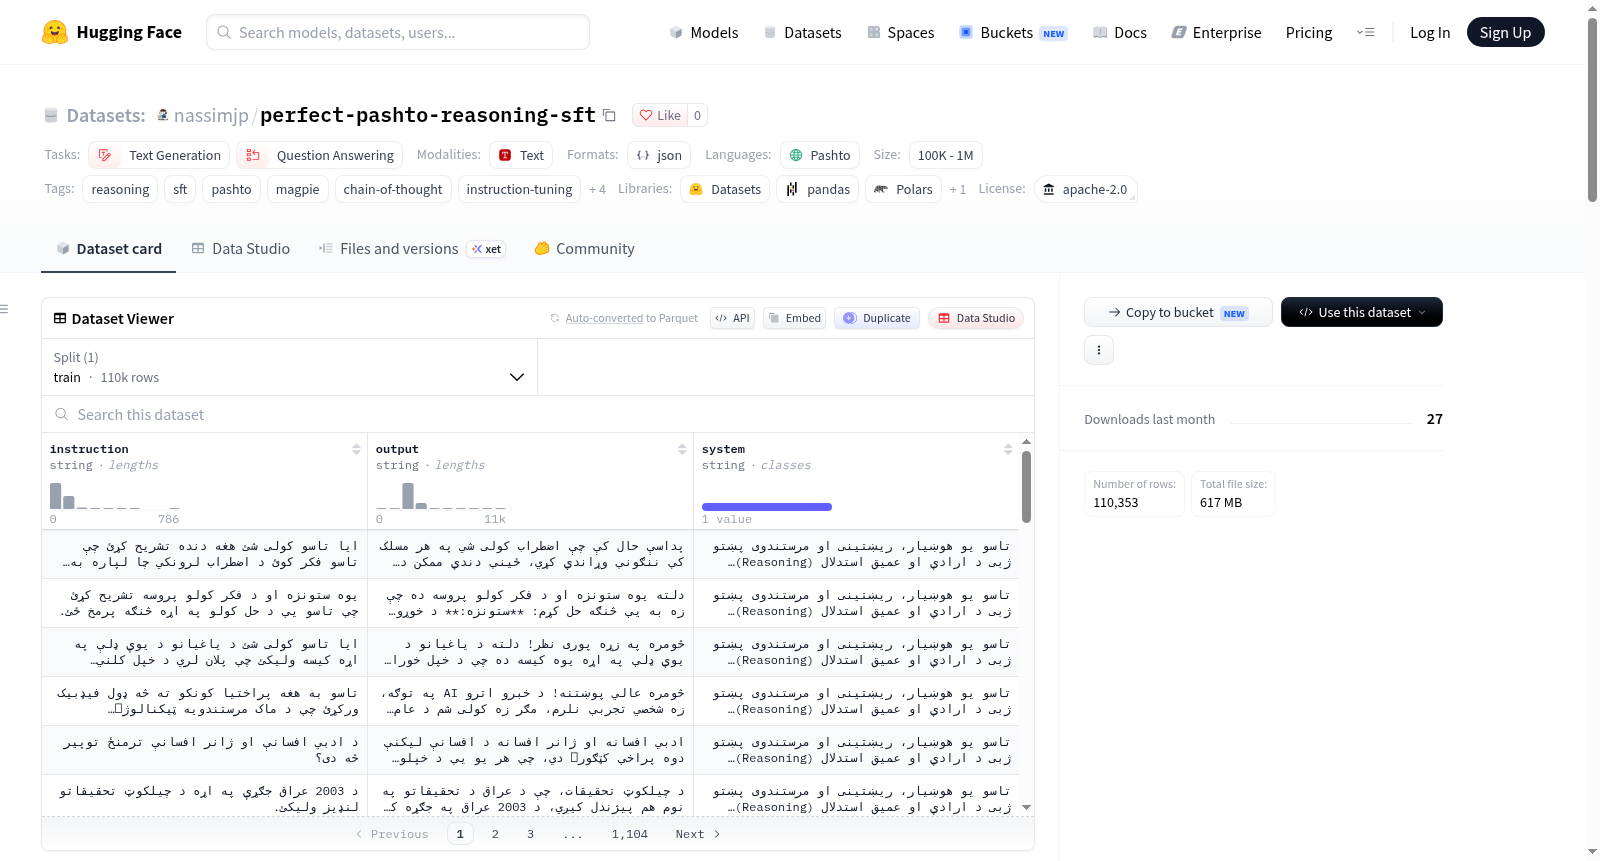
该数据集是基于Magpie-Pro-300K-Filtered数据集构建的,专为普什图语(Pashto)大语言模型和AI社区全新设计和处理的高质量推理数据集。所有数据以原子和逐行方式翻译,并以高质量重新格式化,以确保与Hugging Face的alignment-handbook直接兼容。其目标是为普什图语新一代模型(如Rawan和Ghanam系列)提升监督微调(SFT)和深度推理(链式思考)能力。数据集包含300,000个样本,其中训练集270,000个,测试集30,000个,格式为JSONL。每个记录包含system、instruction和output三个关键字段,分别表示模型身份和推理框架、用户普什图语问题或任务、以及标准、流畅、高质量的普什图语逻辑答案。数据集经过去重、原子对齐、智能分块和高质量控制等处理,适用于监督微调、链式思考、普什图语指令遵循、学术、技术和创意写作以及合成数据生成等领域。

This dataset is built based on the Magpie-Pro-300K-Filtered dataset, specifically engineered and processed from scratch for the Pashto LLM and AI community. All data has been translated atomically and line-by-line, and reformatted with high quality to directly align with the alignment-handbook. Its goal is to enhance Supervised Fine-Tuning (SFT) and Deep Reasoning (Chain-of-Thought) capabilities for new-generation Pashto models (such as the Rawan and Ghanam series). The dataset contains 300,000 examples, with 270,000 for training and 30,000 for testing, in JSONL format. Each record includes three key fields: system (model identity and reasoning framework), instruction (user query or task in Pashto), and output (logical answer in standard, fluent, and high-quality Pashto). It has undergone deduplication, atomic alignment, intelligent chunking, and high-quality control, and is suitable for Supervised Fine-Tuning, Chain-of-Thought reasoning, Pashto instruction following, academic, technical, and creative writing, and synthetic data generation.
提供机构:
nassimjp
搜集汇总
数据集介绍
nassimjp/perfect-pashto-reasoning-sft 数据集图片
构建方式
在低资源语言模型亟需高质量微调数据的背景下,该数据集以Magpie-Pro-300K-Filtered为源,采用逐行原子化翻译策略,将每个指令与输出对独立译入普什图语,以规避索引错位;继而借助MD5哈希剔除重复与低质样本,对长文本实施逻辑分块与自然重组,并经人工与自动双重校验优化语法与连贯性;最终将数据重构为system、instruction、output三元组格式,按9:1划分训练集与测试集。
特点
该数据集面向普什图语深层推理与指令跟随,汇萃30万条样本,其中训练集27万、测试集3万。其核心特质在于原子级对齐确保指令与响应严格配对,去重与分块策略提升数据纯净度与逻辑完整,格式完全兼容alignment-handbook,便于直接用于监督微调与思维链训练,为普什图语大模型如Rawan、Ghanam系列提供高质量语料。
使用方法
使用者可经由Hugging Face datasets库加载该数据集,直接获取train_sft与test_sft两个划分,数据字段包含system、instruction与output,适配alignment-handbook训练流程。在监督微调中,将system字段作为模型身份提示,instruction与output分别作为输入与标签,即可开展指令跟随与推理能力优化,亦可用于思维链蒸馏、学术写作及合成数据生成等下游任务。
背景与挑战
背景概述
普什图语作为低资源语言,长期缺乏高质量的指令微调与推理数据集,制约了大型语言模型在普什图语社区的发展。Perfect Pashto Reasoning SFT数据集应运而生,由普什图语LLM与AI社区基于Magpie-Pro-300K-Filtered数据集构建,于2024年发布。该数据集包含30万条样本,旨在提升普什图语模型的监督微调与深度推理能力,为Rawan、Ghanam等模型提供训练支持,推动了低资源语言在推理任务上的研究进展。
当前挑战
该数据集面临双重挑战。在领域问题上,普什图语推理任务需克服语言资源稀缺、语法复杂性和文化适配性等困难,以实现准确的指令跟随与逻辑推理。在构建过程中,原子级翻译需确保语义对齐,避免索引错位;去重时需平衡数据多样性与质量;长文本分块与重组需维持逻辑连贯;人工校验需耗费大量精力以保证语言自然性。此外,与alignment-handbook格式的兼容性调整也增加了工程复杂性。
常用场景
经典使用场景
在低资源语言模型适配的研究中,该数据集最经典的用途是作为普什图语监督式微调的核心语料,通过系统级提示词、指令与输出三元组结构,引导模型习得链式推理能力。研究者常将其直接接入alignment-handbook等标准微调框架,用于训练具备深度推理能力的基础模型,如Rawan或Ghanam系列,从而在普什图语指令遵循与复杂问题求解任务上获得显著性能提升。
实际应用
在实际应用中,该数据集广泛服务于普什图语智能助手、教育问答系统与跨语言信息检索工具的研发。开发者利用其构建面向学术、技术与创意写作的对话代理,支持普什图语用户以自然语言获取逻辑严密的解答。同时,它也为低资源语言的合成数据生成与模型对齐提供了可复用的工程范式,降低了普什图语AI产品的开发门槛。
衍生相关工作
以该数据集为基石,衍生了一系列针对普什图语推理能力的经典工作,包括基于Rawan与Ghanam架构的微调模型、普什图语链式思维评测基准以及多语言对齐方法的对比研究。这些工作进一步探索了指令格式转换、长文本分块策略与去重机制对下游任务的影响,为后续低资源语言推理数据集的构建提供了重要参考与改进方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

