us-caselaw-va
收藏资源简介:
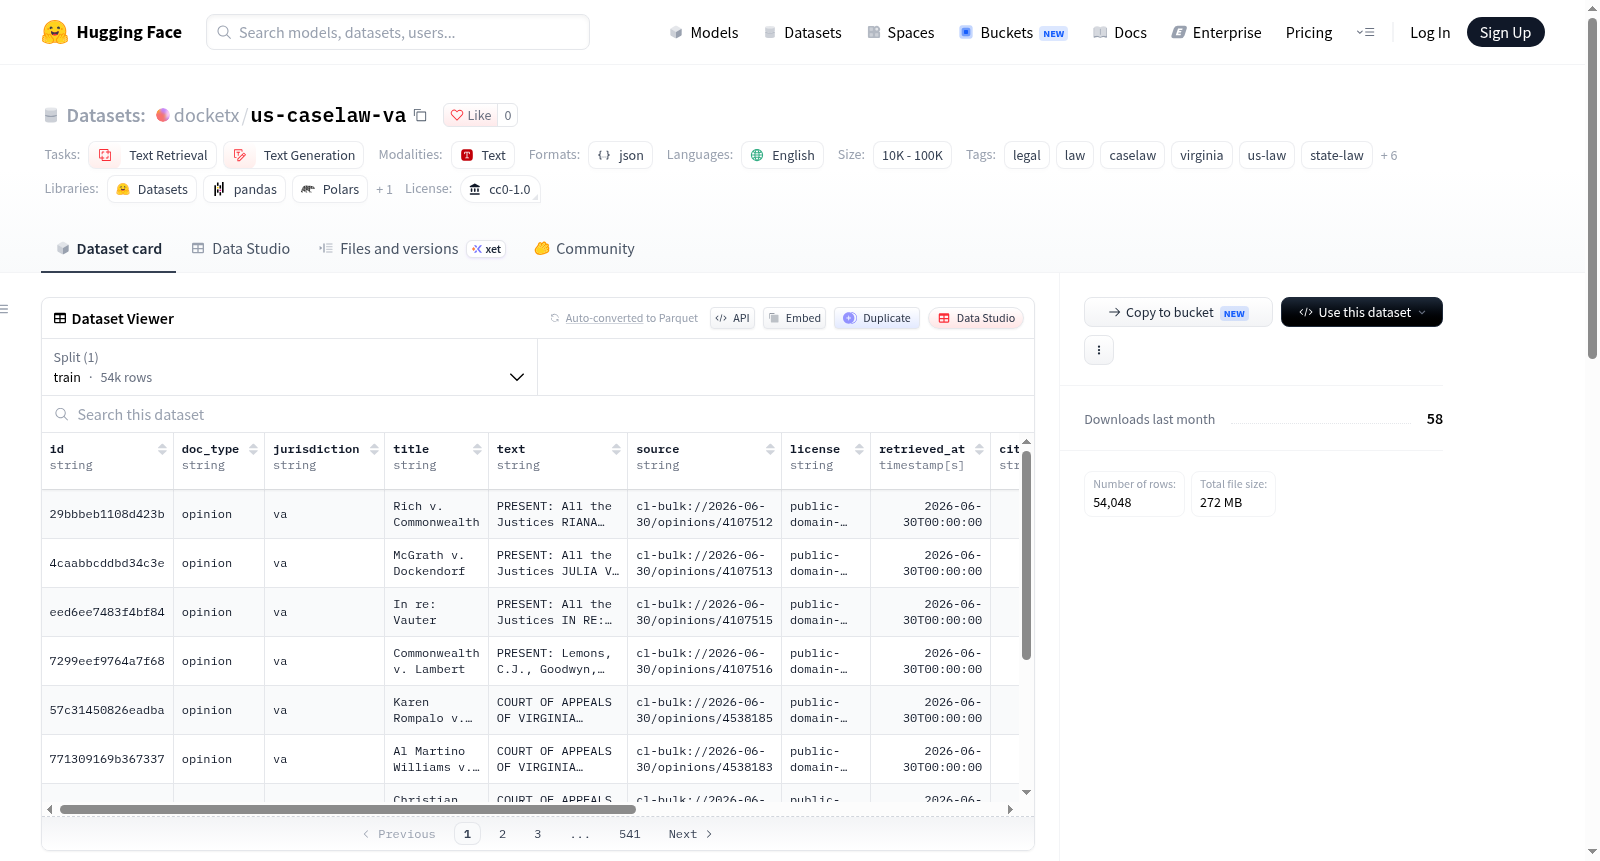
Virginia Case Law 是一个包含 54,048 份弗吉尼亚州上诉法院意见全文的数据集。这些文本源自 Free Law Project / CourtListener 在 2026-06-30 的批量导出,属于公开记录。数据集涵盖两个法院(va 和 vactapp),包括主要意见和单独意见,仅排除字符数少于 1 的文档。在精确地切片中,约 91.5% 的文档文本长度超过 2000 字符,7.2% 在 200 至 1999 字符之间,1.3% 少于 200 字符(这些短文档为真实记录,如调卷令驳回、单行命令和判决登记,故意保留以构成完整的公共记录)。数据格式遵循 docketx record v1 规范,每条记录包含 id、doc_type、jurisdiction、title、text、source、license、retrieved_at、citation、court、date 以及 extra(包含 CourtListener 意见/案件集 ID 和意见类型)。由于司法意见属于政府法令,本身为公共领域作品,此打包版本采用 CC0 1.0 许可发布,未添加任何额外标注或修改。该数据集适用于文本检索(text-retrieval)和文本生成(text-generation)任务,尤其适合法律领域的 RAG、检索、法律 NLP 和法律研究等应用场景。
Virginia Case Law is a dataset containing the full text of 54,048 Virginia appellate court opinions. These texts originate from a bulk export of Free Law Project / CourtListener dated 2026-06-30 and are public records. The dataset covers two courts (va and vactapp), includes majority and separate opinions, and only excludes documents with fewer than 1 character. In precise slicing, approximately 91.5% of documents have text length exceeding 2000 characters, 7.2% have between 200 and 1999 characters, and 1.3% have fewer than 200 characters (these short documents are real records such as certiorari denials, single-line orders, and judgment entries, intentionally retained to form a complete public record). The data format follows the docketx record v1 specification; each record includes id, doc_type, jurisdiction, title, text, source, license, retrieved_at, citation, court, date, and extra (containing CourtListener opinion/docket IDs and opinion type). Since judicial opinions are government edicts and thus public domain works, this packaged version is released under the CC0 1.0 license without any additional annotations or modifications. This dataset is suitable for text-retrieval and text-generation tasks, especially for legal-domain RAG, retrieval, legal NLP, and legal research applications.
Virginia Case Law 数据集概述
基本信息
- 数据集名称:Virginia Case Law
- 数据集地址:https://huggingface.co/datasets/docketx/us-caselaw-va
- 许可证:CC0 1.0
- 语言:英语(en)
- 数据规模类别:10K < n < 100K
- 任务类别:文本检索(text-retrieval)、文本生成(text-generation)
- 标签:legal、law、caselaw、virginia、us-law、state-law、court-opinions、public-domain、rag、retrieval、legal-nlp、legal-research
- 配置文件:默认配置(default),数据文件位于
data/*.jsonl.gz
数据内容
- 收录 54,048 份弗吉尼亚州上诉法院意见文档的全文,来源为公开记录。
- 数据切片自 Free Law Project / CourtListener 于 2026-06-30 的批量导出。
- 法院覆盖范围:2 个法院标识(显式白名单,从不使用前缀匹配):
va、vactapp。 - 包含主意见(lead opinions)与单独意见(separate opinions);排除长度少于 1 个字符的文档。
- 切片 sha256 值:
8fcf1c833daeccadd8c383082c70911a7aab676aebe3518c1ffb2e7271d1a140(亦记录于slice.manifest.json)。
数据构成
基于该切片的实测统计:
- 49,456 份文档(91.5%)文本长度在 2,000 字符以上。
- 3,892 份文档(7.2%)文本长度在 200–1,999 字符之间。
- 700 份文档(1.3%)文本长度在 200 字符以下。
- 短文档为真实记录而非错误,包括调卷令驳回(certiorari denials)、单行命令和判决登记条目。
- 因其设定
min_chars = 1,这些短文档被有意保留,以保证数据为完整的公开记录而非经过过滤的子集。 - 若仅需实质性意见,可按
len(text)进行过滤。
数据格式
- 每行遵循 docketx record v1 格式(每行一条意见)。
- 字段包括:
id、doc_type、jurisdiction、title、text、source、license、retrieved_at,以及citation、court、date和extra(CourtListener 的 opinion/cluster id、意见类型)。 - 所有 docketx 数据集均使用相同的格式。
来源与许可
- 司法意见为政府法令,属于不可受版权保护的公有领域作品(依据 Banks v. Manchester, 128 U.S. 244 (1888);Georgia v. Public.Resource.Org, 590 U.S. 255 (2020))。
- 本数据打包以 CC0 1.0 发布。
- 来源:CourtListener 批量导出(2026-06-30),Free Law Project — https://free.law
- 本数据集重新分发公有领域的法院文本,不添加任何标注,也不主张任何权利。
加载方式
python from datasets import load_dataset ds = load_dataset("docketx/us-caselaw-va")
相关资源
- 属于 DocketRouter 法律语料库:https://huggingface.co/docketx