
遇见数据集

Vietnam Listed Companies Annual Reports Dataset (2000–2025)

收藏
github2026-06-28 更新2026-06-29 收录
官方服务:

资源简介:

这是一个结构化数据集,收集了越南股票市场上市公司从2000年至2025年共25年的年度报告PDF文件,按股票代码组织,适用于公司披露研究、文本挖掘、自然语言处理、ESG分析和越南资本市场研究。

This is a structured dataset collecting PDF files of annual reports of listed companies on the Vietnamese stock market spanning 25 years from 2000 to 2025, organized by stock ticker code. It is applicable to corporate disclosure research, text mining, natural language processing, ESG analysis, and Vietnamese capital market research.

创建时间:
2026-06-27
原始信息汇总

数据集概述

该数据集为越南上市公司年度报告数据集(2000–2025),由 Ngo Phu Thanh 创建,版本号为 1.0.0。数据集收录了越南上市公司在 2000 年至 2025 年间发布的年度报告(Báo cáo thường niên),并提供 PDF 格式的结构化文档集合。

数据组织与格式

  • 覆盖范围:越南上市公司,时间跨度为 2000 年至 2025 年。
  • 文件格式:PDF。
  • 组织方式:按股票代码(Ticker)进行目录划分。
  • 文件命名规则{TICKER}_{YY}N_BCTN.pdf(标准年份)和 {TICKER}_{YY}CN_BCTN.pdf(当前年份变体),例如 ACB_19N_BCTN.pdf 代表 ACB 公司 2019 年的年度报告,ACB_25CN_BCTN.pdf 代表 ACB 公司 2025 年的年度报告。

文件夹结构

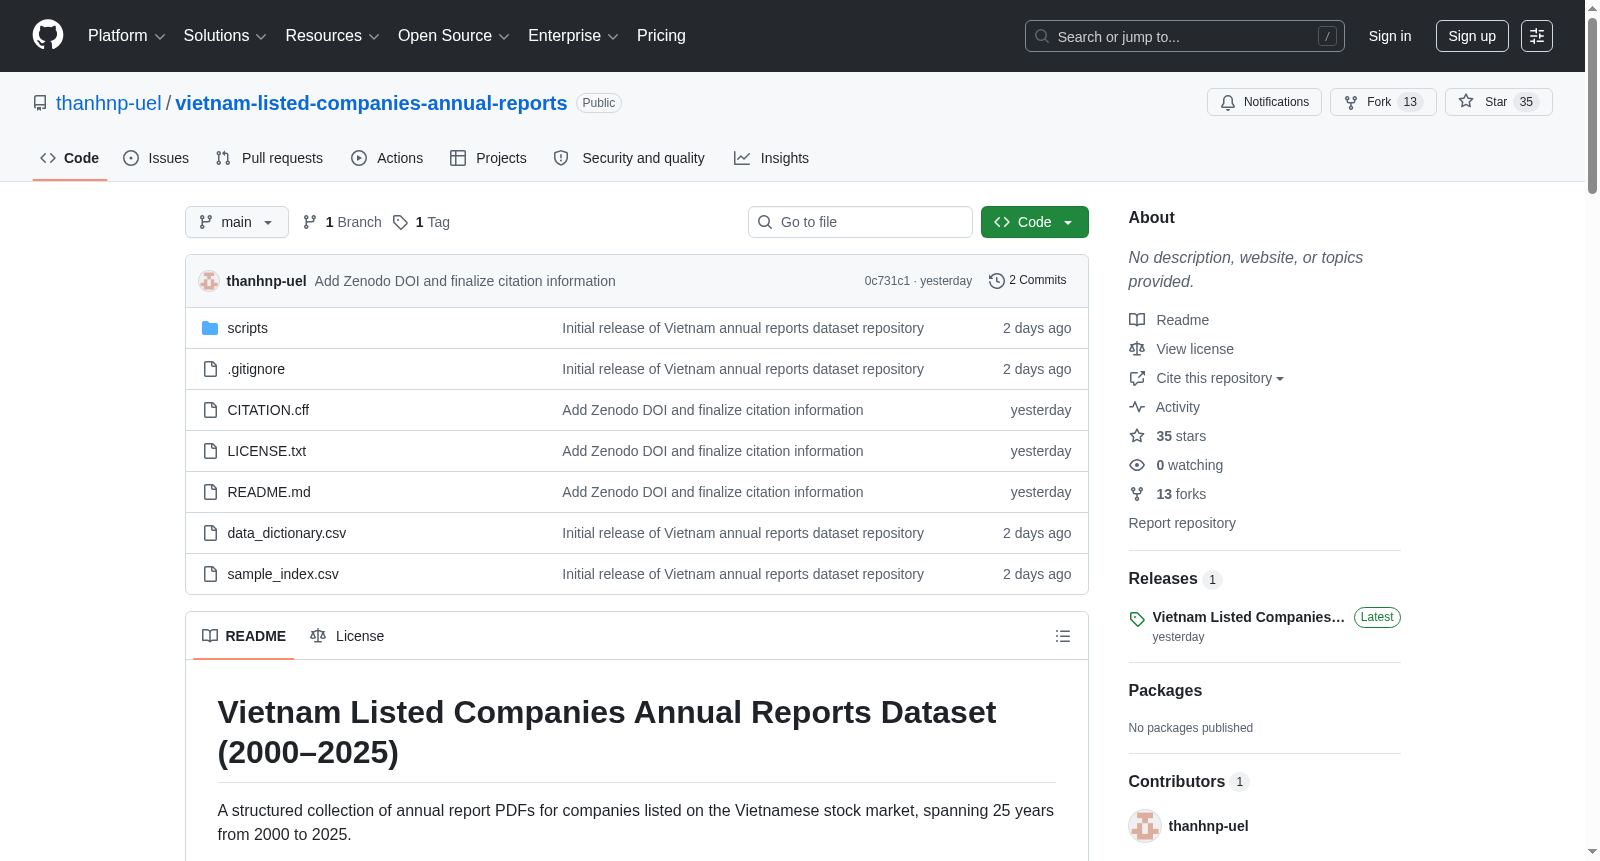
数据存放于 full_data/ 目录下,每个股票代码对应一个子文件夹,例如:

  • full_data/ACB/ 包含 ACB 公司各年份的 PDF 文件。
  • full_data/CTG/ 包含 CTG 公司各年份的 PDF 文件。

元数据文件

提供以下 CSV 格式的元数据文件,便于用户索引和管理:

  • file_index_full.csv:主索引文件,包含股票代码、年份、文件名、路径、文件大小、校验和及状态。
  • checksums_pdf_sha256.csv:所有 PDF 文件的 SHA-256 校验和。
  • checksums_archives_sha256.csv:ZIP 压缩包的 SHA-256 校验和。
  • coverage_by_year.csv:各年份的报告数量。
  • coverage_by_period.csv:各存档周期的报告数量。
  • data_dictionary.csv:所有元数据字段的变量描述。
  • sample_index.csv:文件索引的样本。

数据获取

可通过 Zenodo(https://doi.org/10.5281/zenodo.20949551)下载 ZIP 压缩包。存档文件按时间段划分:

  • vn_bctn_2000_2005.zip:2000–2005 年
  • vn_bctn_2006_2010.zip:2006–2010 年
  • vn_bctn_2011_2015.zip:2011–2015 年
  • vn_bctn_2016_2020.zip:2016–2020 年
  • vn_bctn_2021_2025.zip:2021–2025 年

仓库内容

GitHub 仓库包含:

  • README.md:本说明文件
  • CITATION.cff:引用元数据
  • LICENSE:许可证信息
  • data_dictionary.csv:元数据变量描述
  • sample_index.csv:文件索引样本
  • scripts/:用于索引和打包的 Python 脚本
  • docs/:附加文档

使用场景

适用于以下研究领域:

  • 公司信息披露研究
  • 会计与金融研究
  • 文本挖掘与自然语言处理
  • ESG 披露分析
  • 年度报告可读性研究
  • 数字化转型披露研究
  • 越南股票市场研究

引用方式

bibtex @dataset{ngo2026vietnam, author = {Ngo, Phu Thanh}, title = {Vietnam Listed Companies Annual Reports PDF Dataset, 2000--2025}, year = {2026}, version = {1.0.0}, publisher = {Zenodo}, doi = {10.5281/zenodo.20949551}, url = {https://doi.org/10.5281/zenodo.20949551} }

作者信息

Ngo Phu Thanh
越南经济与法律大学(UEL)
邮箱:thanhnp@uel.edu.vn
搜集汇总
数据集介绍
Vietnam Listed Companies Annual Reports Dataset (2000–2025) 数据集图片
构建方式
该数据集系统性地整合了越南证券交易所上市企业自2000年至2025年间发布的年度报告(Báo cáo thường niên),以PDF格式存储。数据按照股票代码进行组织,每个公司的报告文件均以标准化命名规则呈现,例如ACB_19N_BCTN.pdf代表ACB公司2019年的标准年度报告。数据集通过Zenodo平台分阶段发布,按五年为一档(如2000–2005、2006–2010等)打包为ZIP压缩包,并辅以完整的元数据索引文件(file_index_full.csv)、SHA-256校验和文件以及覆盖统计表,确保了数据的可验证性与易用性。构建过程借助scripts/目录下的Python脚本实现索引重建与数据审计,为研究者提供了可靠的数据基础。
特点
该数据集具有显著的时空覆盖广度与结构化优势,横跨四分之一个世纪的越南资本市场信息披露历史,为纵向比较研究提供了珍贵素材。数据以原始PDF格式保存,保留了年报的完整排版与图表信息,非常适用于文本挖掘、自然语言处理及ESG披露分析等深度应用。文件命名与目录结构高度规范化,支持按股票代码和年份快速定位,降低了数据清洗与预处理的复杂度。此外,数据集提供了详尽的元数据字典(data_dictionary.csv)与多维覆盖统计文件,使研究者能够直观掌握各时期、各公司的报告收录情况,提升了数据的透明度和可用性。
使用方法
使用者首先需从Zenodo平台下载对应的ZIP压缩档案,并将其解压至同一目录下。随后,可借助file_index_full.csv元数据索引文件,通过股票代码与年份的组合精准检索所需报告。为确保数据完整性,建议利用checksums_pdf_sha256.csv进行SHA-256校验。为便于批量处理,数据集还提供了scripts/目录下的Python脚本,可用于重建索引或验证文件一致性。该数据集特别适合用于公司披露行为分析、会计与金融研究、年报可读性评估、数字化转型披露以及越南股票市场相关课题,研究者可根据具体需求灵活调用PDF内容进行文本解析或统计分析。
背景与挑战
背景概述
在越南资本市场持续扩张的背景下,企业信息披露的透明度与可获取性成为学术研究与政策制定的关键支撑。由胡志明市经济法律大学Ngo Phu Thanh研究员创建并于2025年发布的Vietnam Listed Companies Annual Reports数据集,系统收集了2000年至2025年间越南上市公司逾两万份年度报告PDF文件。该数据集以股票代码为组织架构,覆盖四分之一个世纪的财务与治理信息,旨在突破越南语企业文本数据的稀缺瓶颈,为信息披露质量、文本挖掘、自然语言处理及ESG分析等研究领域提供结构化基础资源。其诞生填补了东南亚新兴市场长期企业报告数据集的空白,为比较公司治理与资本市场监管研究注入了新的实证维度。
当前挑战
该数据集面临的核心挑战源于越南企业信息披露的非标准化现实。首先,不同上市公司年报格式迥异、篇幅悬殊,且大量包含表格与扫描图像,导致光学字符识别与文本解析的准确率难以保障,妨碍了NLP模型的跨公司可比性分析。其次,为期25年的跨度带来了文件格式与命名规则的演变,早期纸质报告数字化后质量参差不齐,增加了元数据对齐与校验的复杂度。此外,构建过程中需应对东南亚方言术语、公司更名与退市等动态因素,确保索引的完整性,这对正则表达式规则与人工审核构成了双重考验。数据版权与隐私边界亦需谨慎处理,以在公开共享与合规要求之间达成平衡。
常用场景
经典使用场景
在金融与会计领域,越南上市公司年报数据集(2000–2025)为研究者提供了跨越25年的结构化公司信息披露文本,覆盖了越南股市中所有上市企业的年度报告PDF文件。该数据集最经典的使用场景集中于公司披露行为研究、文本挖掘与自然语言处理、以及ESG分析。基于股票代码和年份的命名与组织方式,使得研究者能够轻松关联年报内容与公司特征、财务数据,从而开展如年报可读性测度、信息披露质量评价、数字化转型披露趋势等主题的实证研究。这一时间跨度的广度和结构化的元数据,使其成为越南资本市场研究中不可替代的基础资源。
解决学术问题
该数据集有效解决了越南公司治理与资本市场研究中长期存在的数据稀缺与碎片化困境。过去,学者若要获取越南上市公司的历史年报文本,往往面临分散收集、格式不一、难以批量处理等障碍,严重制约了以文本分析为核心的研究范式。该数据集通过系统化的方式汇集了2000年至2025年间所有上市公司的年报PDF,并辅以完整的文件索引、校验和及元数据描述,使得研究者能够大规模、可复现地进行信息披露文本分析。基于此,学术界得以深入探讨年报信息含量、管理层语调策略、ESG披露实践以及数字转型对信息披露的影响等前沿议题,极大地推动了越南乃至新兴市场公司治理与会计领域的实证研究发展。
衍生相关工作
基于该数据集的开放性和结构化特征,学界与业界已发展出一系列衍生工作与创新成果。在计算语言学领域,研究者通过该数据集训练了针对越南语金融文本的领域专用语言模型(如ViFinBERT),显著提升了年报中情感分析与信息抽取的精度。在ESG研究方面,衍生工作构建了越南上市公司环境、社会与治理披露指数,揭示了信息披露与企业财务绩效间的非线性关系。此外,基于年报文本的可读性测度方法对比研究、以及基于深度学习的企业财务困境预测模型,均是该数据集催生的典型衍生成果。这些工作不仅扩展了数据集的应用边界,也为新兴市场背景下的公司金融与文本分析研究提供了可迁移的分析范式与基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

