wenbopan/Fusang-v1
收藏资源简介:
Fusang-V1是一个多样化的指令调优数据集,专注于提升双语和长上下文语言模型的能力。数据集包含超过120万条基础样本和14万条长样本,涵盖数学、代码、角色扮演、函数调用等多种任务。数据集支持中英双语,并包含专门用于长上下文建模的`long`部分,样本长度通常超过4K。`base`部分主要来源于OpenHermes-2.5及其中文翻译版本,以及其他增强双语和工具使用能力的数据集。`long`部分则包含高质量的长上下文数据集,平均标记长度约为18K。
Fusang-V1是一个多样化的指令调优数据集,专注于提升双语和长上下文语言模型的能力。数据集包含超过120万条基础样本和14万条长样本,涵盖数学、代码、角色扮演、函数调用等多种任务。数据集支持中英双语,并包含专门用于长上下文建模的`long`部分,样本长度通常超过4K。`base`部分主要来源于OpenHermes-2.5及其中文翻译版本,以及其他增强双语和工具使用能力的数据集。`long`部分则包含高质量的长上下文数据集,平均标记长度约为18K。
数据集概述
数据集名称: Fusang-V1
语言: 中文、英文
许可证: Apache-2.0
大小分类: 1M<n<10M
任务分类: 文本生成
数据集特征
基本特征
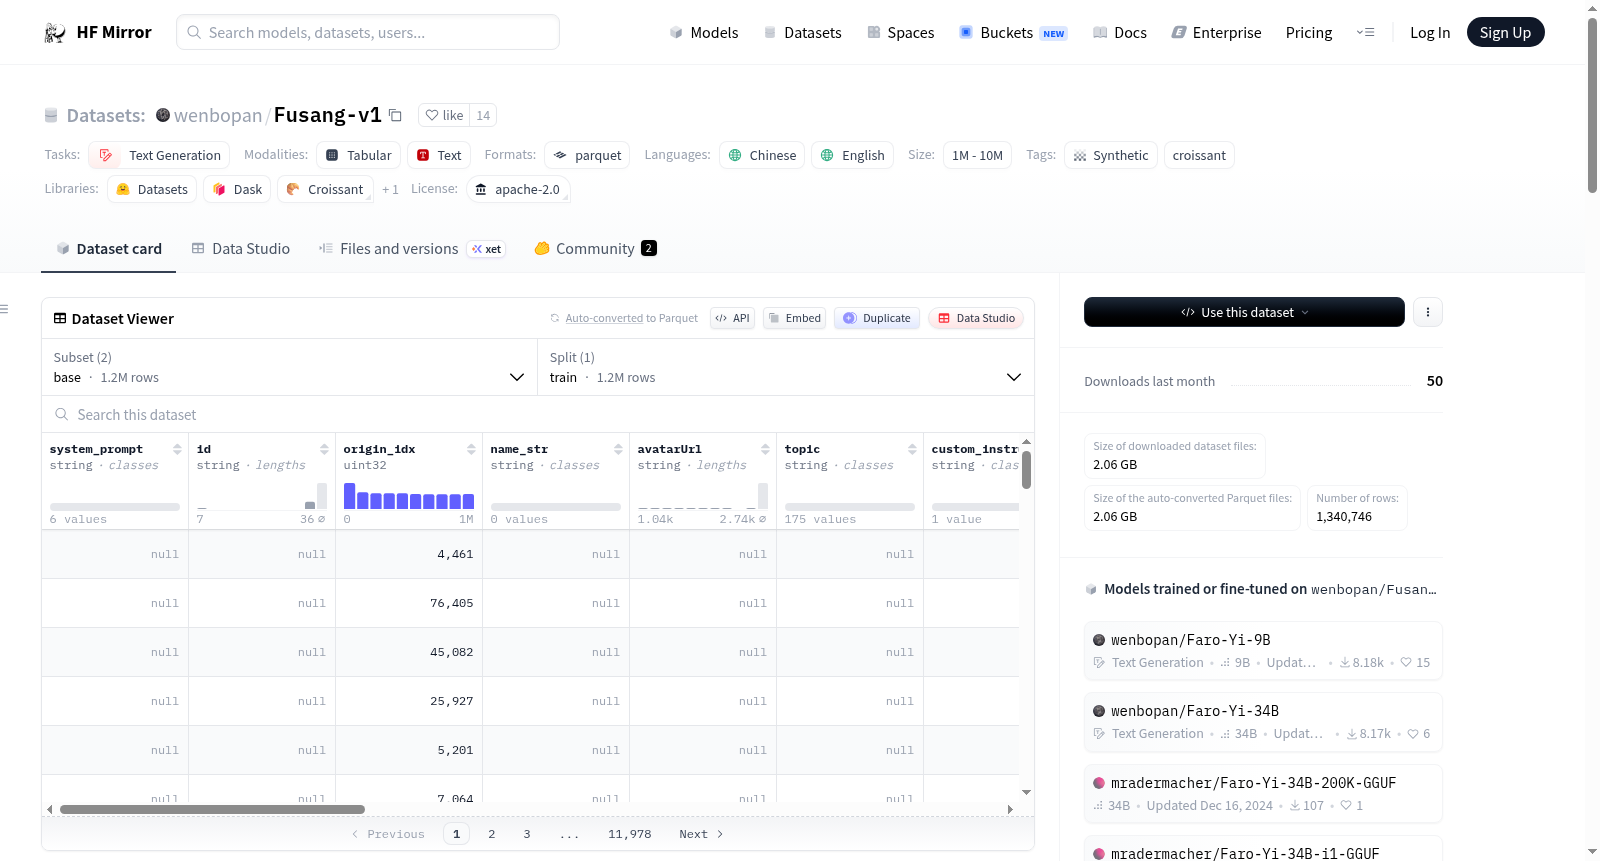
- system_prompt: 字符串
- id: 字符串
- origin_idx: 无符号32位整数
- name_str: 字符串
- avatarUrl: 字符串
- topic: 字符串
- custom_instruction: 字符串
- views: 32位整数
- hash: 字符串列表
- idx: 字符串
- source: 字符串
- conversations: 列表,包含:
- from: 字符串
- value: 字符串
- weight: 8位整数
- title: 字符串
- category: 字符串
- skip_prompt_formatting: 布尔值
- model: 字符串
- language: 字符串
- total_input_tok_len: 32位整数
- total_output_tok_len: 32位整数
数据集配置
- base:
- 训练集: 1197792个样本,2329677556字节
- 下载大小: 1122940740字节
- 数据集大小: 2329677556字节
- default:
- 下载大小: 2056593730字节
- 数据集大小: 4247645405字节
- long:
- 训练集: 142954个样本,1918053558字节
- 下载大小: 933750027字节
- 数据集大小: 1918053558字节
数据集来源
Fusang-v1-base
- 主要来源: OpenHermes-2.5
- 中文翻译: OpenHermes-2.5-zh
- 事实检索对话: RefGPT-Fact-v2
- 函数调用: glaive-function-calling-v2
Fusang-v1-long
- 长上下文数据: wenbopan/RefGPT-Fact-v2-8x
- 长对齐数据: THUDM/LongAlign-10k
- 长QA数据: Yukang/LongAlpaca-12k
- 反干草堆测试: wenbopan/anti-haystack
引用信息
@misc{Fusang-V1, title = {Fusang-V1: A large curation of instruction-tuning datasets for better bilingual and long-range LLMs}, author = {Wenbo Pan}, year = {2024}, publisher = {HuggingFace}, url = {https://huggingface.co/datasets/wenbopan/Fusang-v1} }