
遇见数据集

multilingual-tts/open-bible

收藏
Hugging Face2026-05-25 更新2026-05-31 收录
官方服务:

资源简介:

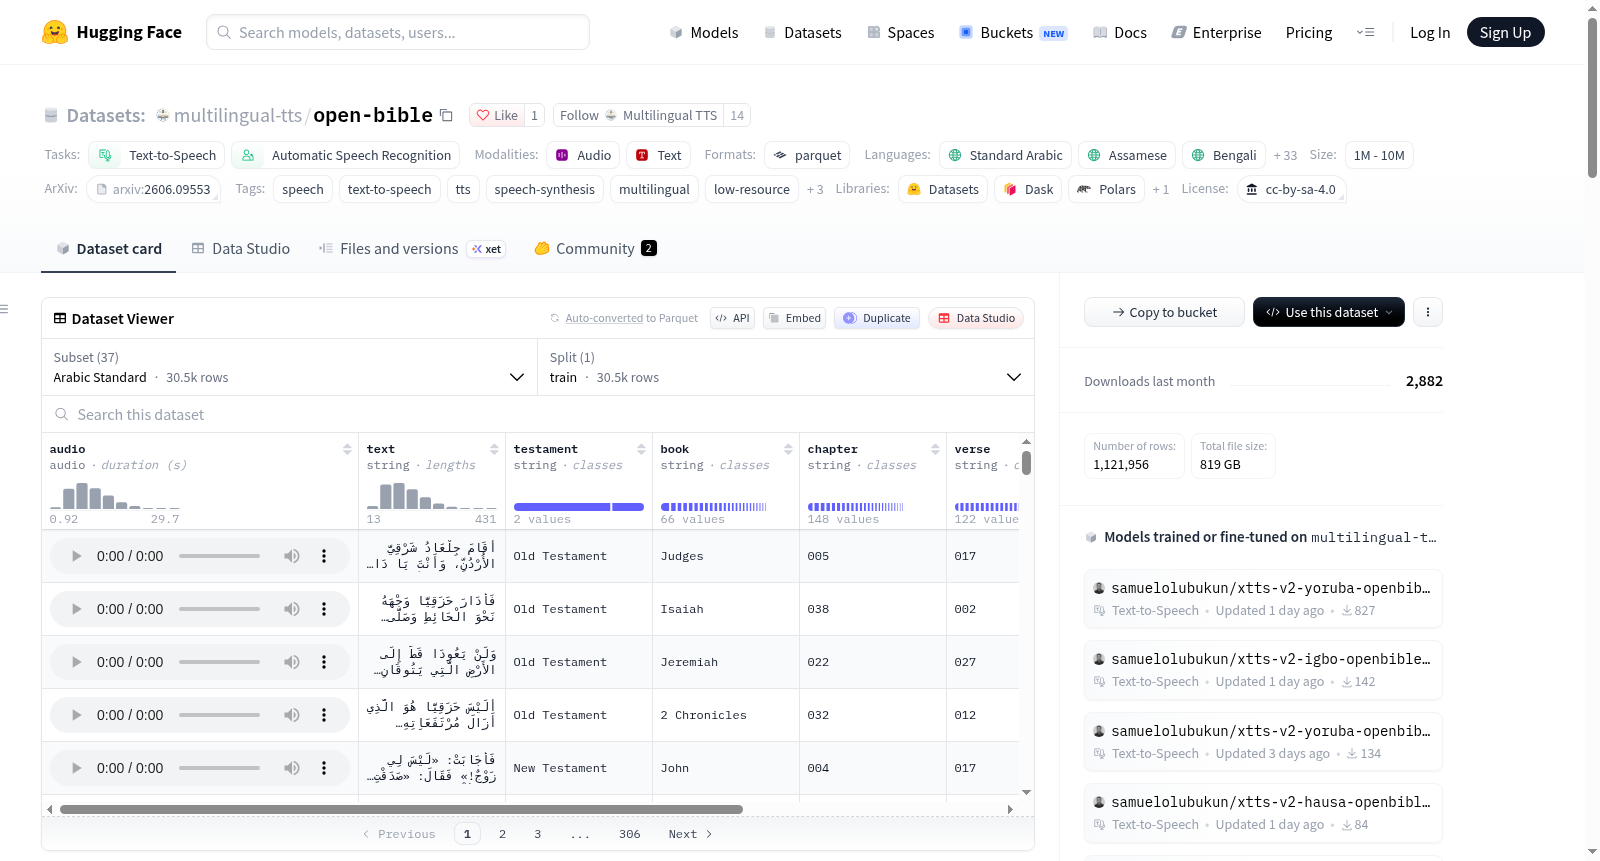
这是一个多语言音频-文本数据集,涵盖35种语言(包括阿拉伯语、阿萨姆语、孟加拉语、中央库尔德语、恰蒂斯加尔语、奇切瓦语、达夫罗语、德霍卢奥语、埃维语、加莫语、戈法语、古吉拉特语、海地克里奥尔语、豪萨语、希利盖农语、印地语、伊博语、卡纳达语、基库尤语、林加拉语、卢干达语、马拉雅拉姆语、马拉地语、恩德贝莱语、尼泊尔语、奥罗莫语、旁遮普语、绍纳语、斯瓦希里语、泰米尔语、泰卢固语、土耳其语、特威语(阿库阿佩姆和阿桑特)、乌尔都语、越南语和约鲁巴语)。每个样本包含音频文件、对应的文本转录,以及结构化元数据:testament(可能指圣经新旧约)、book(书卷)、chapter(章节)、verse(经文)、音频时长(秒)和说话者ID。数据集仅提供训练集,各语言配置的样本量约28,000至30,000+,总数据规模从约10GB到44GB不等,适用于语音识别、文本到语音或多语言语音处理研究。

This is a multilingual audio-text dataset covering 35 languages (including Arabic Standard, Assamese, Bengali, Central Kurdish, Chhattisgarhi, Chichewa, Dawro, Dholuo, Ewe, Gamo, Gofa, Gujarati, Haitian Creole, Hausa, Hiligaynon, Hindi, Igbo, Kannada, Kikuyu, Lingala, Luganda, Malayalam, Marathi, Ndebele, Nepali, Oromo, Punjabi, Shona, Swahili, Tamil, Telugu, Turkish, Twi (Akuapem and Asante), Urdu, Vietnamese, and Yoruba). Each sample includes an audio file, corresponding text transcription, and structured metadata: testament (likely referring to Biblical Old/New Testament), book, chapter, verse, audio duration in seconds, and speaker ID. The dataset provides only training splits, with approximately 28,000 to 30,000+ samples per language configuration, and total data sizes ranging from about 10GB to 44GB. It is suitable for speech recognition, text-to-speech, or multilingual speech processing research.
提供机构:
multilingual-tts
搜集汇总
数据集介绍
multilingual-tts/open-bible 数据集图片
构建方式
在低资源语言语音技术领域,数据匮乏长期制约着语音合成与识别系统的发展。OpenBibleTTS数据集依托圣经平行语料,采用自动化对齐与人工校验相结合的构建策略,将多语言圣经文本与对应录音进行强制对齐,生成词级时间戳与音素级边界标注。每一语言变体独立成配置,涵盖从文本分割、音频分段到说话人标注的完整流程,最终形成以章节和节为单位的语音-文本配对样本,确保数据在语言覆盖与声学多样性上的均衡。
特点
该数据集在语音资源稀缺的语境中展现出显著的多语言覆盖优势,囊括三十余种语言变体,尤以非洲语言及南亚低资源语种为主。其结构特征体现在细粒度的元数据设计上,每条样本均关联 testament、book、chapter、verse 等文本层级信息以及说话人标识与音频时长,为声学建模与语言学研究提供多维索引。整体规模介于百万至千万级样本之间,音频总时长可观,且所有语料均遵循知识共享许可协议,具备良好的可复现性与伦理合规性。
使用方法
面向语音合成与自动语音识别任务,使用者可通过HuggingFace datasets库按语言配置加载对应数据,调用时指定config_name即可获取包含音频路径与文本转录的样本集。对于TTS训练,可提取音频与文本字段构建声学模型或端到端合成系统;对于ASR,则可利用词级对齐信息进行声学模型预训练或微调。鉴于数据集包含丰富的元数据,研究者还可依据章节与节号进行数据划分,以支持跨语言迁移学习或低资源场景下的少样本学习实验。
背景与挑战
背景概述
近年来,语音合成与自动语音识别领域对多语种、低资源语言的覆盖需求日益迫切,然而全球多数语言仍缺乏高质量语音语料。OpenBibleTTS数据集于2024年前后由研究团队构建并发布于HuggingFace平台,依托平行圣经文本与专业录音,覆盖阿拉伯语、孟加拉语、斯瓦希里语、约鲁巴语等数十种语言,构建规模达数百万条语音-文本样本。该数据集以词级强制对齐方式提供精确时间标注,核心研究问题在于如何借助宗教文本的跨语言平行特性,为低资源语言语音技术提供可扩展的训练与评测基准,对推动多语种语音处理、语言保存及数字包容具有显著影响力。
当前挑战
该数据集所直面的领域难题在于,大量低资源语言长期缺乏标准化语音语料,语音合成与识别模型难以获得充分监督信号,且多语种统一建模需克服语系差异、文字系统多样与录音条件不统一等障碍。构建过程中亦面临多重挑战:平行圣经文本与音频的精确对齐需处理语速变化、方言口音与朗读风格差异;部分语言缺乏成熟书写规范,文本归一化与音素映射困难;录音来源分散导致采样率、信噪比与说话人特征参差不齐;数据规模庞大,存储、清洗与标注一致性维护成本高昂,对数据治理与质量保障机制提出严格要求。
常用场景
经典使用场景
在 multilingual 语音合成与识别研究中,该数据集凭借覆盖 36 种语言、每种语言约 3 万条平行语音-文本对的规模,成为低资源场景下最经典的训练与评测资源。其数据源自圣经朗读,包含音频、文本、章节、节号及说话人标识,天然支持强制对齐任务。研究者常将其用于训练多语言 TTS 和 ASR 模型,尤其在非洲语言等低资源语境下,用以评估跨语言迁移与零样本泛化能力。
实际应用
在实际应用中,该数据集被广泛用于开发面向低资源语言的语音交互系统,例如助力非洲、南亚等地区的教育、宗教与公共服务领域的语音播报与语音识别工具。其多语言平行特性亦支持构建跨语言语音翻译与语音克隆原型,为无文字或弱势语言社区提供可访问的语音技术方案。此外,该数据集还可用于语音数据增强、说话人自适应以及基于圣经文本的特定领域语音系统优化,具有较高的工程落地价值。
衍生相关工作
基于该数据集,研究者相继开展了多语言 TTS 与 ASR 的基线系统构建、跨语言迁移学习、语音强制对齐以及低资源语音表征学习等经典工作。相关衍生研究探索了利用该数据训练多语言声学模型、评估语言间的可迁移性,并催生了面向非洲语言的语音合成挑战与评测任务。这些工作不仅验证了数据集的有效性,也为后续低资源语音资源建设与算法创新提供了重要参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

