
遇见数据集

huggingartists/noize-mc

收藏
Hugging Face2022-10-25 更新2024-03-04 收录
官方服务:

资源简介:

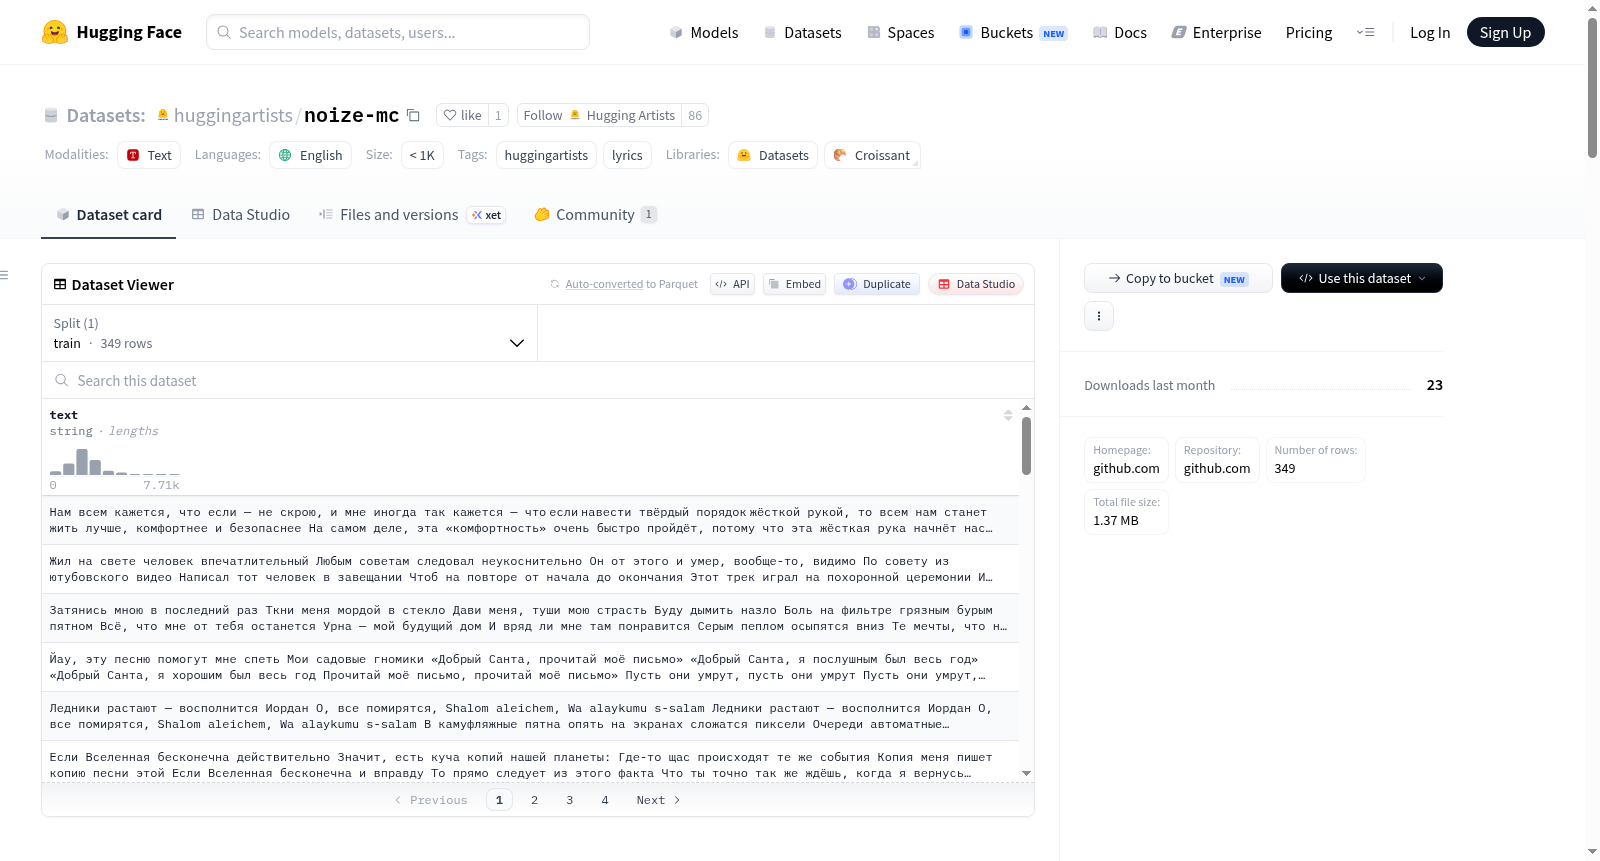
该数据集是从Genius解析的歌词数据集,旨在通过HuggingArtists生成歌词。数据集中包含一个名为text的字段,存储了歌词文本。数据集大小为1.387658 MB,可以通过HuggingFace的datasets库直接加载。

This is a lyrics dataset parsed from Genius, designed for lyrics generation via HuggingArtists. The dataset contains a field named `text` that stores the lyrics text. It has a size of 1.387658 MB and can be directly loaded via the HuggingFace datasets library.

提供机构:
huggingartists
原始信息汇总

数据集概述

数据集名称

"huggingartists/noize-mc"

数据集摘要

该数据集包含从Genius解析的歌词数据,旨在用于生成歌词的HuggingArtists模型。

支持的任务和排行榜

[信息待补充]

语言

英语(en)

数据集结构

数据字段

  • text: 字符串类型,包含歌词文本。

数据分割

  • train: 349条记录
  • validation: 无
  • test: 无

可通过以下代码将训练集分割为训练、验证和测试集:

python from datasets import load_dataset, Dataset, DatasetDict import numpy as np

datasets = load_dataset("huggingartists/noize-mc")

train_percentage = 0.9 validation_percentage = 0.07 test_percentage = 0.03

train, validation, test = np.split(datasets[train][text], [int(len(datasets[train][text])train_percentage), int(len(datasets[train][text])(train_percentage + validation_percentage))])

datasets = DatasetDict( { train: Dataset.from_dict({text: list(train)}), validation: Dataset.from_dict({text: list(validation)}), test: Dataset.from_dict({text: list(test)}) } )

数据集创建

数据来源

[信息待补充]

注释过程

[信息待补充]

个人和敏感信息

[信息待补充]

使用数据集的考虑

数据集的社会影响

[信息待补充]

数据集的偏见讨论

[信息待补充]

其他已知限制

[信息待补充]

附加信息

数据集管理员

[信息待补充]

许可信息

[信息待补充]

引用信息

@InProceedings{huggingartists, author={Aleksey Korshuk} year=2021 }
搜集汇总
数据集介绍
huggingartists/noize-mc 数据集图片
构建方式
在自然语言处理与音乐文本生成的交叉领域中,歌词数据集扮演着至关重要的角色。huggingartists/noize-mc数据集专为俄罗斯说唱歌手Noize MC的歌词生成任务而设计,其构建过程严谨而系统。该数据集源自Genius歌词平台,通过自动化爬取技术获取Noize MC的原始歌词文本。随后,数据经过清洗与规范化处理,剔除冗余信息,确保文本的纯净度与一致性。最终,数据集以标准化的格式存储,包含一个名为“text”的字符串特征字段,共计349条样本,全部归入训练集,为后续模型训练提供了坚实的数据基础。
特点
该数据集的核心特点在于其专一性与实用性。作为一个专为特定艺术家定制的歌词数据集,它聚焦于Noize MC的独特歌词风格与语言表达,使得生成的文本能够高度还原艺术家的创作韵味。数据集规模适中,约1.39 MB,便于快速加载与实验。此外,其结构简洁明了,仅包含单一文本字段,降低了使用复杂度。数据集的灵活性还体现在支持用户自定义划分训练、验证与测试集,通过简单的代码即可实现比例分配,满足不同研究场景的需求。
使用方法
使用该数据集极为便捷,研究人员可通过Hugging Face的datasets库直接加载。仅需一行代码“from datasets import load_dataset; dataset = load_dataset('huggingartists/noize-mc')”即可获取完整数据。加载后,数据集以字典形式呈现,用户可轻松访问训练集中的文本内容。如需进行模型训练,建议按照0.9、0.07和0.03的比例将训练集划分为训练、验证和测试子集,这一过程可通过NumPy库的split函数高效完成。最终,利用DatasetDict结构重组数据,即可无缝接入Hugging Face的Transformers框架进行歌词生成模型的训练与评估。
背景与挑战
背景概述
在自然语言处理与创意文本生成领域,音乐歌词作为一种兼具韵律、情感与叙事结构的语言形式,为生成式模型提供了独特的训练素材。huggingartists/noize-mc数据集由Aleksey Korshuk于2021年创建,隶属于HuggingArtists项目,旨在通过解析Genius平台上的歌词文本,驱动面向特定艺术家的歌词生成模型。该数据集聚焦于俄罗斯说唱歌手Noize MC,收录了349条英文歌词样本,其核心研究问题在于探索如何利用小规模、高风格一致性的语料训练出能够捕捉艺术家独特语言风格与表达惯性的生成模型。作为HuggingArtists系列的一部分,该数据集为音乐与人工智能交叉领域的研究提供了可复现的基准,推动了歌词自动创作、风格迁移及个性化文本生成等方向的发展。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性上:歌词生成不仅需要符合语法规范,更要求模型能够理解并再现特定艺术家的修辞手法、押韵模式及情感张力,这对仅依赖有限文本样本的生成任务构成显著困难。此外,构建过程中存在多重技术瓶颈,包括从Genius平台爬取歌词时面临的数据版权与访问限制,以及原始文本可能包含非标准标点、拼写变体或表演性重复,需进行精细的清洗与规范化处理。数据规模仅有349条样本,远小于通用文本生成数据集,这加剧了过拟合风险,并限制了模型对多样化主题与情感表达的学习能力。同时,缺乏多模态信息(如音乐节奏、语音语调)使得生成的歌词在脱离旋律后可能丧失原有艺术感染力。
常用场景
经典使用场景
在自然语言处理与创意文本生成领域,huggingartists/noize-mc数据集以其独特的歌词语料库,成为训练音乐风格文本生成模型的经典资源。该数据集收录了俄罗斯说唱歌手Noize MC的英文歌词,经过精心解析与结构化处理,为研究者提供了纯净的文本序列。其经典使用场景在于利用HuggingFace的Transformer架构,微调预训练语言模型,使其能够捕捉Noize MC作品中蕴含的韵律模式、隐喻风格与叙事张力。研究者通过此数据集,得以探索个性化歌词自动生成的技术路径,推动AI在音乐创作辅助中的边界拓展。
实际应用
在实际应用层面,该数据集为音乐科技与娱乐产业注入了创新活力。基于此数据集训练的歌词生成模型,可被集成至音乐创作辅助软件中,为词作者提供灵感启发与韵律建议,加速歌词创作流程。在互动娱乐领域,它赋能虚拟歌手或游戏角色生成符合Noize MC风格的即兴说唱内容,增强用户体验的沉浸感。此外,该数据集还可用于构建音乐教育工具,帮助学习者通过分析生成文本,理解说唱艺术的修辞技巧与情感表达,实现文化传承与技术创新的有机融合。
衍生相关工作
围绕huggingartists/noize-mc数据集,衍生出了一系列具有影响力的研究工作。HuggingArtists项目本身即是一个里程碑式的工作,它系统性地收集了多位艺术家的歌词数据,并提供了标准化的模型训练流程。在此基础上,研究者探索了对比学习与提示工程在歌词风格控制中的应用,提出了融合韵律约束的生成框架。后续工作进一步拓展了跨语言歌词生成的可能性,将Noize MC的英文风格与多语言模型结合,验证了风格一致性的迁移能力。这些衍生工作共同丰富了AI音乐创作的学术版图,为个性化文本生成领域树立了新的方法论标杆。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

