
遇见数据集

meituan-longcat/MineExplorer

收藏
Hugging Face2026-06-12 更新2026-06-14 收录
官方服务:

资源简介:

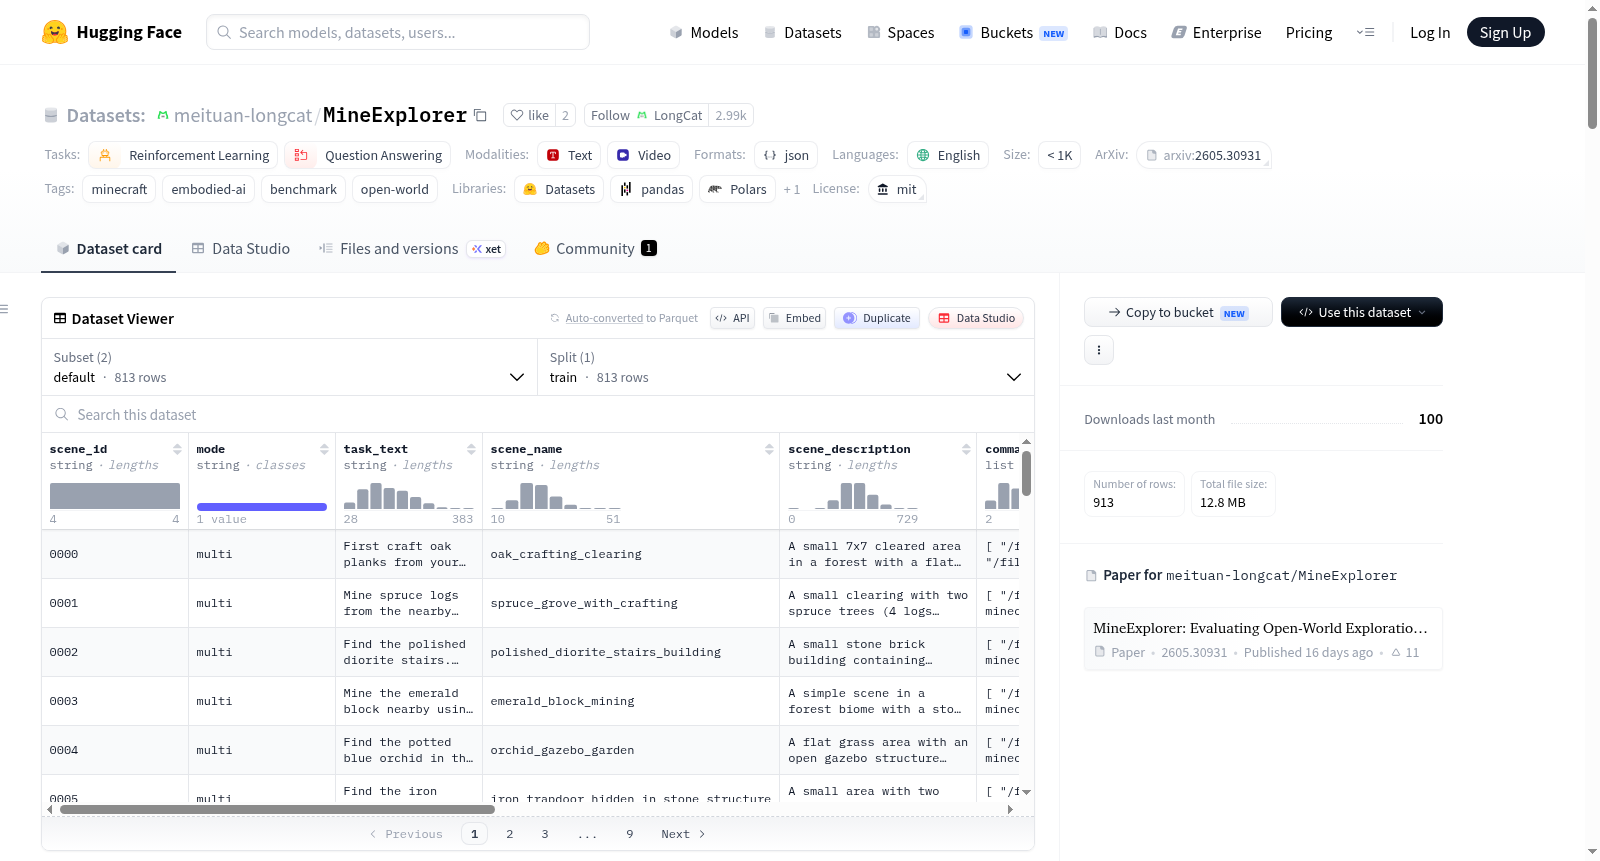
MineExplorer基准测试是一个用于评估多模态大语言模型(MLLM)代理在《我的世界》(Minecraft)开放世界探索能力的数据集。它通过过滤那些解决方案严重依赖《我的世界》特定知识的原子任务,以更好地反映一般开放世界推理能力,并围绕ReAct风格的能力框架组织,将原子任务组合成隐式的多跳任务。数据集使用多智能体合成工作流构建,联合设计任务图、沙盒场景和基于规则的里程碑评估器,以确保实例的可靠性。实验表明,开放世界探索仍然具有挑战性,即使强大模型能处理许多单跳任务,但在需要协调隐藏先决条件的较长轨迹上性能会显著下降。数据集包含813个多跳基准场景和一个100个最困难场景的子集,每个场景记录包括场景ID、任务文本、场景描述、命令、里程碑等字段。

The MineExplorer benchmark is a dataset designed to evaluate the open-world exploration capabilities of multimodal large language model (MLLM) agents in Minecraft. It filters atomic tasks whose solutions heavily rely on Minecraft-specific knowledge to better reflect general open-world reasoning capabilities, and is organized around a ReAct-style capability framework that combines atomic tasks into implicit multi-hop tasks. The dataset is constructed using a multi-agent synthetic workflow, where task graphs, sandbox scenarios, and rule-based milestone evaluators are jointly designed to ensure the reliability of instances. Experiments show that open-world exploration remains challenging: even though strong models can handle many single-hop tasks, their performance drops significantly on longer trajectories that require coordinating hidden prerequisites. The dataset consists of 813 multi-hop benchmark scenarios and a subset of the 100 most difficult scenarios. Each scenario record includes fields such as scenario ID, task text, scenario description, commands, and milestones.
提供机构:
meituan-longcat
搜集汇总
数据集介绍
meituan-longcat/MineExplorer 数据集图片
构建方式
MineExplorer数据集的构建源于对多模态大语言模型在动态开放世界中探索能力的评估需求。研究者首先从Minecraft环境中筛选出原子任务,剔除过度依赖游戏特定知识的任务,以更好地反映通用开放世界推理能力。随后,基于ReAct风格的能力框架,将原子任务有机组合为隐含多跳任务。为确保实例的可靠性,采用多智能体协同合成流程,联合设计任务依赖图、沙盒场景及基于规则的里程碑评估器。人类评估表明,该合成流程相较于单智能体基线生成了显著更可靠的实例。
使用方法
用户可通过HuggingFace Datasets库便捷加载MineExplorer数据集。使用`load_dataset('jometeorie/MineExplorer-Benchmark', split='train')`即可加载完整的813个基准场景,而通过指定`name='hard'`参数则可获取100个困难子集。数据以JSONL格式存储,每条记录包含丰富的结构化字段,便于研究者直接用于评估多模态智能体在Minecraft环境中的探索性能,或进一步结合强化学习与问答任务进行深入分析。
背景与挑战
背景概述
MineExplorer数据集诞生于2026年,由上海交通大学、美团等多个机构的研究人员Tianjie Ju、Yueqing Sun、Zheng Wu等联合开发,专注于评估多模态大语言模型(MLLM)在《我的世界》这一动态开放世界中的探索能力。现有基准测试大多将交互压缩为短视任务,或与特定游戏机制纠缠,难以反映智能体在真实开放世界中的泛化推理与长程规划。MineExplorer通过筛选依赖游戏特定知识的原子任务,并构建ReAct风格的隐式多跳任务,填补了这一评估空白,为具身AI与开放世界推理研究提供了关键工具。
当前挑战
该数据集面临的核心挑战在于,开放世界探索任务要求智能体具备长程规划与隐式前提协调能力,实验表明强模型在单跳任务上表现尚可,但一旦涉及隐藏先决条件的长轨迹时,任务成功率急剧下降,暴露出当前MLLM在持久探索与动态环境适应上的不足。构建过程中,MineExplorer采用多智能体合成工作流来联合设计任务图、沙盒场景与里程碑评估器,相比单智能体基线显著提升了实例可靠性,但仍需解决复杂任务图自动生成中的逻辑一致性与场景多样性难题。
常用场景
经典使用场景
MineExplorer基准数据集的核心用途在于系统性地评估多模态大语言模型(MLLM)智能体在开放世界中的持续探索与任务完成能力。该数据集基于Minecraft沙盒环境,精心筛选了高度依赖世界知识与空间推理的原型任务,并依据ReAct能力框架将原子任务组织成隐式多跳任务,要求智能体在动态、非确定性的开放世界中自主完成从感知、规划到行动执行的完整闭环。研究者可借助该基准精确衡量模型在单跳简单任务与多跳复杂任务上的表现差异,从而深入剖析其在长程依赖推理与未知环境适应方面的能力上限与短板。
解决学术问题
MineExplorer针对当前多模态大语言模型研究中的关键盲点——开放世界探索能力缺乏标准化评测——提出了系统性的解决方案。现有具身智能与游戏基准往往将交互压缩为短时程任务,或其成功依赖于特定游戏机制的领域知识,难以反映模型在开放世界中持续探索、解耦环境随机性与自主动机驱动的通用能力。借助多智能体合成工作流构建的可靠任务实例与里程碑式评估器,该数据集有效解耦了感知精度、推理深度与动作执行效率,使得研究者能够量化分析模型在面对隐藏前提条件与长程协调需求时的退化程度,为理解MLLM在复杂开放环境下的泛化与鲁棒性提供了宝贵的实证依据。
实际应用
在实践层面,MineExplorer为构建与优化面向开放世界的具身智能体提供了关键测试场与训练蓝图。游戏开发与自动化测试领域可借鉴其任务图设计范式,在虚拟世界中部署探索自动化代理以完成资源搜集、环境构建与NPC交互等复杂行为链。在机器人自主导航与应急救援等现实场景中,Minecraft所模拟的开放世界探索任务能够启发研发者设计更为鲁棒的感知-规划-执行管线,提升智能体在未知、动态环境中进行多步推理与目标拆解的工程能力。此外,该数据集所倡导的多智能体协作合成工作流,也为大规模高质量评测实例的生产提供了可复用的方法论框架。
数据集最近研究
最新研究方向
MineExplorer基准测试聚焦于评估多模态大语言模型(MLLM)在《我的世界》开放式世界中的持续探索能力,这一方向正成为具身智能领域的前沿热点。该研究通过构建基于ReAct风格能力框架的单跳与隐式多跳任务,并采用多智能体合成流程协同设计任务图、沙盒场景及基于规则的里程碑评估器,显著提升了任务实例的可靠性。实验揭示,当前顶尖模型在简单单跳任务中表现尚可,但在需协调隐藏前提的长轨迹多跳任务中性能急剧下降,且更大模型规模或思维模式并非总能带来性能提升。这一发现为评估MLLM在动态开放世界中的规划与推理能力设立了新标杆,也为推动具身智能体在复杂环境下的自主决策研究提供了关键启示。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

