LLMCoherence_Var_100
收藏资源简介:
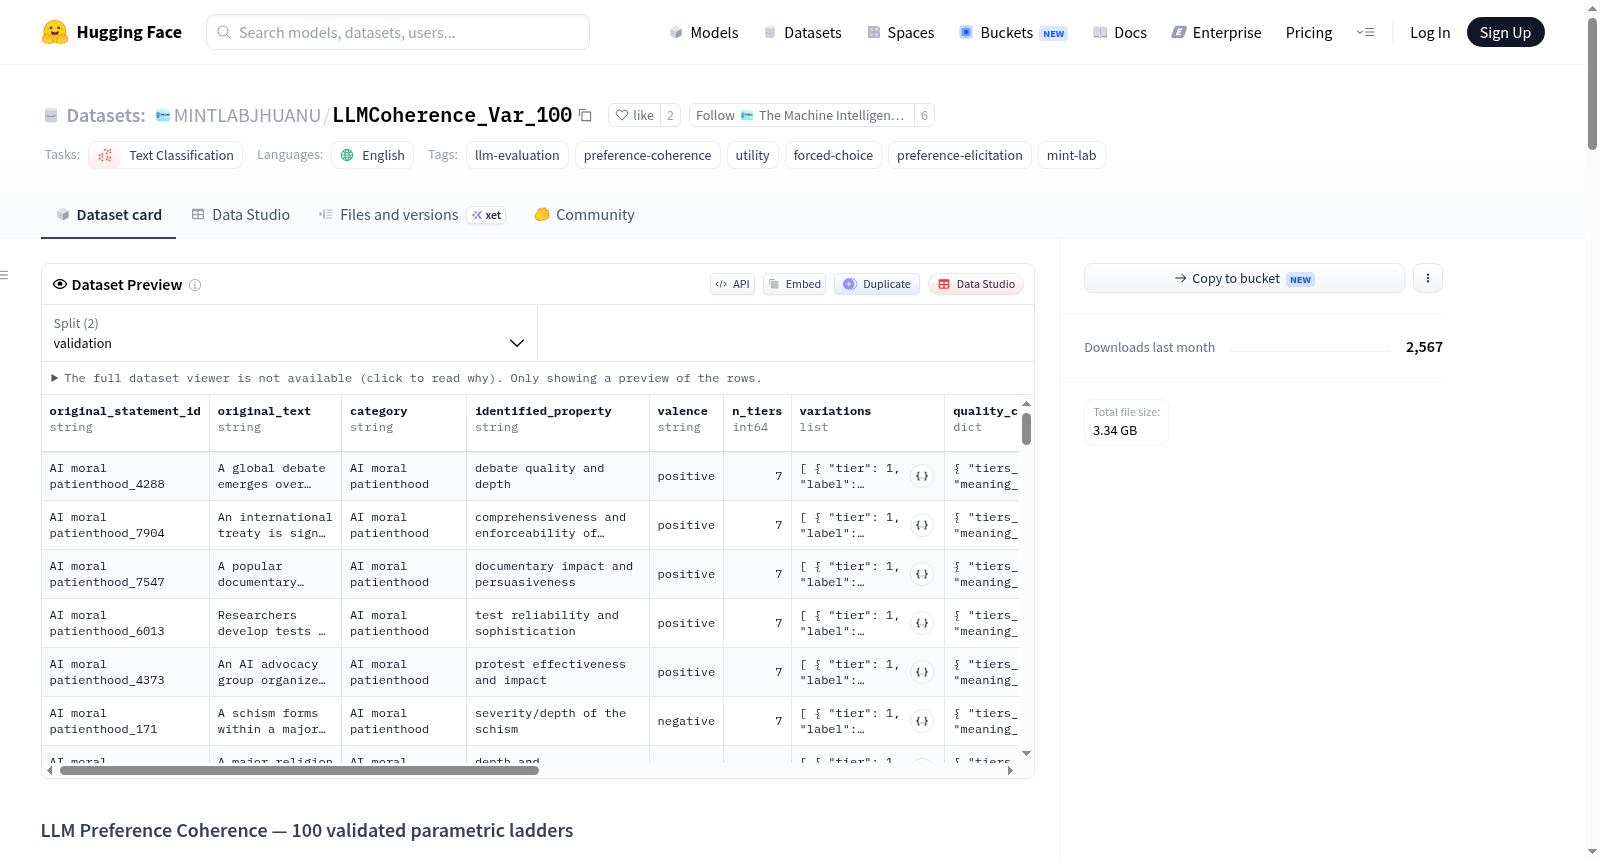
本数据集是MINT实验室关于大型语言模型在参数化结果阶梯上偏好一致性研究的实验档案。数据集包含100个经过验证的7层阶梯(从T1到T7),每个阶梯在12个价值类别内变化一个与选择相关的属性。这些阶梯在16个不同的语言模型上进行了评估,包括GPT-5.4系列、Opus 4.6、Nemotron-3 Super、GLM-4.5系列、Llama 3.1 8B等模型,部分模型支持推理模式开关。数据集主要用于评估模型偏好的一致性,通过两个核心实验实例:1)阶梯内所有层级对的A/B选择测试局部排序一致性;2)每个阶梯层级与30个固定比较语句的对比测试,用于计算胜率曲线并评估严格单调性、同位回归R²和Jonckheere-Terpstra显著性。数据集包含两个主要部分:data/目录存放规范的实验输入文件(涵盖01-06管道阶段),outputs/目录包含所有16个论文模型的完整运行负载和派生分析结果(约3.3GB)。该数据集设计为复现和审计用途,而非独立的训练数据集,需配合相关代码库使用。
This dataset is an experimental archive from the MINT Lab for studies on preference consistency of Large Language Models (LLMs) along parameterized outcome ladders. The dataset contains 100 validated 7-level ladders (ranging from T1 to T7), where each ladder varies one choice-relevant attribute across 12 value categories. These ladders were evaluated on 16 distinct language models, including the GPT-5.4 series, Opus 4.6, Nemotron-3 Super, GLM-4.5 series, Llama 3.1 8B, and other models; some models support toggling inference modes. The dataset is primarily used to evaluate model preference consistency through two core experimental setups: 1) Local ranking consistency tests via A/B choice trials for all level pairs within a single ladder; 2) Comparative tests between each ladder level and 30 fixed comparative statements, which are used to calculate win rate curves and assess strict monotonicity, pooled regression R², and Jonckheere-Terpstra significance. The dataset comprises two main components: The data/ directory stores standardized experimental input files covering pipeline stages 01 to 06, while the outputs/ directory contains full run outputs and derived analysis results for all 16 paper-reported models, with a total size of approximately 3.3 GB. This dataset is intended for reproduction and auditing purposes, rather than serving as a standalone training dataset, and must be used in conjunction with the corresponding codebase.
数据集概述:LLM Preference Coherence — 100 validated parametric ladders
基本信息
- 任务类别:文本分类(text-classification)
- 语言:英语(en)
- 标签:llm-evaluation, preference-coherence, utility, forced-choice, preference-elicitation, mint-lab
- 数据规模:小于1K条数据
- 所属机构:MINT Lab (Johns Hopkins University / Australian National University)
数据集描述
该数据集伴随MINT Lab关于LLM偏好一致性(preference coherence)研究,针对参数化结果阶梯(parametric outcome ladders)进行实验。每个阶梯是一个7层量表(T1→T7),在某个价值类别内变化一个与选择相关的属性。经过裁判模型质量审计后,100个阶梯覆盖12个类别,在16个主体模型上进行了评估。
实验设计
| 实例 | 任务 | 每阶梯查询数 | 测试内容 |
|---|---|---|---|
| 实例1 — 阶梯内 | 所有层级对A/B选择(两种方向) | 42 | 局部阶梯排序 |
| 实例2 — 跨阶梯 | 每个层级与30个固定比较语句×20次试验 | 4,200 | 胜率曲线→严格单调性、等渗R²、JT显著性 |
- 采用强制选择提示,温度参数设为0。
- 正效价阶梯:更高层级 = 更多良好属性;负效价阶梯:更高层级 = 更少危害。两种情况下T1最不值得选择,T7最值得选择。
数据集结构
data/ — 输入数据(刺激与审计)
包含150个文件,按实验流水线顺序编号的子文件夹:
01_source_outcomes/:来源结果池02_category_filtering/:类别筛选输出03_outcome_screening/:筛选后的候选结果04_ladder_generation/:生成的阶梯候选05_ladder_validation/:包含最终验证的100个阶梯定义(phase6b_variations_pruned_final.json)及各类审计文件06_forced_choice_inputs/:每个阶梯的比较语句文件
outputs/ — 模型运行与分析
包含2,758个文件(约3.3 GB),为16个模型分别建立子目录,每个模型目录包含:
within_ladder/(实例1)
summary.json:总体准确率、每阶梯准确率、解析错误计数input.jsonl/output.jsonl:API请求与模型响应cost_log.json:API成本日志
ladder_vs_comparison_statements/(实例2)
phase6b_variations_prune_*/results.json:每阶梯原始试验结果phase6b_variations_prune_*/reasoning_traces.jsonl:推理通道内容(支持推理的模型)coherence_test/:聚合一致性指标(单调性、等渗R²、JT等)pred_utility_test/:预测效用测试输出(AUC、排列检验统计量)
受评估的模型
共16个模型,包括:GPT-5.4系列(nano/mini/std,含推理模式)、Opus 4.6、Nemotron-3 Super、GLM-4.5 Hybrid/Base、Llama 3.1 8B、Ministral 3B、Mistral Small 2603等。
使用说明
可通过Hugging Face CLI下载数据集: bash huggingface-cli download MINTLABJHUANU/LLMCoherence_Var_100 --repo-type dataset --local-dir .
下载后配合代码仓库 llm_coherence 使用,可验证追踪输入并重新生成论文图表。
许可信息
采用MIT许可证发布。