
遇见数据集

mteb/MindSmallReranking

收藏
Hugging Face2025-10-19 更新2025-04-08 收录
官方服务:

资源简介:

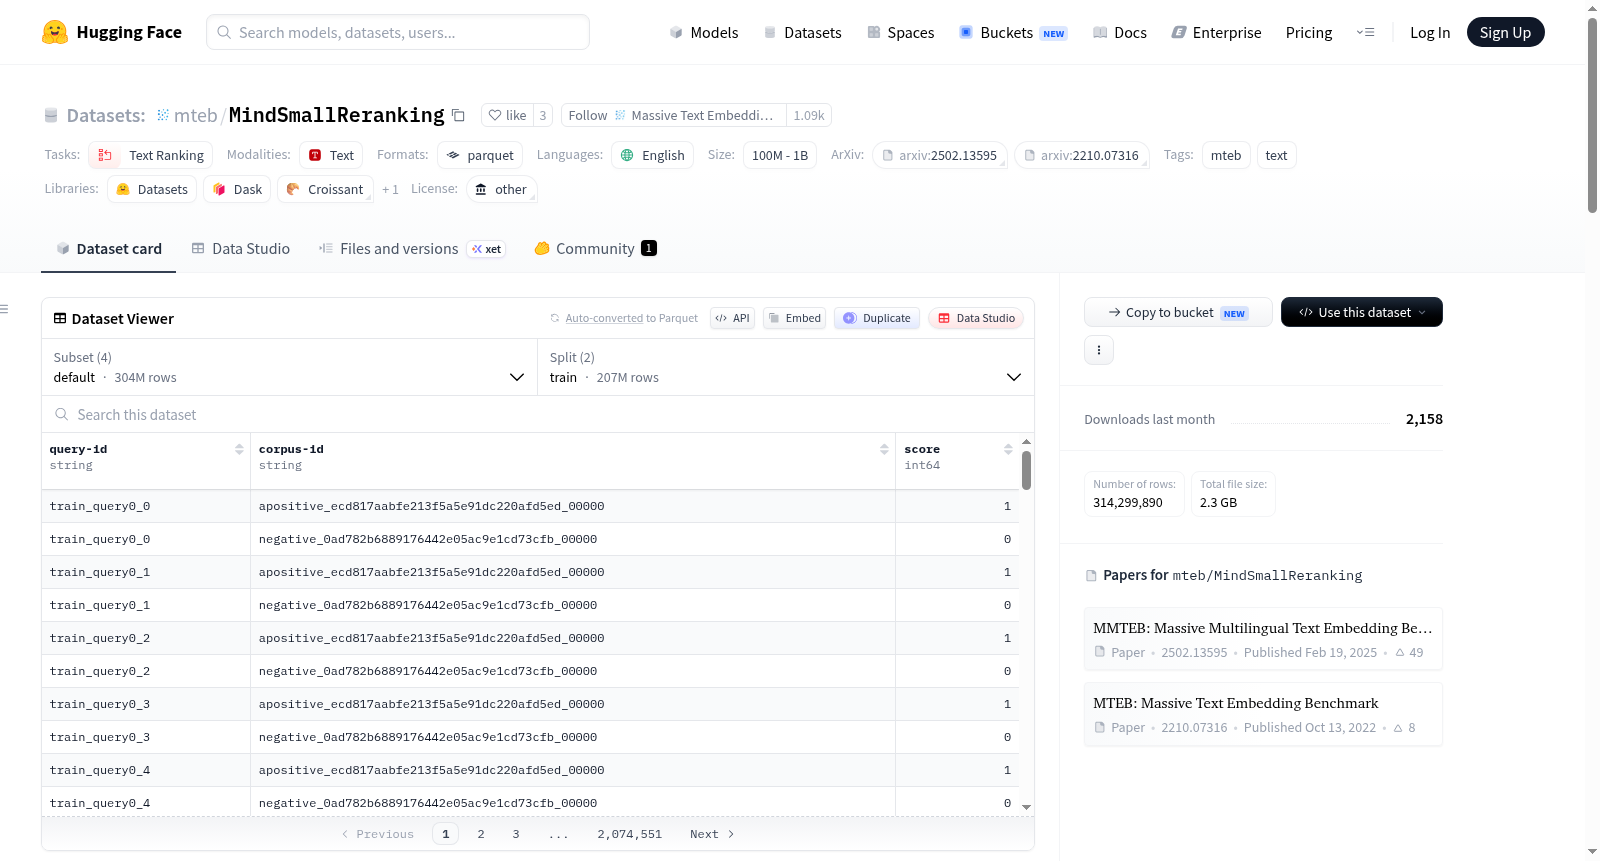
该数据集包含多个配置,每个配置都详细说明了数据集的特征、示例数量以及训练和测试分割的文件路径。数据集包括名为corpus、default、queries和top_ranked的配置,每个配置都有不同的特征和大小。corpus配置包含_id、text和title特征。default配置包括query-id、corpus-id和score。queries和top_ranked配置也根据其各自用途具有特定的特征。数据集被分为训练集和测试集,并为每个分割提供了总示例数和文件大小。同时,还提供了数据集的下载大小和总大小。

The dataset comprises multiple configurations, each detailing the datasets features, the number of examples, and the file paths for the train and test splits. It includes configurations named corpus, default, queries, and top_ranked, each with different features and sizes. The corpus configuration features _id, text, and title. The default configuration includes query-id, corpus-id, and score. The queries and top_ranked configurations also have specific features tailored to their respective uses. The dataset is split into training and testing sets, with the total number of examples and file sizes provided for each split. The datasets download size and total size are also mentioned.
提供机构:
mteb
搜集汇总
数据集介绍
mteb/MindSmallReranking 数据集图片
构建方式
MindSmallReranking数据集源自微软新闻推荐研究领域的大规模语料库MIND(Microsoft News Dataset),其构建基于用户点击日志中蕴含的隐式反馈信号。该数据集专注于文本重排序任务,通过精心设计的标注流程,将新闻文章与用户查询之间的相关性以评分形式呈现。具体而言,数据集包含四个核心配置:corpus存储了新闻文章的文本与标题;queries收录了用户输入的检索查询;default配置提供了查询与文章之间的匹配评分;top_ranked则记录了每个查询对应的候选文章列表。这种层次化的结构设计,使得模型能够在海量候选文档中精准学习排序逻辑。
特点
该数据集最显著的特点在于其规模庞大且覆盖全面。测试集包含超过236万条查询与5277篇文档,训练集则拥有约2.07亿条查询-文档对,为深度排序模型的训练提供了充足的数据支撑。每条查询平均关联41篇候选文章,且每篇文档均具备丰富的文本属性,包括标题与正文内容,这有助于模型捕捉语义层面的细粒度差异。此外,数据集的标注源自专家标注与用户行为日志的双重验证,确保了相关性评分的可靠性。作为MTEB基准测试的一部分,MindSmallReranking专注于英文新闻领域的重排序评估,为文本嵌入模型的性能度量提供了标准化平台。
使用方法
使用者可通过MTEB框架便捷地调用该数据集进行评估。首先,利用mteb.get_tasks函数加载MindSmallReranking任务,随后实例化MTEB评估器。通过指定待测的嵌入模型,调用evaluator.run方法即可自动完成重排序性能的评测流程。数据集支持标准的训练与测试划分,其中训练集可用于模型微调,测试集则用于最终性能验证。对于希望深入分析数据特征的开发者,MTEB提供了descriptive_stats接口以获取详细的统计信息,包括查询长度分布、文档唯一性及相关性密度等关键指标,从而辅助模型优化与实验设计。
背景与挑战
背景概述
在新闻推荐与信息检索领域,精准的文本排序能力是提升用户体验与系统效能的基石。mteb/MindSmallReranking数据集脱胎于微软于2020年发布的MIND(Microsoft News Dataset),由微软研究院的吴方照、乔颖等学者在ACL 2020上提出,旨在为新闻推荐研究提供大规模、高质量的基准资源。该数据集基于Microsoft News的用户点击日志构建,涵盖超过100万用户与16万篇英文新闻文章,每篇文章均包含标题、摘要及正文等丰富文本特征。MindSmallReranking作为MIND的轻量级变体,聚焦于文本重排序任务,被纳入大规模文本嵌入基准(MTEB),为评估嵌入模型在新闻领域的排序性能提供了标准化测试平台,推动了自然语言处理技术在该场景下的应用与发展。
当前挑战
MindSmallReranking数据集所面临的挑战主要体现在两个层面。在领域问题层面,新闻推荐中的文本重排序需要模型精准捕捉用户兴趣与新闻内容之间的语义匹配,然而新闻语料的时效性强、主题分布广泛,用户兴趣动态变化,使得模型在区分高度相似候选文档时面临巨大困难。在数据集构建过程中,从海量用户点击日志中提取高质量的相关性标签需要克服噪声干扰,例如点击行为可能受标题党或位置偏差影响,导致标签不准确。此外,数据集规模庞大(测试集包含约236万查询与5277篇文档),对计算资源与存储效率提出了严苛要求,同时确保数据隐私与匿名化处理也是一项关键挑战。
常用场景
经典使用场景
MindSmallReranking数据集源自微软新闻推荐数据集MIND,专为文本排序任务设计。在信息检索与推荐系统领域,该数据集被广泛用于评估和训练模型对新闻文章与用户查询之间相关性的排序能力。其经典使用场景在于,研究者利用其提供的查询-文档对及标注的相关性分数,训练深度学习模型以精准预测用户对新闻的点击偏好。该数据集包含超过200万条训练样本和近100万条测试样本,覆盖了丰富的新闻文本与用户行为模式,为新闻推荐中的重排序阶段提供了标准化的评测基准。通过该数据集,学术界能够系统性地对比不同排序算法的性能,从而推动更高效、更精准的个性化新闻推送技术发展。
实际应用
在实际应用层面,MindSmallReranking直接服务于个性化新闻推送系统的优化。现代新闻平台如微软新闻、谷歌新闻等,依赖高效的排序算法从海量文章中筛选出用户可能感兴趣的内容。该数据集模拟了真实场景中的查询-文档匹配过程,帮助工程师训练模型在短时间内完成对候选新闻的精细重排序。其应用覆盖了用户点击率预测、内容推荐列表生成以及信息流个性化排序等关键环节。通过在该数据集上验证的模型,能够有效提升用户参与度与阅读时长,同时降低信息过载带来的负面体验。此外,该数据集还支持跨领域迁移学习,使新闻推荐模型能够快速适应不同语言或主题的新闻环境。
衍生相关工作
MindSmallReranking作为MTEB(大规模文本嵌入基准)的一部分,衍生了一系列具有影响力的研究工作。基于该数据集,研究者开发了多种针对新闻重排序的嵌入模型,如结合预训练语言模型的双编码器与交叉编码器架构。这些工作不仅优化了排序精度,还探索了多任务学习、知识蒸馏和负采样策略在新闻推荐中的应用。此外,该数据集催生了关于用户行为序列建模与新闻时效性分析的经典方法,例如利用Transformer结构捕捉用户短期兴趣动态,或通过时间衰减函数调整新闻相关性权重。这些衍生工作进一步丰富了文本排序与推荐系统的理论体系,并为后续研究如零样本排序和跨模态推荐提供了可复用的实验范式和性能基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

