
遇见数据集

ChatterjeeLab/SNOOPPI

收藏
Hugging Face2026-07-01 更新2026-01-03 收录
官方服务:

资源简介:

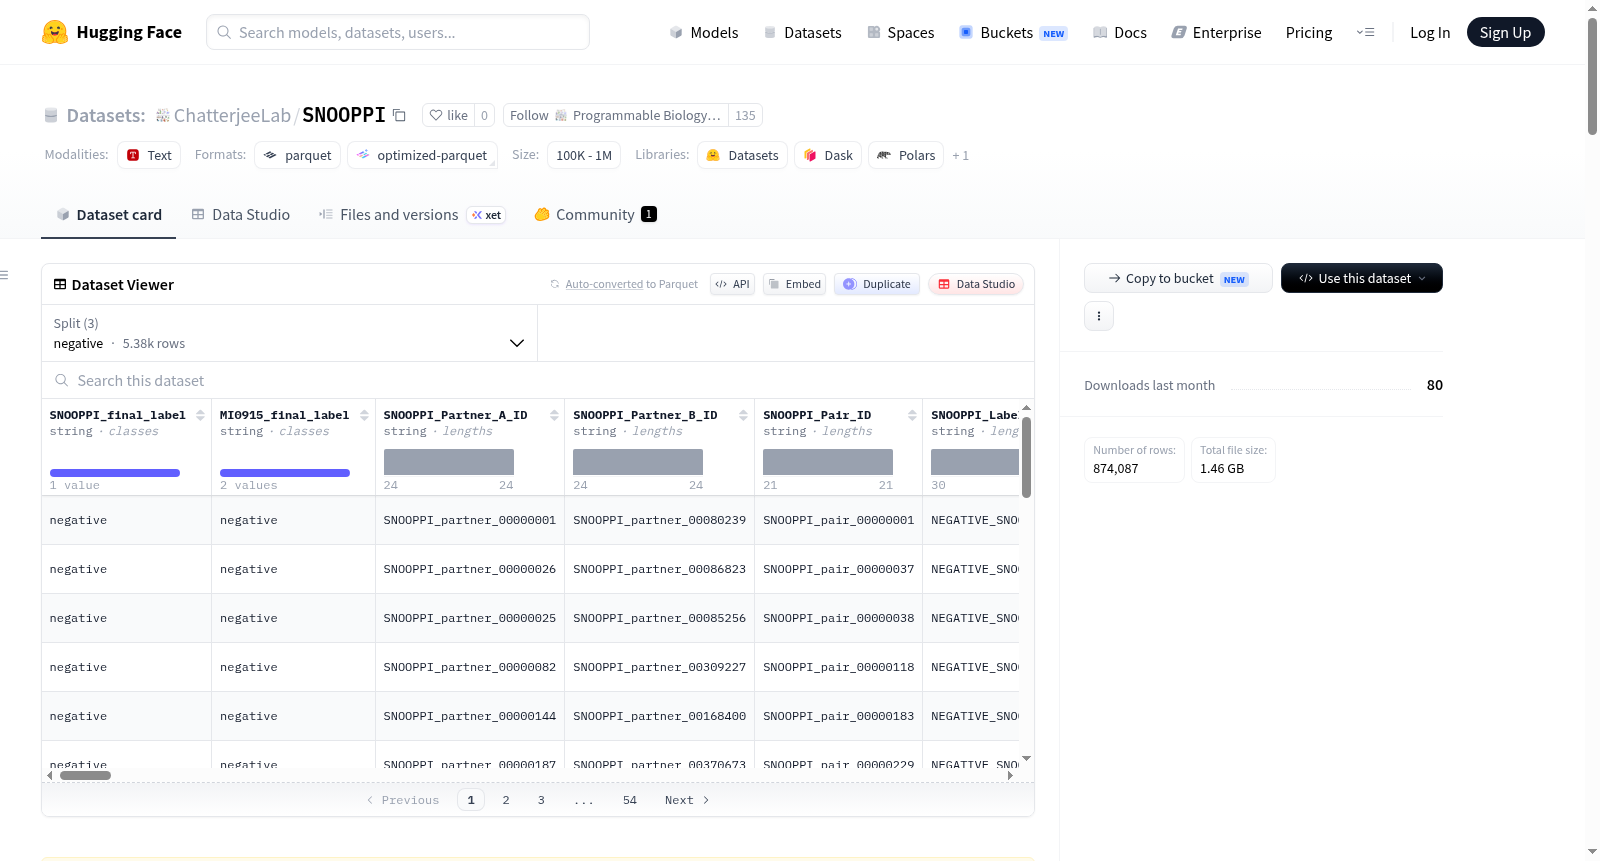
SNOOPPI是一个经过整理的蛋白质-蛋白质相互作用(PPI)数据集,包含阳性、阴性和未知的相互作用注释。该数据集是序列索引的,意味着每个唯一的SNOOPPI PPI或非PPI对应一个唯一的蛋白质序列组合。数据集保留了蛋白质序列、标识符、物种信息、PSI-MI相互作用术语、实验证据、出版物和特征关系(如果可用)。数据集分为三个部分:阳性相互作用(在SNOOPPI注释标准下保留为阳性相互作用的蛋白质对)、阴性相互作用(在SNOOPPI注释标准下保留为阴性相互作用的蛋白质对)和未知相互作用(存在于IntAct源交互记录中,但未在SNOOPPI标准下分配明确阳性或阴性标签的蛋白质对)。未知部分不应自动解释为阴性或实验测试的非相互作用集合,这些条目代表可用证据不足、冲突或在注释框架下未解决的相互作用。

SNOOPPI is a curated protein–protein interaction (PPI) dataset containing positive, negative, and unknown interaction annotations. The dataset is sequence-indexed, meaning one unique SNOOPPI PPI or non-PPI indicates a unique combination of protein sequences. It preserves protein sequences, identifiers, species information, PSI-MI interaction terms, experimental evidence, publications, and feature relationships where available. The dataset is distributed in three splits: positive (protein pairs retained as positive interactions under the SNOOPPI annotation criteria), negative (protein pairs retained as negative interactions under the SNOOPPI annotation criteria), and unknown (protein pairs present in IntActs source interaction records but not assigned a definitive positive or negative label under the SNOOPPI criteria). The unknown split should not automatically be interpreted as a negative or as a set of experimentally tested non-interactions; these entries represent interactions for which the available evidence was insufficient, conflicting, or otherwise unresolved under the annotation framework.
提供机构:
ChatterjeeLab
搜集汇总
数据集介绍
ChatterjeeLab/SNOOPPI 数据集图片
构建方式
SNOOPPI数据集是经过精心筛选的蛋白质-蛋白质相互作用(PPI)数据库,整合自IntAct等权威蛋白质相互作用数据库的原始记录。该数据集采用序列索引策略,确保每一对阳性、阴性或未知的蛋白质相互作用均以独特的蛋白质序列组合为唯一标识。通过系统性地保留蛋白质序列、标识符、物种信息、PSI-MI标准相互作用术语、实验证据来源、相关文献及特征关系等元数据,构建了一个高度结构化的层次化数据体系。数据集划分为三个明确的子集:阳性相互作用(positive)、阴性相互作用(negative)与未定标识的相互作用(unknown),其中unknown子集严格保留那些证据不充分、存在矛盾或无法在注释框架中得到确定性判定的原始交互记录。
使用方法
用户可通过Hugging Face的datasets库便捷地加载SNOOPPI数据集。推荐使用pip install -U datasets命令安装依赖后,调用load_dataset(\"ChatterjeeLab/SNOOPPI\")即可获得包含positive、negative与unknown三个子集的DatasetDict对象。亦可通过设置split参数直接加载特定子集,例如split=\"positive\"。为便于数据操作,用户可利用.to_pandas()方法将子集转换为pandas DataFrame,从而进行基于列条件的子查询,例如通过过滤PSI-MI术语MI:0407获取直接相互作用数据,或按物种标识、UniProt登录号检索特定蛋白质的交互网络。在资源受限环境中,建议先进行过滤再转换为pandas格式以优化内存使用。
背景与挑战
背景概述
蛋白质-蛋白质相互作用(PPI)是分子生物学领域的核心研究主题,其精确识别对于理解细胞信号传导、疾病机制及药物设计至关重要。SNOOPPI(Sequence-Normalized Database of On- and Off-Target Protein-Protein Interactions)是由ChatterjeeLab研究团队于近年创建的高质量PPI数据集,旨在系统整合和规范化来自IntAct等公共数据库的相互作用信息。该数据集聚焦于解决PPI研究中长期存在的标签噪声与标准缺失问题,通过序列索引和严格注释标准,构建了包含正、负及未知三类交互标签的基准资源。SNOOPPI的发布为PPI预测方法的评估提供了可靠的黄金标准,推动了机器学习在生物网络推断中的应用,并在序列特征分析、跨物种比较等领域展现了广泛的潜在影响力。
当前挑战
当前PPI研究面临多重挑战。首先,领域层面亟需解决正负样本不平衡与标签质量参差不齐的问题,现有数据库常混合直接物理相互作用与间接功能关联,难以区分,而SNOOPPI通过PSI-MI术语和实验证据实现精细分类,但未知标签的界定仍依赖不充分的证据,可能引入偏误。其次,构建过程中面临序列索引与多源标识符融合的挑战,如UniProt登录号、物种分类及出版信息的整合需避免歧义,部分条目存在缺失或多重标注,字符串匹配中的字面子串冲突要求用户进行解析预处理。此外,跨物种交互中同源性的影响尚未完全消除,这对负样本的可靠性构成潜在威胁。SNOOPPI通过公开独立划分的未知集,鼓励社区共同完善注释体系,但如何在内存受限环境下高效处理海量序列数据仍是实际应用中的难点。
常用场景
经典使用场景
在蛋白质相互作用预测领域,SNOOPPI被广泛用作基准数据集来评估和比较各类预测模型的性能。其独特之处在于提供了经过严格序列归一化处理的阳性、阴性和未知交互注释,确保了每对蛋白质序列组合的唯一性。研究者通常利用其阳性与阴性子集构建分类任务,训练从序列特征、结构特征或进化信息中学习交互模式的机器学习模型,尤其适用于深度学习方法的公平性比较测试。由于数据集包含了PSI-MI术语、实验证据和物种来源等丰富元数据,使得模型可以在特定交互类型或物种背景下进行精细化评估,成为该领域不可或缺的标准化测试平台。
解决学术问题
该数据集有效解决了蛋白质相互作用预测研究中两个长期存在的关键挑战:高质量阴性样本的稀缺与数据冗余带来的评价偏差。通过严谨的注释准则,SNOOPPI甄别出具有明确非交互证据的蛋白质对,弥补了传统数据集缺乏可靠阴性标注的缺陷,使得预测模型的训练与评估更加科学严谨。其序列归一化机制消除了同一蛋白质序列对不同标识符造成的重复计数,确保了统计指标的客观性。保留的'未知'类别则警示研究者不应将未经完整验证的交互视为阴性样本,从而推动了PPI预测方法学向更高标准的实践迈进。
实际应用
在实际科研与工业应用中,SNOOPPI为药物靶点发现和蛋白质功能预测提供了可靠的数据基础。基于该数据集训练的分类器能够从蛋白质序列出发预测未知的相互作用关系,帮助研究人员缩小候选药物靶点筛选范围,加速药物研发初期阶段的进程。在系统生物学领域,它支持构建大规模的蛋白质互作网络,进而用于解析信号传导通路和疾病相关模块。用户还可以方便地查询特定UniProt登录号或物种相关的交互信息,使得跨物种的蛋白质功能保守性分析、以及病原体-宿主交互组学研究更加高效便捷。
数据集最近研究
最新研究方向
SNOOPPI作为首个基于序列归一化的蛋白质-蛋白质互作(PPI)基准数据集,通过严格标注正例、负例与未知交互,为预测模型提供了高质量的训练与评估基础。当前前沿研究聚焦于利用其序列索引特性,结合深度学习架构(如图神经网络与Transformer)挖掘序列模式与互作特征的关联,从而提升跨物种PPI预测的泛化能力。该数据集的引入,有效解决了传统数据集因实验证据冲突或缺失导致的标签噪声问题,尤其在药物靶点发现与致病突变解析等热点领域,其未知类别的合理保留策略为弱监督学习及不确定性建模开辟了新路径,对理解细胞信号网络的动态调控具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

