
遇见数据集

LeeMirror013/booru-quality-80-union-db

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

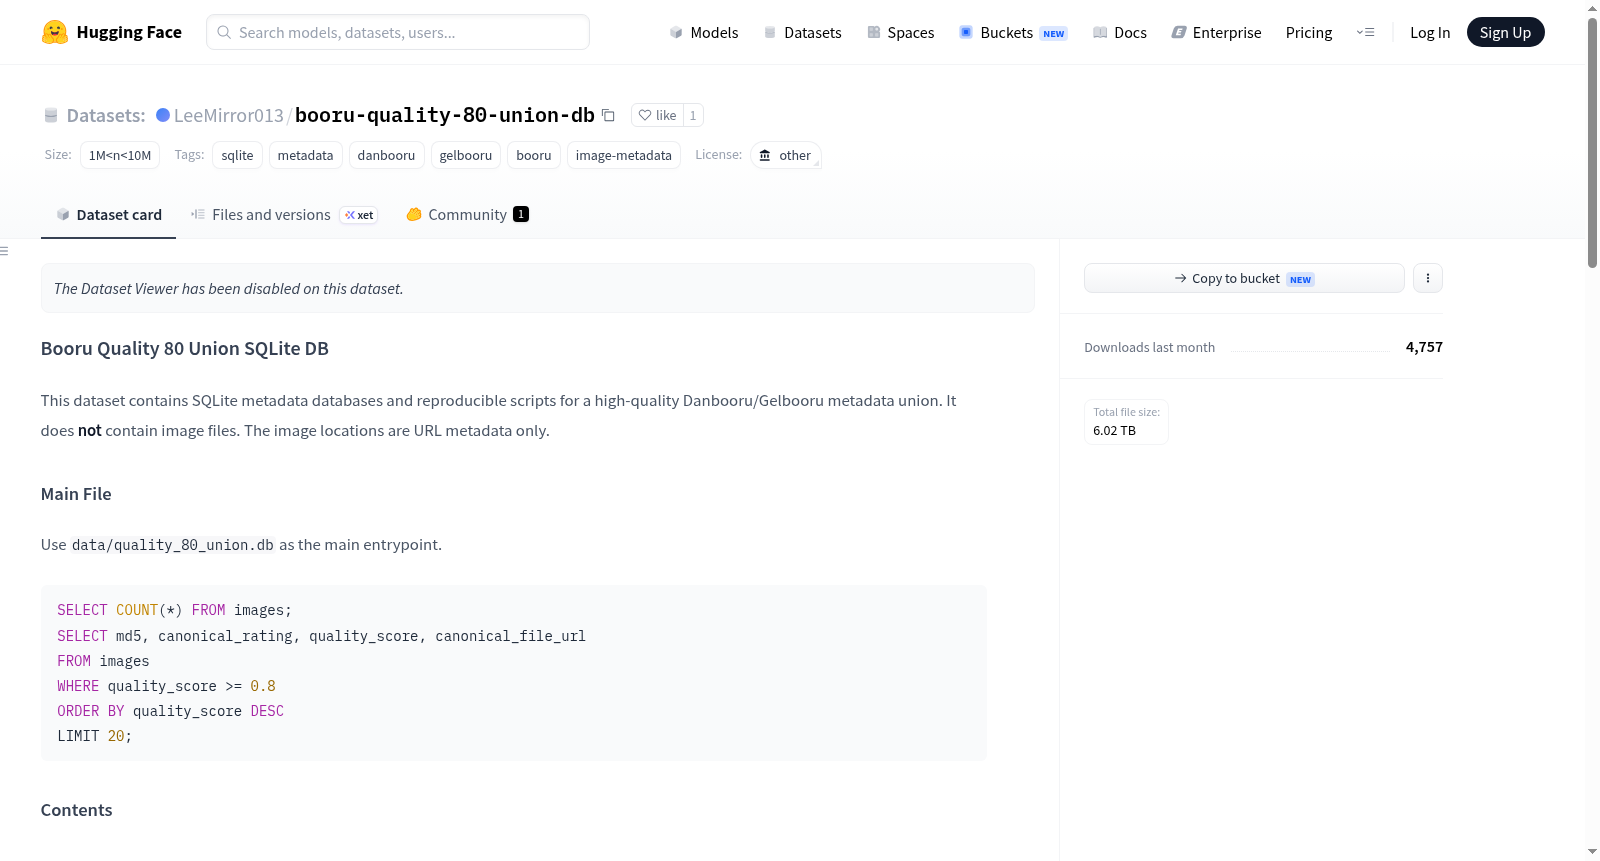
该数据集是一个高质量的Danbooru和Gelbooru图像元数据联合SQLite数据库,专注于质量筛选(质量评分≥0.8)。它包含SQLite元数据数据库和可重复脚本,用于整合Danbooru和Gelbooru的元数据,但不包含实际图像文件,图像位置仅以URL元数据形式提供。数据集的主要文件是data/quality_80_union.db,其中包含去重后的图像元数据,共有2,988,704行,35列,其中2,973,255行质量评分≥0.8。质量评分基于评级分布计算,范围从0到1。数据集还包括源特定URL字段,如canonical_file_url、gelbooru_file_url和danbooru_file_url。用户需注意,元数据可能包含显式或可疑内容,使用时应根据源网站条款和本地规则进行过滤。

This dataset is a high-quality unified SQLite database of image metadata from Danbooru and Gelbooru, with a focus on quality filtering (quality score ≥ 0.8). It includes the SQLite metadata database and reproducible scripts for integrating metadata from Danbooru and Gelbooru, but does not contain the actual image files—image locations are only provided in the form of URL metadata. The primary file of the dataset is data/quality_80_union.db, which contains deduplicated image metadata with a total of 2,988,704 rows and 35 columns, among which 2,973,255 rows have a quality score ≥ 0.8. The quality score is calculated based on rating distribution, ranging from 0 to 1. The dataset also includes source-specific URL fields such as canonical_file_url, gelbooru_file_url, and danbooru_file_url. Users should note that the metadata may contain explicit or questionable content, and filtering should be conducted in accordance with the terms of service of the source websites and local regulations when using the dataset.

提供机构:
LeeMirror013
搜集汇总
数据集介绍
LeeMirror013/booru-quality-80-union-db 数据集图片
构建方式
该数据集通过整合Danbooru与Gelbooru两大图像元数据来源构建而成,采用基于MD5哈希的去重策略,选取各自源数据中质量评分位于第80百分位以上的高质量条目进行联合。构建流程由可复现的脚本驱动,包括Danbooru转换器、Gelbooru转换器及联合数据库构建工具,最终生成一个包含约299万行记录的SQLite数据库,其中超过297万条记录的质量评分不低于0.8。
特点
数据集的核心特点在于其严格的质控机制:通过计算各评级分组内的累积分布百分位数,取两个来源百分位数的最大值作为统一质量评分,确保条目在各自源内均属优质。此外,数据库包含35个字段,涵盖统一文件URL及源特定URL,为后续应用提供丰富的元数据信息。数据集不包含图像文件,仅提供元数据,支持用户按评级和评分进行灵活筛选。
使用方法
使用该数据集时,可直接加载主文件data/quality_80_union.db,通过SQL查询进行数据探索与分析。例如,利用SELECT语句筛选质量评分高于0.8的图像条目,并按评分降序排列以获取高质量样本。用户需注意数据可能包含敏感内容,应遵守源站条款及当地法规。未来计划支持本地图像Parquet分片,以扩展数据处理能力。
背景与挑战
背景概述
Booru Quality 80 Union SQLite DB数据集由研究团队于2025年构建,旨在整合Danbooru与Gelbooru两大图像元数据平台的优质资源。该数据集聚焦于图像质量评分与元数据统一的核心研究问题,通过构建去重后的SQLite数据库,为高分辨率图像筛选、多源数据融合及下游视觉任务提供了标准化基础。其基于百分位质量评分(quality_score≥0.8)的筛选策略,显著提升了元数据的一致性与可用性,对该领域内多平台数据整合与质量评估研究产生了重要推动力。
当前挑战
该数据集面临的挑战集中于领域问题与构建过程两方面。在领域层面,元数据异质性(如Danbooru与Gelbooru评分标准差异)导致质量阈值难以统一,需通过百分位分布对齐解决;同时,数据集仅包含URL与元数据,不涉及图像文件,限制了直接用于模型训练的实用性。构建过程中,MD5去重与跨平台联合查询需高效处理数百万级记录,且需维护各源数据库的兼容性;此外,内容可能包含敏感评级(如explicit/questionable),用户过滤与合规使用的责任转移对数据分发构成伦理与法律挑战。
常用场景
经典使用场景
Booru-Quality-80-Union-DB 数据集在计算机视觉与多模态学习领域,常被用作高质量图像元数据的筛选与聚合基准。研究者利用其提供的质量分数(quality_score)阈值筛选机制,结合 Danbooru 与 Gelbooru 两大图像社区的元数据,构建去重且质量统一的图像描述库。该数据集以 SQLite 格式存储,便于高效查询与批量处理,尤其适用于需要大规模、高可靠性图像元数据的预训练任务。经典使用方式包括基于质量分数的图像子集抽取、跨平台元数据融合验证,以及作为图像生成模型的训练数据筛选前置工具。
衍生相关工作
该数据集衍生了一系列关于元数据质量评估与数据集构建的经典工作。例如,研究者基于其质量分数定义方法,提出了改进的 rating_bucket_cume_dist 变体,用于在标签分布不均的场景下进行更鲁棒的质量排序。同时,该数据集的构建流程被迁移至其他图像社区元数据的清洗与融合任务,催生了如 Booru-Parquets 系列数据集的版本迭代。此外,一些工作利用该数据集的 md5 去重特性,验证了大规模元数据去重对模型训练稳定性的提升效果,进而提出了基于哈希的跨库去重标准化协议,为多源数据集融合提供了基础工具。
数据集最近研究
最新研究方向
booru-quality-80-union-db数据集代表了图像元数据聚合与质量筛选领域的前沿创新,通过融合Danbooru和Gelbooru两大主流Booru平台的元数据,构建了基于分位数质量评分的去重联合数据库。当前研究热点聚焦于利用该数据集的高质量元数据(含35列字段、近300万条记录)推动多模态生成模型训练集的优化,特别是在图像美学评分、提示词关联分析以及版权合规数据溯源方面。该数据集的发布响应了AIGC领域对大规模、高信噪比训练数据的需求,其质量分位阈值筛选机制(0.8分位)为构建针对性数据子集提供了可复现的范式,间接推动了视觉生成模型在图像质量与风格一致性上的改进。此外,SQLite数据库的轻量化架构支持高效查询,促进了跨平台元数据标准化研究,对建设负责任的AI数据集生态具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

