
遇见数据集

ghananlpcommunity/twi-english-agric

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

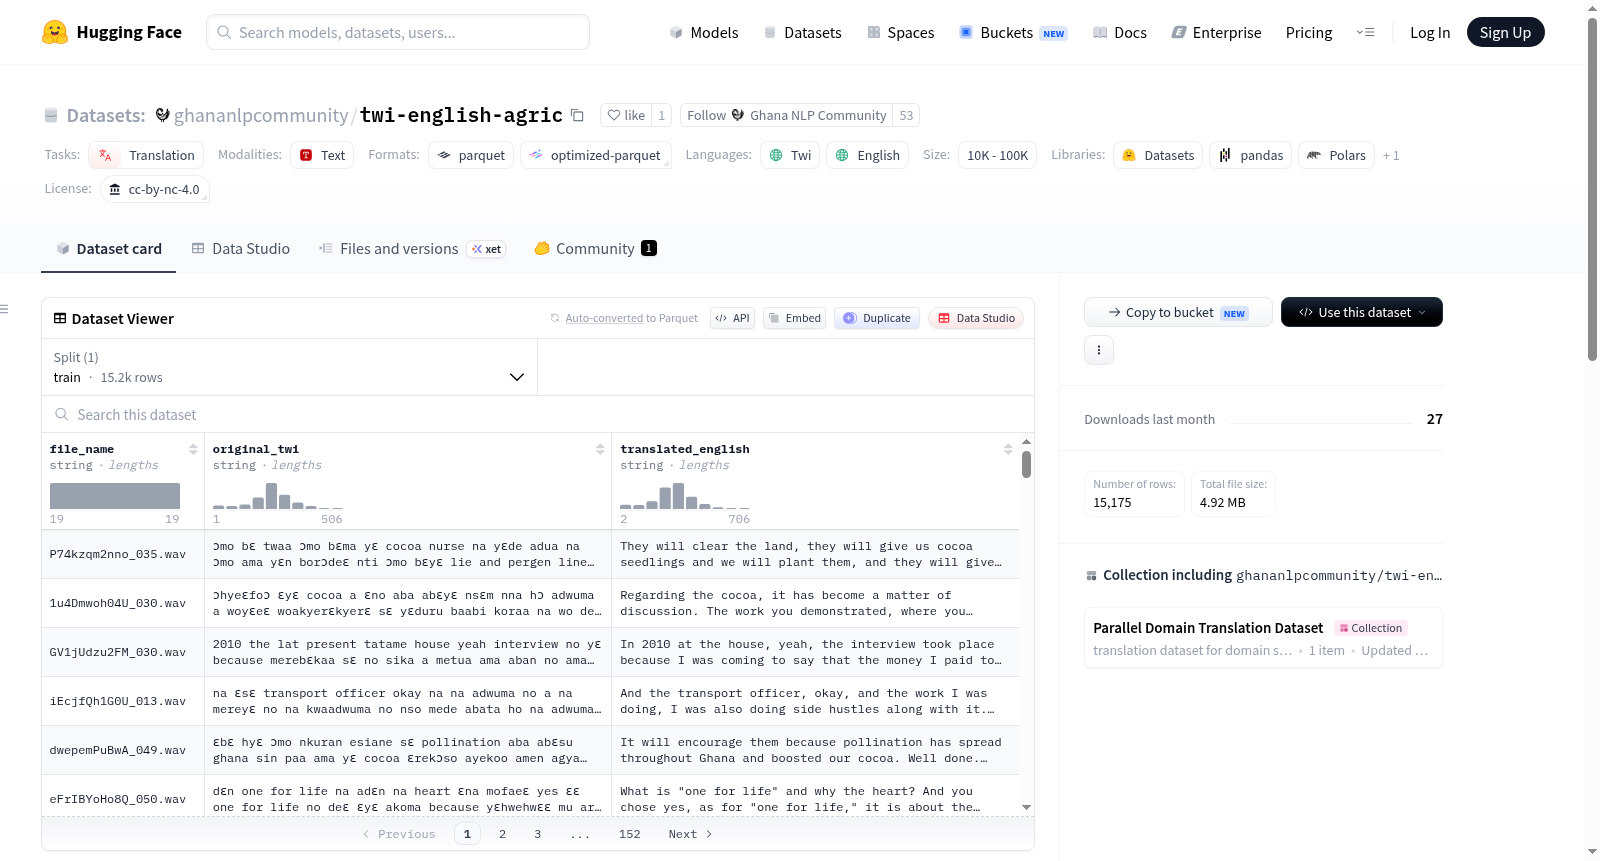
这是一个平行语料库,包含**Twi(Akan)**转录及其**英语翻译**,专注于农业领域。数据提取自YouTube视频;原始视频ID可从文件名推断,确保完全可追溯性。 - **语言**:Twi(转录),英语(翻译) - **领域**:农业(可可种植、大蕉栽培、一般农业实践) - **来源**:YouTube视频(提取音频片段并转录) - **文件名约定**:`{YouTubeVideoID}_{segment}.wav` - 示例:`P74kzqm2nno_035.wav`来自YouTube视频`P74kzqm2nno`。

This is a parallel corpus of **Twi (Akan)** transcriptions and their **English translations**, focused on the agricultural domain. The data was extracted from YouTube videos; the original video ID can be inferred from the file name, ensuring full traceability. - **Languages**: Twi (transcription), English (translated) - **Domain**: Agriculture (cocoa farming, plantain cultivation, general farming practices) - **Source**: YouTube videos (audio segments extracted and transcribed) - **File Name Convention**: `{YouTubeVideoID}_{segment}.wav` - Example: `P74kzqm2nno_035.wav` comes from YouTube video `P74kzqm2nno`.
提供机构:
ghananlpcommunity
搜集汇总
数据集介绍
ghananlpcommunity/twi-english-agric 数据集图片
构建方式
该数据集的构建根植于农业领域对低资源语言翻译需求的迫切性,旨在弥合契维语与英语之间的语言鸿沟。研究团队从YouTube平台提取农业相关视频(如可可种植、大蕉栽培等),通过视频ID与音频片段文件名建立溯源机制,确保数据可验证性。每个音频片段被转录为契维语文本,并由专业译者完成英文翻译,最终形成平行语料对。文件名采用`{视频ID}_{片段序号}.wav`的规范格式,既保留原始来源信息,又为后续数据扩充提供统一框架。
特点
该数据集的核心特色在于其领域专精性与语言对稀缺性。聚焦农业场景,覆盖可可、大蕉等西非典型作物,为农业技术传播与方言处理提供针对性支持。作为首个面向契维语-英语农业场景的并行语料库,其每一条记录均包含音频文件名、契维语转录与英文翻译三要素,形成结构化并行数据。数据规模虽小(不足千条),但通过YouTube视频ID的追踪设计,赋予每一条数据可溯源性,便于研究者验证翻译质量或扩展其他农业子领域。
使用方法
使用者可通过HuggingFace的datasets库直接加载该数据集,调用`load_dataset("ghananlpcommunity/twi-english-agric")`即可获取训练集。加载后数据以字典形式呈现,键`file_name`对应音频源标识,`transcription`与`translated_english`分别提供契维语原文及英文译文。该数据集适用于训练面向农业领域的神经机器翻译模型,或作为跨语言信息检索系统的基准语料。开发者亦可基于文件命名规则,结合原始YouTube视频进行多模态研究。需注意数据集采用CC BY-NC 4.0许可,仅限非商业科研与教育用途。
背景与挑战
背景概述
在自然语言处理领域,低资源语言机器翻译一直是极具挑战的研究方向,尤其是面向特定领域的翻译资源更为稀缺。Twi(契维语)作为加纳主要本土语言之一,在农业知识传播中扮演关键角色,然而其与英语之间的平行语料库长期匮乏。为此,Ghana NLP Community于近期构建了Twi–English Parallel Corpus for Agriculture,旨在填补农业领域Twi–英语机器翻译的数据空白。该数据集源自YouTube农业相关视频(如可可种植、大蕉栽培等),通过音频分割、转录及人工翻译形成高质量平行语料,每条数据均保留原始视频ID以确保可追溯性。该语料库的发布不仅推动了西非低资源语言的机器翻译研究,也为农业技术推广、数据驱动语言保护等跨学科研究提供了基础支撑。
当前挑战
该数据集所面临的挑战主要涵盖领域问题与研究构建两方面。在领域问题上,农业术语在Twi中缺乏标准化表达,不同地区或视频来源可能采用差异化的方言用词,导致翻译一致性难以保证。此外,农业口语语料中常伴有背景噪音、语速变化及非完整句式,增加了转录与对齐的难度。在构建过程中,从YouTube视频提取音频并逐段人工转写翻译成本高昂,且受限于开放视频的数量与质量,数据集规模不足1000条,难以支撑大规模神经机器翻译模型的充分训练。同时,CC BY-NC 4.0许可限制了商业化应用,进一步缩小了该数据集的可用场景与潜在贡献范围。
常用场景
经典使用场景
在自然语言处理与低资源语言机器翻译的交叉领域中,Twi-英语农业平行语料库为跨语言信息检索与农业知识传播提供了基础数据支撑。该数据集聚焦于加纳阿坎语支中的Twi语言,收录了来自YouTube农业视频的音频转录及其英文翻译,涵盖可可种植、大蕉栽培等农事活动。研究者可借此构建端到端的神经机器翻译模型,在农业专有名词与口语化表达之间建立精确映射,从而突破低资源语言翻译系统的数据瓶颈,助力农业技术向非洲本土语言的迁移与普及。
实际应用
在实际应用中,该数据集驱动的翻译系统可将复杂农技指南(如病虫害防治手册、作物管理方案)实时转化为Twi方言语音或文本,通过移动端应用触达加纳农村地区的非英语农户。当小农遇到栽培难题时,仅用母语描述症状即可获得英文农业知识库的精准回译,该流程亦可用于构建双语问答智能代理。此外,数据集支持农业技术推广员录制本地化教学视频并自动生成英文标注,加速跨语言农技培训课程的多模态开发,最终形成“方言输入-系统理解-知识反馈”的闭环服务生态。
衍生相关工作
基于该数据集,学界已衍生出若干标志性工作:部分研究者将其与约鲁巴语、斯瓦希里语等其他非洲低资源语料联合训练,提出基于混合专家模型的多语言农业翻译框架,显著提升跨语种知识泛化能力;另有团队借鉴其按YouTube视频ID溯源的元数据设计,构建了可扩展的弱监督数据采集流水线,成功迭代出Twi-英语法律与医疗领域平行语料。更引人注目的是,该数据集催生了面向西非口语方言的端侧语音翻译模型,通过知识蒸馏与量化技术实现离线部署,为无网络覆盖地区的农业智能化提供了可复现的技术原型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

