
遇见数据集

TTS-AGI/podcast-tokenized-bg3.5-enj5-with-speaker-embeddings

收藏
Hugging Face2026-06-23 更新2026-07-22 收录
官方服务:

资源简介:

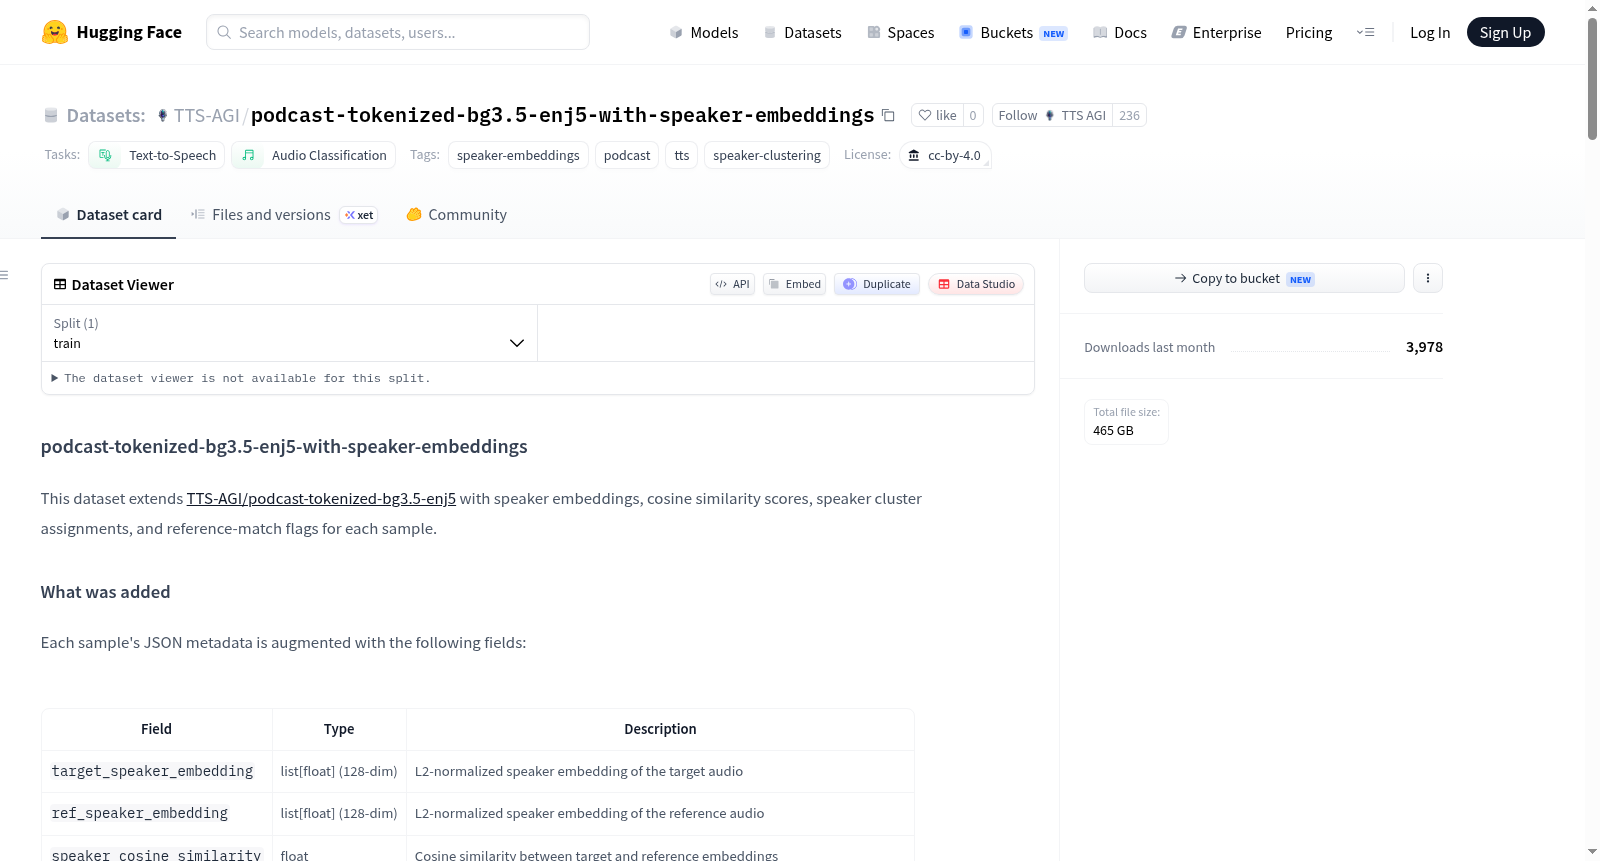
该数据集是TTS-AGI/podcast-tokenized-bg3.5-enj5的扩展版本,增加了说话人嵌入、余弦相似度分数、说话人聚类分配和参考匹配标志。每个样本的JSON元数据包含以下字段:target_speaker_embedding(目标音频的L2归一化说话人嵌入,128维)、ref_speaker_embedding(参考音频的L2归一化说话人嵌入,128维)、speaker_cosine_similarity(目标与参考嵌入的余弦相似度)、ref_matches_target(参考和目标是否为同一说话人,基于余弦相似度阈值0.42)、speaker_cluster_id(基于10,000个预计算说话人质心的最近聚类分配)。数据集使用DACVAE模型将潜在表示解码为48kHz音频,并使用Speaker-wavLM-tbr模型从16kHz音频中提取128维说话人嵌入。处理流程包括解码、截断、重采样、嵌入提取、相似度计算和聚类分配。数据集包含1,828,199个样本,分布在481个tar文件中,85.4%的样本参考音频与目标音频来自同一说话人,适用于语音克隆和说话人条件TTS任务。聚类分析基于10,000个质心,分布右偏,中位聚类大小为63个样本。还提供了说话人相似度阈值分析,推荐阈值用于高置信度说话人匹配。

This dataset is an extended version of TTS-AGI/podcast-tokenized-bg3.5-enj5, with added speaker embeddings, cosine similarity scores, speaker cluster assignments, and reference matching flags. The JSON metadata for each sample includes the following fields: target_speaker_embedding (L2-normalized 128-dimensional speaker embedding extracted from the target audio), ref_speaker_embedding (L2-normalized 128-dimensional speaker embedding extracted from the reference audio), speaker_cosine_similarity (cosine similarity score between the target and reference speaker embeddings), ref_matches_target (indicator of whether the reference and target audio originate from the same speaker, determined using a cosine similarity threshold of 0.42), and speaker_cluster_id (nearest cluster assignment based on 10,000 pre-computed speaker centroids). The dataset uses the DACVAE model to decode latent representations into 48 kHz audio, and employs the Speaker-wavLM-tbr model to extract 128-dimensional speaker embeddings from 16 kHz audio. The processing pipeline consists of decoding, truncation, resampling, embedding extraction, similarity calculation, and cluster assignment. This dataset contains 1,828,199 samples spread across 481 tar files; 85.4% of the samples have reference and target audio from the same speaker, and it is suitable for voice cloning and speaker-conditioned TTS tasks. Cluster analysis is based on 10,000 centroids, with a right-skewed cluster size distribution and a median cluster size of 63 samples. Speaker similarity threshold analysis is also provided, with recommended thresholds for high-confidence speaker matching.
提供机构:
TTS-AGI
搜集汇总
数据集介绍
TTS-AGI/podcast-tokenized-bg3.5-enj5-with-speaker-embeddings 数据集图片
构建方式
本数据集在TTS-AGI/podcast-tokenized-bg3.5-enj5的基础上进行深度扩展。构建流程首先利用DACVAE模型将潜在表征解码为48kHz波形,随后截取20秒片段并重采样至16kHz,通过Speaker-wavLM-tbr模型批量提取128维音色说话人嵌入。在获得目标与参考音频的L2归一化嵌入后,计算两者间余弦相似度,并依据F1最优阈值0.42判定是否为同一说话人。最终,将每条样本的嵌入、相似度得分及说话人聚类标签(源于10,000个EmoLIA说话人质心)等元数据注入JSON文件,重新打包为WebDataset格式的tar文件。整个处理流程在8块A100 GPU上耗时约34小时,辅以CPU集群进行约6小时的聚类分配,共生成481个tar文件,涵盖1,828,199条样本,无一失败。
特点
该数据集的核心亮点在于每条样本均配备了丰富的说话人身份信息。除目标与参考音频的L2归一化128维说话人嵌入外,还包含两者间的余弦相似度、基于0.42阈值的说话人匹配标签,以及从10,000个预计算质心中分配的最近聚类ID。统计显示85.4%的样本参考与目标音频属于同一说话人,天然适配语音克隆与说话人条件式文本转语音任务;其余14.6%的样本则引入了说话人不匹配的多样性。聚类分布呈现显著右偏特性,平均每簇198.6条样本,中位数仅63条,多数样本集中在少数大簇中。数据集中附带了详尽的聚类统计报告与平衡策略分析,为后续不同规模的训练数据筛选提供了参考依据。
使用方法
调用数据集时,用户可通过读取WebDataset格式的tar文件获取音频潜在表征(.npy和.ref.npy)以及对应的JSON元数据。对于文本转语音任务,可直接利用ref_matches_target为True的样本进行说话人条件式训练,无需额外过滤。当需要平衡不同说话人的样本数量时,可参考README中提供的聚类大小分布与封顶策略,例如设定每簇最多109条样本可保留574,441条自然样本,再通过上采样426K条数据达到100万总体规模,从而在保证说话人多样性的同时提升训练效率。对于说话人验证或聚类任务,可直接使用预提取的128维嵌入进行下游分析,并依据推荐的余弦相似度阈值(低于0.42视为不同说话人)进行可靠判断。
背景与挑战
背景概述
在语音合成与说话人识别领域,大规模、多说话人的高质量数据集是推动技术发展的关键基石。podcast-tokenized-bg3.5-enj5-with-speaker-embeddings数据集由TTS-AGI机构于近期创建,旨在突破现有语音数据集在说话人嵌入信息缺失方面的局限。该数据集在已有的podcast-tokenized-bg3.5-enj5基础上,系统性地集成了说话人嵌入向量、余弦相似度及聚类标签,为文本到语音合成及说话人聚类任务提供了丰富的声纹特征信息。通过引入1,828,199个样本及其对应的参考音频,该数据集显著提升了语音生成模型在说话人条件控制上的精度,尤其适用于语音克隆、多说话人自适应TTS等前沿研究场景,对推动个性化语音交互技术的发展具有重要影响力。
当前挑战
该数据集所解决的领域问题核心在于跨说话人语音合成中的声纹一致性挑战——传统TTS模型常因缺乏精细的说话人表征导致合成音色失配或风格漂移。为了实现可靠的说话人条件控制,构建过程面临多重技术难点:首先,从高质量48kHz DACVAE潜变量解码并重新采样至16kHz以提取嵌入向量,这一流程需保持音频保真度同时避免计算瓶颈;其次,需在8×A100 GPU上耗时34小时完成181万样本的嵌入提取,要求批处理优化与内存管理的高度协调;最后,通过F1最优阈值0.42判定参考音频与目标是否同源,并借助10,000个预计算聚类中心进行分配,需要平衡聚类粒度与计算效率,尤其面对长尾分布中39.1%的小规模类簇,确保数据均衡成为额外挑战。
常用场景
经典使用场景
在语音合成与处理领域,该数据集专为说话人条件化的文本到语音合成(TTS)与说话人聚类任务而设计。其核心价值在于,每个样本不仅包含目标语音与参考语音的离散编码(DACVAE潜在表示),还附带了128维的L2归一化说话人嵌入向量、两者的余弦相似度分数、基于F1最优阈值判定的说话人匹配标签,以及从一万个预计算说话人质心中分配的聚类编号。研究者可直接利用这些元数据进行说话人自适应的TTS训练、零样本语音克隆,或开展大规模说话人聚类分析,而无需自行提取嵌入或设计复杂的相似度判定流程。
解决学术问题
该数据集巧妙回应了多说话人语音合成中跨样本说话人一致性难以量化保障的学术难题。通过提供基于WavLM-Large骨干网络提取的细粒度音色嵌入和预优化的相似度阈值,它为TTS模型训练中正负样本对的自动筛选提供了可靠依据,使模型能够区分同说话人与异说话人样本。同时,其海量样本(超182万条)与聚类标注(涵盖9204个非空类)极大地推动了说话人解耦学习、长尾分布下的Few-shot说话人自适应,以及大规模聚类算法在真实播客数据上的鲁棒性研究,为提升合成语音的自然度与身份一致性奠定了数据基石。
衍生相关工作
围绕该数据集已衍生出一系列经典研究工作。例如,TTS-AGI团队发布的原始播客分词数据集为其前身,而本版本通过引入Orange/Speaker-wavLM-tbr嵌入模型与EmoLIA聚类方案,开创了将高维音色特征直接嵌入大规模TTS管线的高效范式。该数据集中的聚类统计报告和平衡策略表(如按聚类大小进行上采样或截断)直接启发了后续工作关于长尾说话人分布下TTS模型公平性与多样性的探讨。此外,基于Gemini 2.5 Flash进行的说话人相似度阈值分析,提供了一个利用大语言模型辅助音频任务判断的跨模态验证案例,促使研究者探索更多LLM与语音系统协同的实验框架。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

