Cosmos3-Driving-Simulation-Evaluation
收藏资源简介:
Cosmos3 Driving Simulation Evaluation 是由 NVIDIA Corporation 发布的数据集(V1.0,创建日期 2026-10-20,许可 OpenMDW-1.1),面向自动驾驶相关用例,尤其是基于 World Scenario Map(WSM)控制条件对 Cosmos3 驾驶仿真进行公开的文本到视频评估。该数据集提供结构化的场景控制与文本提示,用于多视角驾驶生成与评估,但不用于训练感知模型或驾驶模型。 数据集包含 91 个驾驶场景,每个场景有 11 个相机视角,共 1,001 个 WSM 控制视频(mp4,30fps)以及 1,001 个带时间戳的 caption JSON 文件。WSM 控制来自 NVIDIA 采集的真实驾驶数据,表示车道线、对象边界框和交通灯状态;控制视频是场景结构的抽象渲染,而非相机录制。数据收集方式为自动/传感器,标注方式为自动并经人工质量保证:先用 NVIDIA 内部模型在源视频上标注车道线和对象边界框,人工检查,再用脚本转换为 WSM 控制,内部 caption 模型为每个相机视角生成文本 caption 作为评估提示,最后丢弃所有相机图像,仅发布 WSM 控制和文本提示。 发布内容包括 WSM 4.0.1 渲染的控制视频、每相机视角 caption、场景/视角清单、测量的视频属性和文件校验和。不包含源 RGB 相机图像或视频、LiDAR 数据、标定、原始场景标注或模型生成输出,也不包含原始或重风格化首帧图像。清单未区分标准或长时 rollout 子集;控制视频时长为 11.7 至 21.9 秒。 在规模与格式方面,记录数为 91 个多视角序列(每个序列 11 个相机视角),规模分箱为 n<1K,每条记录对应一个序列。视频长度 351 至 657 帧(30fps 下 11.7 至 21.9 秒)。分辨率因相机类型和序列而异:七个标准相机在 53 个序列中为 1924×1084,在 38 个序列中为 1920×1080;四个鱼眼相机在 53 个序列中为 1720×1080,在 38 个序列中为 1350×1080。总存储量约 2.59 GB(十进制)。文件组织包括 wsm/scene-001/camera_front_wide_120fov.mp4 等,captions/scene-001/camera_front_wide_120fov.json 等;manifest.jsonl 每个场景一条记录,按 camera_key 分组 11 个视角,含仓库相对路径 wsm_path 和 caption_path;metadata.jsonl 每个相机视角一条记录,将控制视频链接到完整 caption 文本及用于 viewer 的测量视频属性;checksums.json 为每个其他发布负载文件提供 SHA-256 和字节大小;scene-001 至 scene-091 为发布本地标识符。 相机键包括 camera_front_wide_120fov、camera_cross_left_120fov、camera_cross_right_120fov、camera_rear_left_70fov、camera_rear_right_70fov、camera_rear_tele_30fov、camera_front_tele_30fov、camera_front_fisheye_200fov、camera_left_fisheye_200fov、camera_rear_fisheye_200fov、camera_right_fisheye_200fov。匹配文件应按 camera_key,而不是目录列表顺序。 Caption JSON 保留结构化 caption 格式,例如包含 caption_structured 下按 chunk 组织的 caption、start_frame、end_frame 等;该示例是模式说明,不是额外样本。Caption 为带时间戳的 Tier1 版本,并进行了隐私清理,移除可识别文本,包括车牌值,同时保留通用描述(如车辆有可见车牌);时间戳字符串、帧边界和其他 JSON 字段保留。Caption 是机器生成描述,可能包含错误;隐私清理并非对所有场景描述的纠正,也不是对物理相机标定的独立验证。 使用上,数据集配置为 default,test split 包含整个评估集合,不提供训练 split。Hugging Face Dataset Viewer/Data Studio 中 viewer 有 1,001 行,而非 1,001 个独立场景;应按 sample_id 分组以恢复 91 个多视角场景。每行包含一个可播放 WSM 视频及匹配的带时间戳 caption。可用场景 ID(如 scene-001)查找 11 个相机视角,用 camera_key 标识视角,如 camera_front_wide_120fov;读取 caption 获得完整提示,caption_path 指向 Files 标签页中的匹配结构化 JSON。可检查 width、height、fps、num_frames、duration_seconds 获取原生控制视频属性;caption_start_frame 和 caption_end_frame 描述 caption 窗口,而非完整视频时长。Viewer 逐相机显示视频,不是同步环视播放器,仅显示 WSM 控制和 caption,不显示 RGB 录制或 LiDAR。托管浏览要求数据位于默认分支并由 Hugging Face 处理,仅 PR 中提出的文件不是经验证的实时 viewer;受限仓库需要访问权限。下载可直接使用 hf download 命令,无需 ZIP 解压;受限期间需要认证,下载元数据使用相对路径且不含内部存储位置。 适用任务:基于 WSM 控制和伴随文本提示,对 Cosmos3 驾驶仿真进行公开文本到视频评估,特别是评估以 WSM 控制为条件的 Cosmos3 驾驶仿真。其规模和跨相机视角分布支持合成驾驶场景评估。仅限自动驾驶相关用例,商业与非商业需符合许可条款;不用于训练感知或驾驶模型。 主要限制包括:样本小,91 个场景覆盖的道路类型、区域、交通密度和天气有限,结果可能无法泛化;单一条件格式,结果适用于 WSM 条件,可能无法迁移到深度、分割或边缘图等其他条件;标注错误,车道线和边界框来自自动模型加人工 QA,仍可能有漏标或错位对象;仅布局,WSM 编码场景几何和交通灯状态,不编码外观、光照、天气或路面细节。伦理方面,NVIDIA 认为可信 AI 是共同责任,开发者应与内部团队合作确保数据集满足相关行业和用例要求并应对意外误用。隐私方面,数据集不含相机图像、人脸、车牌或可读文本,道路代理仅以边界框出现。质量、风险、安全漏洞或 NVIDIA AI 问题可通过 README 提供的链接报告。
Cosmos3 Driving Simulation Evaluation is a dataset released by NVIDIA Corporation (V1.0, created on 2026-10-20, license OpenMDW-1.1), aimed at autonomous driving related use cases, especially public text-to-video evaluation of Cosmos3 driving simulation conditioned on World Scenario Map (WSM) control. It provides structured scene control and text prompts for multi-view driving generation and evaluation, but it is not intended for training perception models or driving models. The dataset contains 91 driving scenes, each with 11 camera views, totaling 1,001 WSM control videos (mp4, 30fps) and 1,001 timestamped caption JSON files. WSM control comes from real driving data collected by NVIDIA and represents lane lines, object bounding boxes, and traffic light states; control videos are abstract renderings of scene structure, not camera recordings. Data collection is automatic/sensor based, and annotation is automatic with human quality assurance: NVIDIA internal models first annotate lane lines and object bounding boxes on source videos, humans check them, scripts convert them to WSM control, an internal caption model generates text captions for each camera view as evaluation prompts, and all camera images are then discarded so that only WSM control and text prompts are released. Released content includes WSM 4.0.1 rendered control videos, per-camera-view captions, scene/view manifests, measured video properties, and file checksums. It does not include source RGB camera images or videos, LiDAR data, calibration, raw scene annotations, model-generated outputs, or original or restyled first-frame images. The manifest does not distinguish standard or long rollout subsets; control videos are 11.7 to 21.9 seconds long. In scale and format, records are 91 multi-view sequences (11 camera views per sequence), scale bin n<1K, with each record corresponding to one sequence. Video length is 351 to 657 frames (11.7 to 21.9 seconds at 30fps). Resolution varies by camera type and sequence: seven standard cameras are 1924x1084 in 53 sequences and 1920x1080 in 38 sequences; four fisheye cameras are 1720x1080 in 53 sequences and 1350x1080 in 38 sequences. Total storage is about 2.59 GB decimal. File organization includes wsm/scene-001/camera_front_wide_120fov.mp4 and captions/scene-001/camera_front_wide_120fov.json, among others; manifest.jsonl has one record per scene, grouped by camera_key for 11 views, with repository-relative wsm_path and caption_path; metadata.jsonl has one record per camera view, linking control video to full caption text and measured video properties for the viewer; checksums.json provides SHA-256 and byte size for each other released payload file; scene-001 to scene-091 are release-local identifiers. Camera keys include camera_front_wide_120fov, camera_cross_left_120fov, camera_cross_right_120fov, camera_rear_left_70fov, camera_rear_right_70fov, camera_rear_tele_30fov, camera_front_tele_30fov, camera_front_fisheye_200fov, camera_left_fisheye_200fov, camera_rear_fisheye_200fov, and camera_right_fisheye_200fov. Matching files should be based on camera_key, not directory listing order. Caption JSON keeps a structured caption format, for example containing chunk-organized captions under caption_structured, start_frame, end_frame, etc.; that example is a schema description, not an additional sample. Captions are timestamped Tier1 versions and are privacy cleaned, removing identifiable text including license plate values while retaining generic descriptions such as a vehicle having a visible license plate; timestamp strings, frame boundaries, and other JSON fields are retained. Captions are machine-generated descriptions and may contain errors; privacy cleaning is not a correction of all scene descriptions and is not independent verification of physical camera calibration. For usage, the dataset is configured as default, and the test split contains the entire evaluation set; no training split is provided. In Hugging Face Dataset Viewer/Data Studio, the viewer has 1,001 rows rather than 1,001 independent scenes; grouping by sample_id should be used to recover the 91 multi-view scenes. Each row contains one playable WSM video and matching timestamped caption. Scene IDs such as scene-001 can be used to find 11 camera views, camera_key identifies the view, such as camera_front_wide_120fov; read caption for the full prompt, and caption_path points to the matching structured JSON in the Files tab. Check width, height, fps, num_frames, and duration_seconds for native control video properties; caption_start_frame and caption_end_frame describe the caption window, not full video duration. The viewer displays videos per camera, not as a synchronized surround-view player, and shows only WSM control and captions, not RGB recordings or LiDAR. Hosted browsing requires the data to be on the default branch and processed by Hugging Face; files only proposed in PRs are not a verified live viewer; restricted repositories require access permissions. Download can be done directly with the hf download command without ZIP extraction; authentication is required during restriction, and download metadata uses relative paths and does not contain internal storage locations. Applicable task: public text-to-video evaluation of Cosmos3 driving simulation based on WSM control and accompanying text prompts, especially evaluating Cosmos3 driving simulation conditioned on WSM control. Its scale and cross-camera-view distribution support synthetic driving scene evaluation. It is limited to autonomous driving related use cases, commercial and non-commercial use must comply with license terms, and it is not for training perception or driving models. Main limitations include: small sample size, with 91 scenes covering limited road types, regions, traffic density, and weather, so results may not generalize; single condition format, so results apply to WSM conditions and may not transfer to other conditions such as depth, segmentation, or edge maps; annotation errors, because lane lines and bounding boxes come from automatic models plus human QA and may still miss or misplace objects; layout only, because WSM encodes scene geometry and traffic light states but not appearance, lighting, weather, or road surface details. Ethically, NVIDIA considers trustworthy AI a shared responsibility, and developers should work with internal teams to ensure the dataset meets relevant industry and use-case requirements and to address unintended misuse. For privacy, the dataset contains no camera images, faces, license plates, or readable text, and road agents appear only as bounding boxes. Quality, risk, security vulnerabilities, or NVIDIA AI issues can be reported through the link provided in the README.
Cosmos3 Driving Simulation Evaluation 数据集概述
1. 基本信息
- 数据集地址:https://huggingface.co/datasets/nvidia/Cosmos3-Driving-Simulation-Evaluation
- 数据集所有者:NVIDIA Corporation
- 创建日期:2026-10-20
- 版本:V1.0,无先前版本
- 许可证:OpenMDW License Agreement, version 1.1 (OpenMDW-1.1),https://openmdw.ai/license/1-1/
- 语言:en
- 标签:video、autonomous-driving、simulation、multiview
- 配置:default;drop_labels: true;test split;数据文件包括 WSM mp4 与 metadata.jsonl
2. 数据摘要
- 包含 91 个驾驶场景。
- 每个场景包含 11 个相机视图。
- 包含 1,001 个 World Scenario Map (WSM) 控制视频。
- 包含 1,001 个匹配的时间戳 caption JSON 文件。
3. 数据描述
- 提供结构化场景控制和文本提示,用于多视图驾驶生成与评估。
- WSM 控制来自 NVIDIA 采集的真实世界驾驶数据。
- WSM 控制表示车道线、物体边界框和交通灯状态。
- 包含:WSM 4.0.1 渲染控制视频、每相机 caption、场景/视图清单、测量的视频属性、文件校验和。
- 不包含:源 RGB 相机图像或视频、LiDAR 数据、校准、原始场景注释、模型生成输出。
- WSM 视频是场景结构的抽象渲染,不是相机记录。
- 不包含原始或重风格第一帧图像。
- 发布清单未标识单独的 standard 或 long-rollout 子集。
- 控制视频长度为 11.7–21.9 秒。
4. 预期用途
- 仅用于自动驾驶相关用例。
- 包括商业和非商业用途,需符合适用许可证条款。
- 其规模和跨相机视图分布支持合成驾驶场景评估。
- 用于使用 WSM 控制和伴随文本提示对 Cosmos 驾驶模拟进行公开 text-to-video 评估。
- 具体用于评估以 WSM 控制为条件的 Cosmos3 驾驶模拟。
- 不用于训练感知模型或驾驶模型。
5. 数据特征与生成流程
- 数据收集方法:自动/传感器。
- 传感器采集的驾驶数据被处理为 WSM 控制。
- 标注方法:自动。
- 人类审查员为自动标注提供质量保证。
- 处理步骤:
- NVIDIA 内部模型在源素材上标注车道线和物体边界框。
- 人类审查员检查标注质量。
- 脚本将审查后的标注转换为 WSM 控制。
- NVIDIA 内部 caption 模型为每个相机视图生成文本 caption,用作评估文本提示。
- 丢弃所有相机图像,仅发布 WSM 控制和文本提示。
6. 数据格式与量化
- 模态:视频和文本。
- WSM 控制视频格式:mp4,30fps。
- 每个视频显示场景布局随时间变化:车道线、物体边界框、交通灯状态。
- 文本 captions 以每场景 11 个单独 JSON 文件提供,每个相机视图一个。
- 记录数:91 个多视图序列,每序列 11 个相机视图。
- 规模分箱:n<1K,每条记录为一个序列。
- 视频长度:351–657 帧,即 11.7–21.9 秒,30fps。
- 分辨率:
- 七个标准相机:53 个序列为 1924 × 1084,或 38 个序列为 1920 × 1080。
- 四个鱼眼相机:53 个序列为 1720 × 1080,或 38 个序列为 1350 × 1080。
- 总存储大小:约 2.59 GB,十进制。
7. 文件与查看
- manifest.jsonl:每个场景一条记录,按 camera_key 分组全部 11 个视图,包含仓库内 wsm_path 与 caption_path 值。
- metadata.jsonl:每个相机视图一条记录,将其控制视频链接到完整 caption 文本和测量视频属性,供数据集查看器使用。
- checksums.json:为每个其他发布负载文件提供 SHA-256 和字节大小。
- scene-001 至 scene-091 是发布本地标识符。
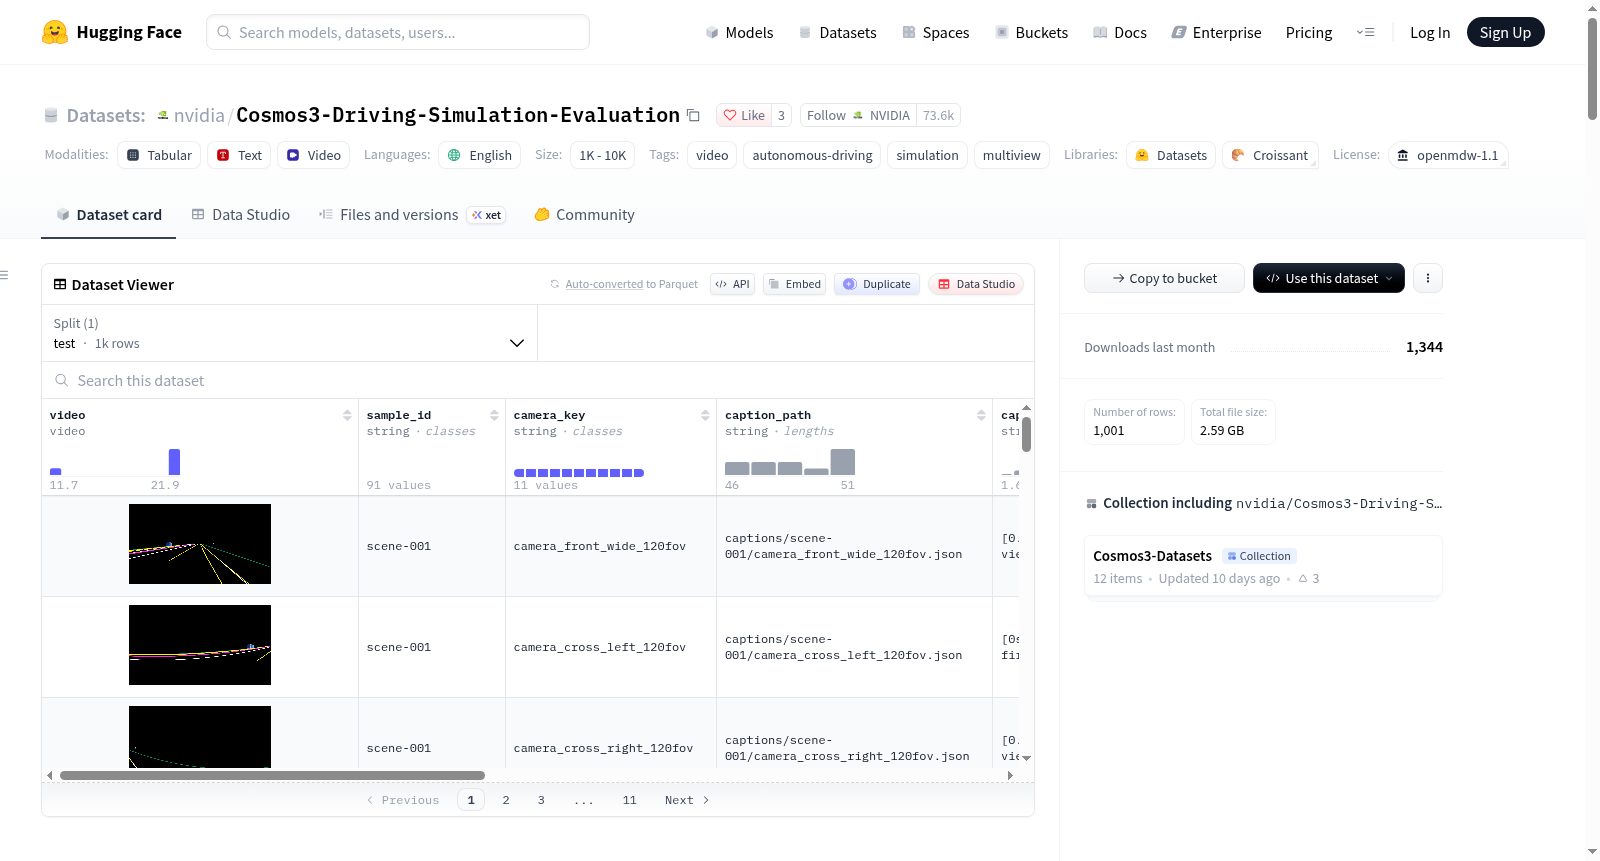
- 查看器有 1,001 行,不是 1,001 个独立场景。
- 按 sample_id 分组行可恢复 91 个多视图场景。
- test split 包含整个评估集合;未提供训练 split。
- 浏览方式:使用数据集页面内置 Dataset Viewer / Data Studio,配置为 default,split 为 test。
- 每行包含一个可播放 WSM 视频及其匹配的时间戳 caption。
- 可搜索 scene ID,如 scene-001,以查找其 11 个相机视图。
- 使用 camera_key 识别视图,例如 camera_front_wide_120fov。
- 读取 caption 可获取完整提示。
- caption_path 指向 Files 标签页中匹配的结构化 JSON。
- 检查 width、height、fps、num_frames、duration_seconds 可获取原生控制视频属性。
- caption_start_frame 和 caption_end_frame 描述 caption 窗口,不是完整视频时长。
- 内置查看器逐个显示相机视频,不是同步环绕播放器。
- 查看器仅显示 WSM 控制和 captions,不显示 RGB 录制或 LiDAR。
- 托管浏览要求数据位于数据集默认分支并由 Hugging Face 处理;仅在 pull request 中提出的文件不是已验证的实时查看器。
- 受限仓库需要访问权限。
8. 相机名称
每个场景包含以下 camera keys。按 camera key 匹配文件,而不是按目录列出顺序。
- camera_front_wide_120fov
- camera_cross_left_120fov
- camera_cross_right_120fov
- camera_rear_left_70fov
- camera_rear_right_70fov
- camera_rear_tele_30fov
- camera_front_tele_30fov
- camera_front_fisheye_200fov
- camera_left_fisheye_200fov
- camera_rear_fisheye_200fov
- camera_right_fisheye_200fov
9. Captions 与时间信息
- 每个 JSON 保留结构化 caption 格式。
- 示例 schema 展示 caption_structured、chunk_0_300、caption、start_frame、end_frame 等字段。
- 该示例是 schema 说明,不是额外样本。
- 应使用每个文件实际的 chunk keys、帧边界和时间戳文本。
- Captions 是时间戳 Tier1 版本,并进行了识别文本隐私清理。
- Captions 不是新的环境提示重写。
- 隐私清理移除转录的识别值,包括车牌值。
- 保留通用描述,例如车辆具有可见车牌。
- 时间戳字符串、帧边界和其他 JSON 字段被保留。
- 控制视频保留原始字节、帧率、尺寸和时长。
- 控制视频可能比其 caption 窗口更长。
- 选择生成间隔时应使用 caption 的帧边界。
- 不应假设 caption 描述整个 MP4。
- metadata.jsonl 记录测量控制尺寸、帧数、帧率和时长。
- 上传不裁剪、不重定时、不缩放、不重新编码控制视频。
- Captions 是机器生成描述,可能包含错误。
- 隐私清理不是对所有场景描述的纠正,也不是对物理相机校准的独立验证。
10. 局限
- 小样本:91 个场景覆盖的道路类型、区域、交通密度和天气范围有限;结果可能无法泛化到其他驾驶场景。
- 单一条件格式:结果适用于 WSM 条件,可能无法迁移到其他条件格式,如深度、分割或边缘图。
- 标注错误:车道线和边界框来自自动模型并经人工 QA;可能仍存在漏标或错位物体。
- 仅布局:WSM 编码场景几何和交通灯状态;不编码外观、光照、天气或路面细节。
11. 伦理与安全
- NVIDIA 认为可信 AI 是共同责任,已建立政策和实践,支持广泛 AI 应用开发。
- 开发者应与内部开发者团队合作,确保该数据集满足相关行业和用例要求,并应对未预见的误用。
- 隐私:数据集不包含相机图像、人脸、车牌或可读文本。
- 道路参与者仅以边界框出现。
- 质量、风险、安全漏洞或 NVIDIA AI Concerns 报告地址:https://www.nvidia.com/en-us/support/submit-security-vulnerability/
12. 参考与下载
- WSM 表示示例:https://github.com/NVIDIA/cosmos/blob/main/assets/demos/transfer_worldscenario.gif
- 该示例上半部分显示 WSM 控制,下半部分显示 Cosmos 生成视频。
- 发布数据集包含 WSM 控制和文本提示,不包含生成视频。
- 下载:使用 hf download 直接下载文件,无 ZIP 解压步骤。
- 可下载整个数据集。
- 也可下载单个场景的两个文件夹及清单文件。
- 仓库访问受限时需要认证。
- 下载所得元数据使用相对路径且不含内部存储位置。