tg-ru-engagement
收藏资源简介:
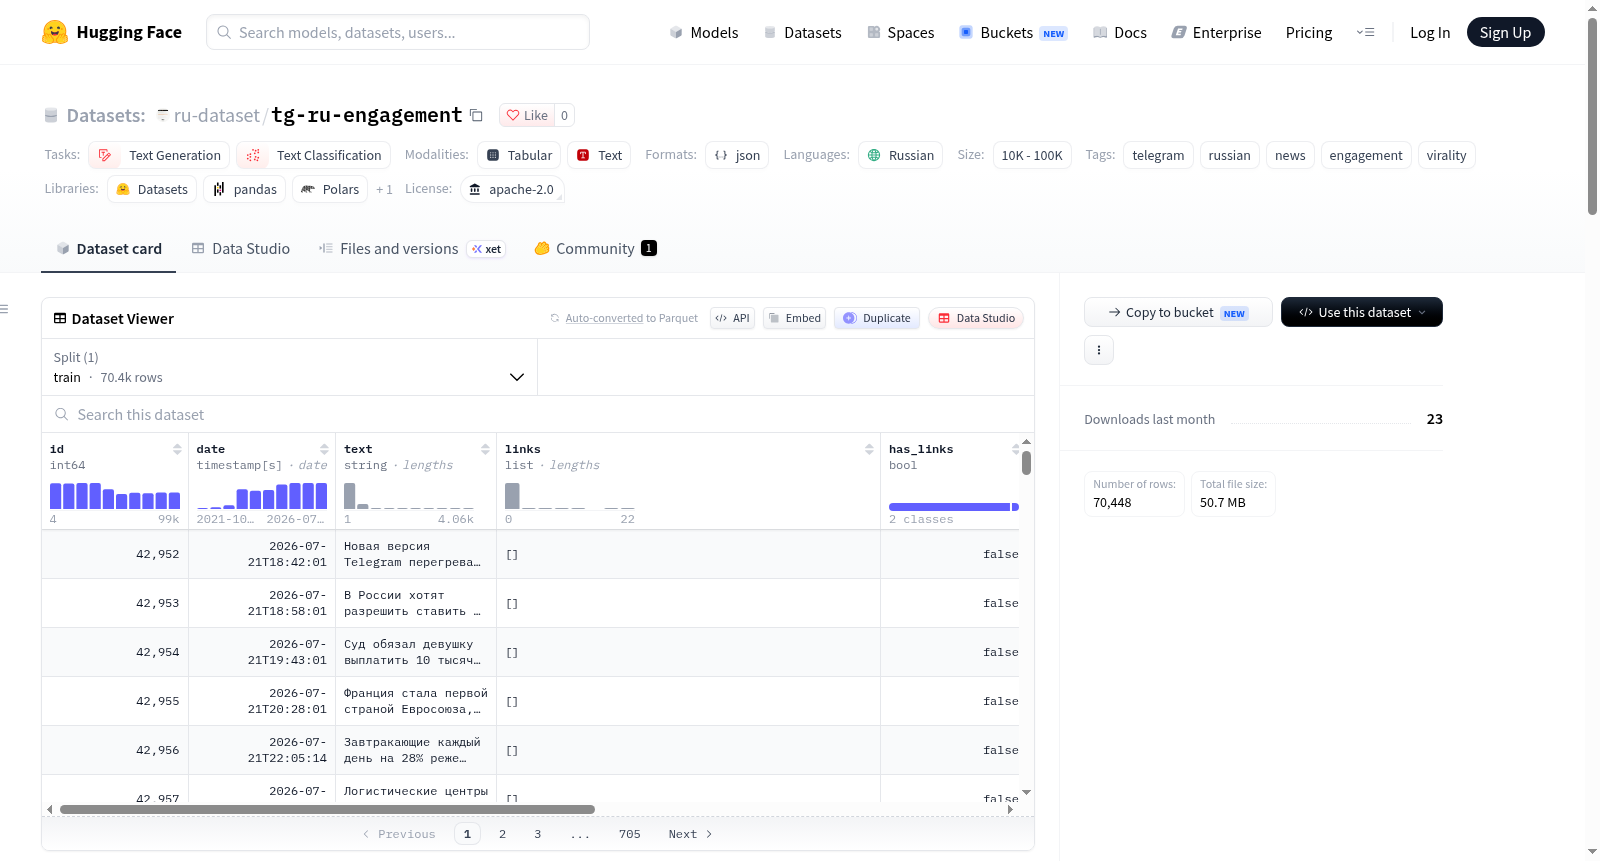
该数据集收录了来自俄语Telegram频道的帖子,每条帖子附带参与度指标(浏览量、转发量)。数据集包含70,448条记录,时间跨度从2021年10月至2026年7月,平均文本长度为274个字符。数据通过解析Telegram频道获得。字段包括:帖子ID(id)、发布日期(date,ISO 8601格式)、文本内容(text)、链接列表(links)、是否含链接(has_links)、是否含媒体(has_media)、媒体类型(media_type,可为photo/video/document/other或null)、浏览量(views)、转发量(forwards)、回复目标帖子ID(reply_to,可为null)。该数据集可用于:俄语语言模型的微调、基于文本的病毒性预测(回归浏览量/转发量)、Telegram内容风格与体裁分类、媒体消费与趋势分析。注意事项:数据集中包含未标注的广告帖子;文本中的链接未被展开;媒体文件本身未包含,仅提供元数据。
This dataset collects posts from Russian-language Telegram channels, with each post accompanied by engagement metrics including views and forwards. It contains 70,448 records spanning from October 2021 to July 2026, with an average text length of 274 characters. The data was obtained by scraping Telegram channels. The dataset includes the following fields: post ID (id), publication date (date, ISO 8601 format), text content (text), list of links (links), has_links (whether the post contains links), has_media (whether the post contains media), media_type (can be photo/video/document/other or null), views, forwards, and reply_to (the target post ID for replies, which can be null). This dataset can be used for fine-tuning Russian-language LLMs, text-based virality prediction via regression of views or forwards, classification of Telegram content styles and genres, and analysis of media consumption and trends. Notes: The dataset contains unlabeled advertising posts; links in the text have not been expanded; the actual media files are not included, only their metadata is provided.
数据集概述
基本信息
- 名称: Telegram Russian Posts with Engagement Metrics
- 语言: 俄语
- 许可证: Apache-2.0
- 任务类型: 文本生成、文本分类
- 数据规模: 70,448 条记录(10K<n<100K)
- 数据来源: Telegram 频道(通过解析获取)
- 时间范围: 2021年10月 — 2026年7月
数据内容
- 数据集包含俄语 Telegram 频道的帖子及其参与度指标(浏览量、转发量)。
- 平均文本长度为 274 个字符。
- 浏览量中位数为 145,109,最大浏览量达 6,933,562。
数据字段
| 字段 | 类型 | 描述 |
|---|---|---|
id |
int | 频道内帖子 ID |
date |
string | 发布时间(ISO 8601) |
text |
string | 帖子文本 |
links |
list | 文本中的链接列表 |
has_links |
bool | 是否包含链接 |
has_media |
bool | 是否包含媒体文件 |
media_type |
string/null | 媒体类型:photo、video、document、other |
views |
int | 浏览量 |
forwards |
int | 转发量 |
reply_to |
int/null | 所回复的帖子 ID |
数据处理
- 数据集包含一个默认配置
default,训练数据文件为channel_data_clean.json。 - 提供 Python 示例代码,支持使用
datasets库加载数据、按浏览量排序、按媒体类型过滤等操作。
预期用途
- 俄语语言模型的微调
- 基于文本的病毒性预测(浏览量/转发量回归)
- Telegram 内容的风格与流派分类
- 媒体消费与趋势分析
局限性
- 数据集中包含未单独标注的广告帖子。
- 文本内链接未被展开。
- 不包含媒体文件本身,仅提供其元数据。