
遇见数据集

openpecha/tibetan-metadata-llm-sft

收藏
Hugging Face2026-06-19 更新2026-07-22 收录
官方服务:

资源简介:

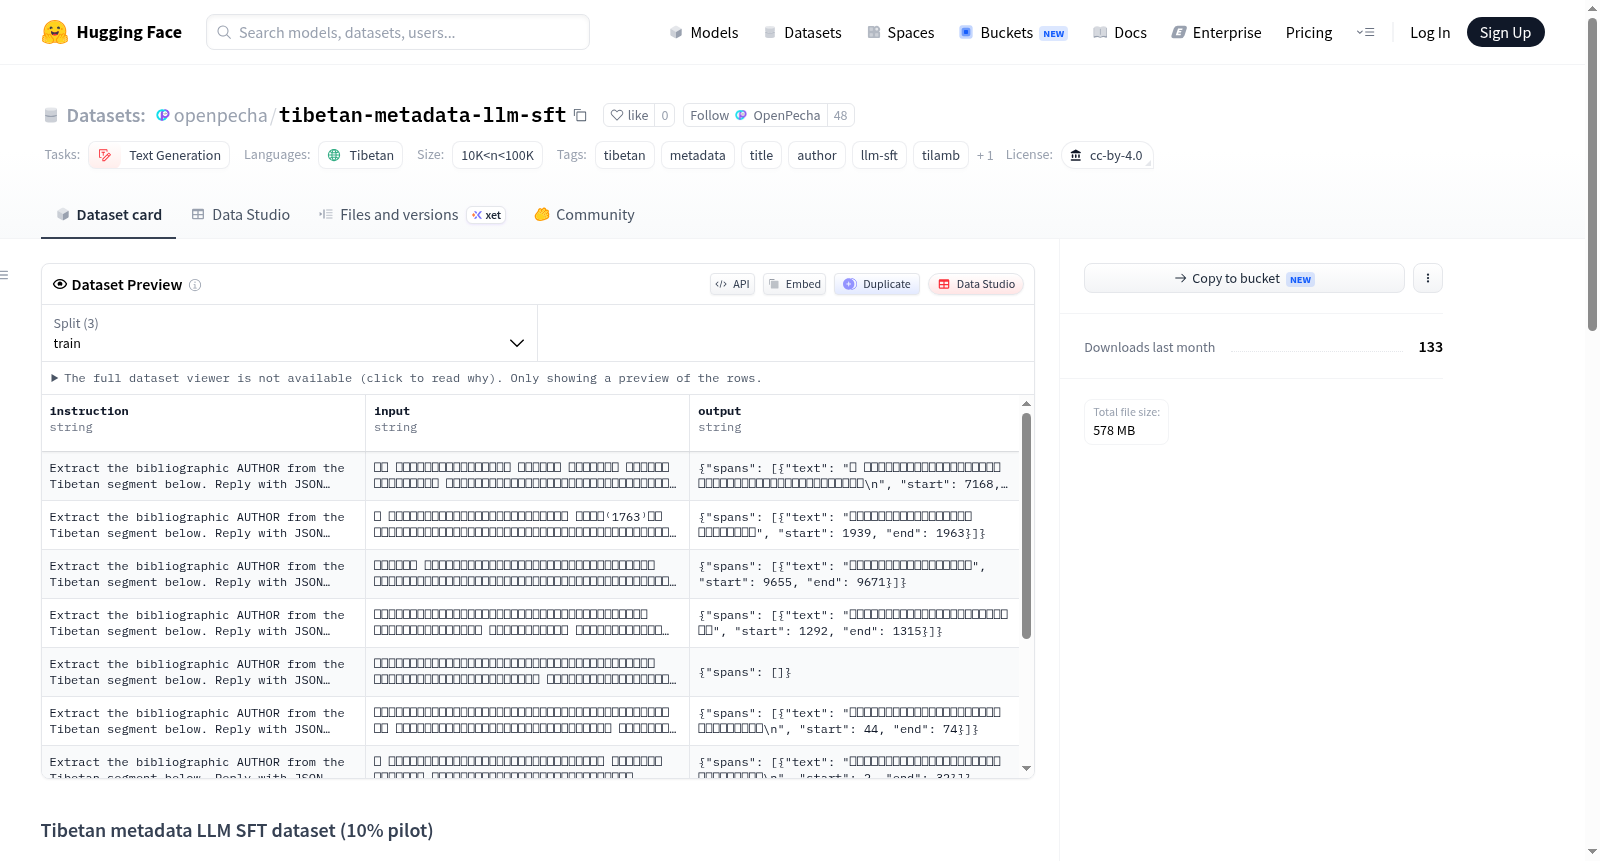
这是一个藏文元数据LLM监督微调数据集(10%试点版本),是完整TiLamb SFT JSONL的10%分层随机子样本,用于试点LoRA训练和冒烟测试。该数据集用于从BDRC大纲段中提取标题和作者范围的监督微调,专为TiLamb-7B模型设计。数据集包含title和author的训练、验证和测试文件,每个训练行包括固定的任务提示(标题或作者)、裁剪后的段文本(通过TiLamb分词器限制在≤3584个标记内)以及输出JSON格式的跨度信息(包含文本、起始和结束位置,相对于裁剪后的偏移)。子采样方法为每个分割文件随机抽取10%的行(种子42)。裁剪策略分为三种:完整(整个段适合标记预算)、正例(包含黄金跨度的随机窗口,以抗位置偏差)和负例(随机窗口,该任务为空跨度)。数据集基于ganga4364/tibetan-metadata-extracted构建,使用OpenPecha/tibetan-text-meta-detection的llm_sft包开发。

This is a Tibetan metadata LLM supervised fine-tuning (SFT) dataset (10% pilot version), which is a 10% stratified random subsample of the complete TiLamb SFT JSONL, intended for pilot LoRA training and smoke testing. This dataset is designed for supervised fine-tuning to extract titles and author ranges from BDRC outline segments, and is specifically developed for the TiLamb-7B model. The dataset includes training, validation, and test files for title and author extraction tasks. Each training line contains a fixed task prompt (for title or author), cropped segment text limited to ≤3584 tokens via the TiLamb tokenizer, and output JSON-formatted span information, which includes the text, start and end positions relative to the cropped offset. The subsampling method is to randomly select 10% of lines from each split file with a random seed of 42. The cropping strategies are divided into three types: full (the entire segment fits within the token budget), positive example (a random window containing the gold span to mitigate position bias), and negative example (a random window where the task has no valid span). This dataset is built upon ganga4364/tibetan-metadata-extracted, and developed using the llm_sft package from OpenPecha/tibetan-text-meta-detection.
提供机构:
openpecha
搜集汇总
数据集介绍
openpecha/tibetan-metadata-llm-sft 数据集图片
构建方式
该数据集源自TiLamb项目的完整监督微调语料库,通过分层随机抽样方法获取其中的10%作为试点子集,以用于初步的LoRA训练与烟雾测试。数据构建基于BDRC大纲片段中的标题与作者信息提取任务,每个训练样本涵盖固定的任务提示、裁剪后的文本输入以及以JSON格式呈现的实体跨度标注。数据集按任务类型划分为标题与作者两大类别,并细分为训练、验证与测试三组文件,辅以元数据文件与注册配置文件,便于集成至LLaMA-Factory框架中使用。
特点
该数据集显著的特点在于其明确的实体识别导向,专注于藏文元数据中标题与作者字段的提取。数据样本经过精心裁剪,确保在TiLamb分词器下token预算不超过3584,从而兼容大规模语言模型的输入限制。引入位置随机化策略,包括全片段、正例窗口与负例窗口三种裁剪方式,有效缓解模型训练中的位置偏差问题。该数据集的构建脚本与完整版本均公开可查,支持复现与扩展实验。
使用方法
该数据集预设采用Alpaca格式,可直接用于基于LLaMA-Factory的监督微调流程。用户将JSONL文件分别配准至指令、输入与输出字段,并借助dataset_info.json实现数据集注册。适用于针对藏文文本的序列标注与信息抽取任务,特别适配TiLamb-7B等基于大语言模型的实体识别模型。建议在完整版数据集上进行正式训练前,利用此试点子集快速验证训练管线的稳定性与模型收敛效果。
背景与挑战
背景概述
在藏文自然语言处理领域,元数据抽取作为文献数字化与知识组织的基础任务,对古籍整理、智慧图书馆建设具有关键作用。该数据集由OpenPecha团队与研究人员YoLo2000等合作创建,旨在解决藏文典籍元数据(如标题、作者)的自动抽取问题。基于BDRC(佛教数字资源中心)的文献分段数据,数据集以Alpaca格式构建了监督微调数据,用于训练TiLamb-7B等大语言模型。其发布为藏文信息抽取研究提供了标准化基准,推动了低资源语言大模型在文化传承中的应用,对藏文自然语言处理领域具有开创性意义。
当前挑战
该数据集主要面临双重挑战:领域问题层面,藏文典籍文本结构复杂、缺乏统一标点符号,且元数据分布稀疏,传统方法难以精准定位标题与作者片段;构建过程中,需在有限token预算(≤3584)下对长文本进行智能裁剪,通过随机窗口采样(正例保留金标准、负例制造空输出)来缓解位置偏差,同时保持10%分层随机子样本的统计代表性,确保模型在pilot测试中的有效性。
常用场景
经典使用场景
在藏文自然语言处理领域,该数据集作为元数据提取任务的监督式微调数据,被广泛用于训练大型语言模型从藏文文本段落中精准抽取标题与作者信息。其经典用法基于Alpaca指令格式,通过构建固定任务提示(如'提取标题'或'提取作者'),结合裁剪后的文本片段输入,驱动模型输出包含起止偏移和文本内容的JSON结构跨度标注。这种设计不仅支持LLaMA-Factory等主流微调框架的即插即用,还通过正负样本裁剪策略(如随机窗口包含目标跨度或生成空跨度)有效缓解了模型的位置偏差问题,为藏文古籍文献的结构化信息抽取提供了标准化训练范式。
解决学术问题
该数据集精准回应了藏文自然语言处理中标注语料匮乏与元数据提取困难的长期学术挑战。传统上,藏文文献的标题、作者等关键元数据多依赖于专家人工标注,效率低下且难以规模化。通过提供10%分层随机子样本的监督式微调数据,该数据集使研究者能够在资源受限场景下验证模型可行性、进行LoRA轻量级训练与快速实验迭代。其核心价值在于为低资源语言构建了一套从标注构建、数据裁剪到模型微调的系统性解决方案,推动了藏文古籍智能化处理的研究进程,显著降低了藏文元数据自动提取任务的门槛。
衍生相关工作
基于该数据集衍生出的经典工作主要包括TiLamb-7B模型的训练与评估,这是一款专门针对藏文元数据抽取任务优化的大型语言模型,代表了该领域的代表性成果。此外,配套的tibetan-metadata-extracted数据集及其完整版本为后续研究提供了可复现的基准资源。在方法论层面,相关工作还包括针对藏文文本的分段裁剪算法与跨数据集迁移学习策略的探索,这些工作不仅验证了监督式微调在低资源语言上的有效性,还进一步衍生出面向藏文文本的信息抽取评测标准及模型优化框架,形成了从数据构建、模型训练到应用部署的完整技术链条。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

